

서 론
본 론
석회석 시추코어 자료 현황
적용성 검토 및 베이스라인 모델 선정
이미지 특성 추출 확보를 위한 백본 모델 사전학습
영역분할 모델 및 품위회귀 모델 전이학습
품위회귀 모델 성능 향상을 위한 자료증강 및 Huber 손실함수 도입
품위회귀 모델의 활용성 검토
결론 및 향후 계획
서 론
한국광해광업공단(Korea Mine Rehabilitation and Mineral Resources Corporation, KOMIR)의 국가광물정보센터에서 보유하고 있는 국내 석회석 광산의 시추코어에 대한 품위 자료는 광체 구간을 대상으로 칩샘플(chip sample, 시료 채취 구간은 평균 10 m 임) 실험실 분석을 통해 관리되어 왔으며, 최근 다기능 분석기(Multi-Sensor Core Logger, MSCL) 도입을 통해 시추코어 이미지 25 cm 간격으로 X-선 형광분석(X-ray Fluorescence, XRF)을 수행하는 방법이 적용되고 있다. 칩샘플을 이용한 품위 분석 방법은 광체의 전반적 품위 특성 파악에 활용되고 있으며, 상세 정보 확보가 요구되는 경우 다기능 분석기를 활용하여 고해상도 연속 XRF 측정 자료 확보가 가능해졌다. 그러나 시간과 비용의 제약으로 인해 전체 보유 시추코어에 일괄적으로 적용하기에는 현실적 한계가 있어 목적에 따라 선별된 시추코어를 대상으로 적용되고 있다.
KOMIR 국가광물정보센터는 2024년 기준 약 239,000 m(47,800개 박스)에 달하는 방대한 시추코어 디지털 이미지 데이터베이스(Data Base, DB)를 보유하고 있다. 이와 더불어 기존의 평균 10 m 간격 칩샘플 분석 DB 및 다기능 분석기를 이용한 고해상도 XRF 분석 DB가 지속적으로 축적되고 있다. 이러한 방대한 자료를 기존 기술과 장비로 분석하기에는 상당한 시간과 비용이 요구되었으나, 최근 인공지능(Artificial Intelligence, AI) 딥러닝 기술의 발전에 따라 충분한 자료가 확보되었을 때 다양한 형태의 정량적 정보를 신속하게 예측할 수 있는 환경이 조성되고 있다.
시추코어 이미지에 기계학습을 적용한 연구는 최근 급격히 증가하고 있으며, Gunther et al.(2025)은 이를 암상 예측, 지반공학적 분석, 광물학적 예측의 세 과제로 구분하여 검토하였다. 암상 분류 분야에서는 합성곱 신경망(Convolutional Neural Network, CNN)과 전이학습을 이용한 코어 이미지 분류가 높은 정확도를 보이는 것으로 보고되었고(Alzubaidi et al., 2021; Fu et al., 2022), 지반공학 분야에서는 코어 박스 이미지에서 온전한 코어, 파쇄 코어, 빈 박스 영역 및 비암석 물체를 CNN으로 구분하여 암질지수(Rock Quality Designation, RQD)를 자동 산정하는 연구가 수행되었다(Alzubaidi et al., 2022; Zhang et al., 2024). 반면 광물 함량이나 품위의 정량 예측은 초분광 또는 μXRF 코어 스캔 자료를 입력으로 하는 경우가 대부분이며(Acosta et al., 2019; Barker et al., 2021; De La Rosa et al., 2021), RGB 이미지만을 사용한 품위회귀 모델 연구는 단일 시추공 코어 이미지에서 전이학습으로 탄산염·점토·규산염 함량을 예측한 Boiger et al.(2024)의 사례 정도로 제한적이다. 특히 수만 장 규모의 미라벨 이미지와 소량의 이질 해상도 품위 라벨을 함께 활용하는 학습 전략과, 영역분할과 품위회귀를 통합한 파이프라인은 아직 제시된 바가 없다.
시추코어 스캔 이미지로부터 정량적 광체 품위를 예측하기 위해서는 두 가지 기술적 과제가 존재한다. 첫째, 이미지 내에 존재하는 코어박스 프레임, 심도 표시 말목, 튜브(코어 로스 구간 표시물) 등 품위와 무관한 비코어 영역을 픽셀 단위로 구분하는 영역분할(semantic segmentation) 기술이 선행되어야 한다. 두 번째로는 암석 표면의 입도, 질감, 색상 등 광학적 특성을 추상화하여 연속적인 품위로 변환하는 품위회귀(grade regression) 기술이 구현되어야 한다. 추가로, 이 연구에 활용된 22,000장 이상의 시추코어 이미지 중 라벨이 부여된 자료는 일부에 불과하므로 미라벨 이미지를 활용하여 두 과제에 공통으로 필요한 이미지 특성 추출 능력을 확보하는 사전학습 전략이 요구된다.
이 연구에서는 KOMIR 국가광물정보센터의 보유 자료 중 석회석 및 백운석 광산의 587개 시추공(약 22,000개 코어 박스) 데이터를 활용하여 AI 기반 석회석 품위 예측 시스템의 단계적 고도화 과정을 수행하였다. 연구 개발 과정은 활용 자료의 현황 분석으로부터 시작하였으며, 후보 모델에 대한 적용성 검토, 최적 베이스라인 모델 선정, 라벨이 없는 대규모 자료 활용 방안 도출, 이미지 특성 추출 모델 사전학습, 영역분할 및 품위회귀 모델 전이학습, 자료증강과 손실함수 개선을 통한 모델 고도화의 순서로 진행되었다. 초기 연구 단계에서는 공간 좌표 정보를 결합한 통합 Two-Stream Auto-encoder 사전학습 모델을 두 과제의 전이학습에 공통으로 사용하는 전략을 채택하였으나, 연구 과정에서 영역분할 모델과 품위회귀 모델 간에 요구되는 이미지 특성이 상충함을 확인하고 품위회귀 전용 사전학습 모델을 분리하는 전략으로 수정하였다. 본문에서는 이러한 시행착오를 포함한 고도화 과정을 연구 진행 순서로 기술하고, 각 단계에서 확인된 설계 원칙을 결론에서 정리하였다.
본 론
석회석 시추코어 자료 현황
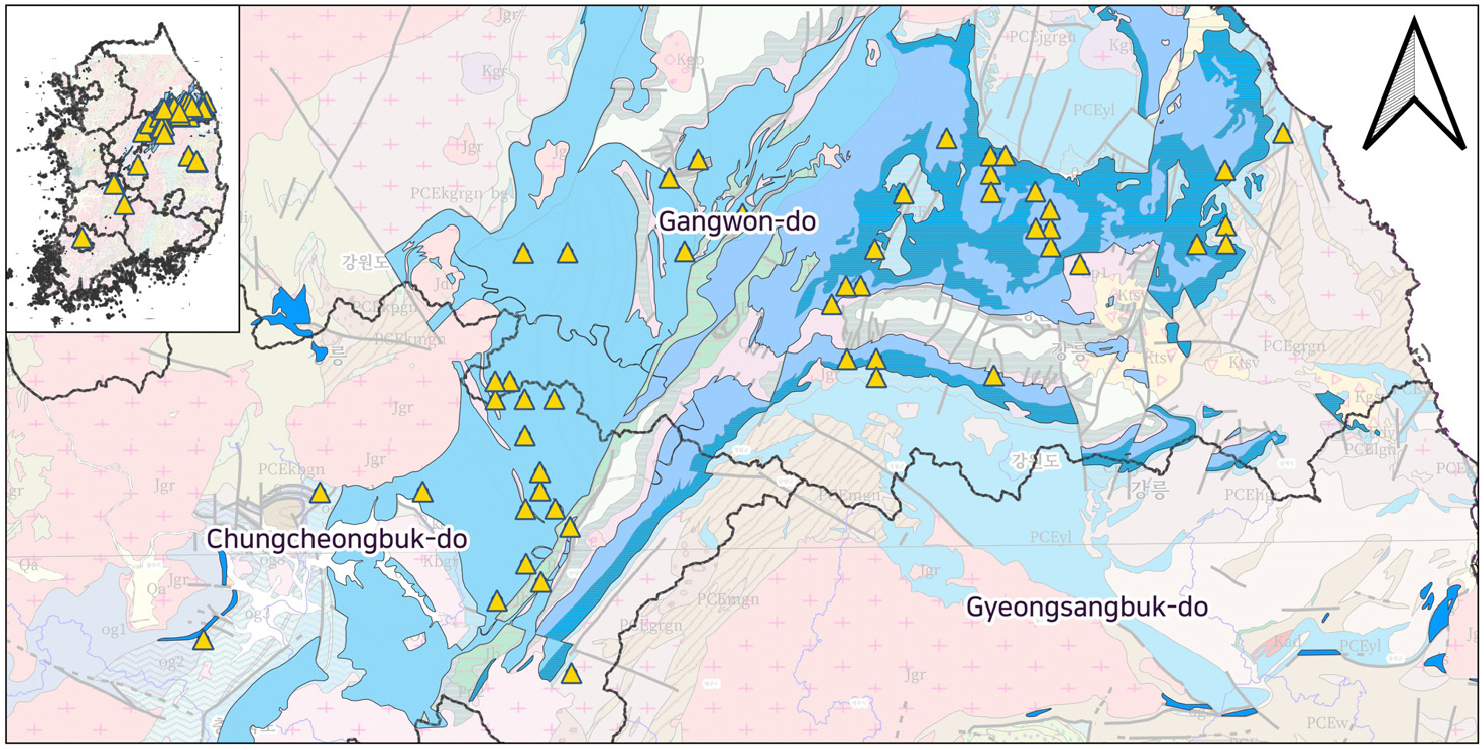
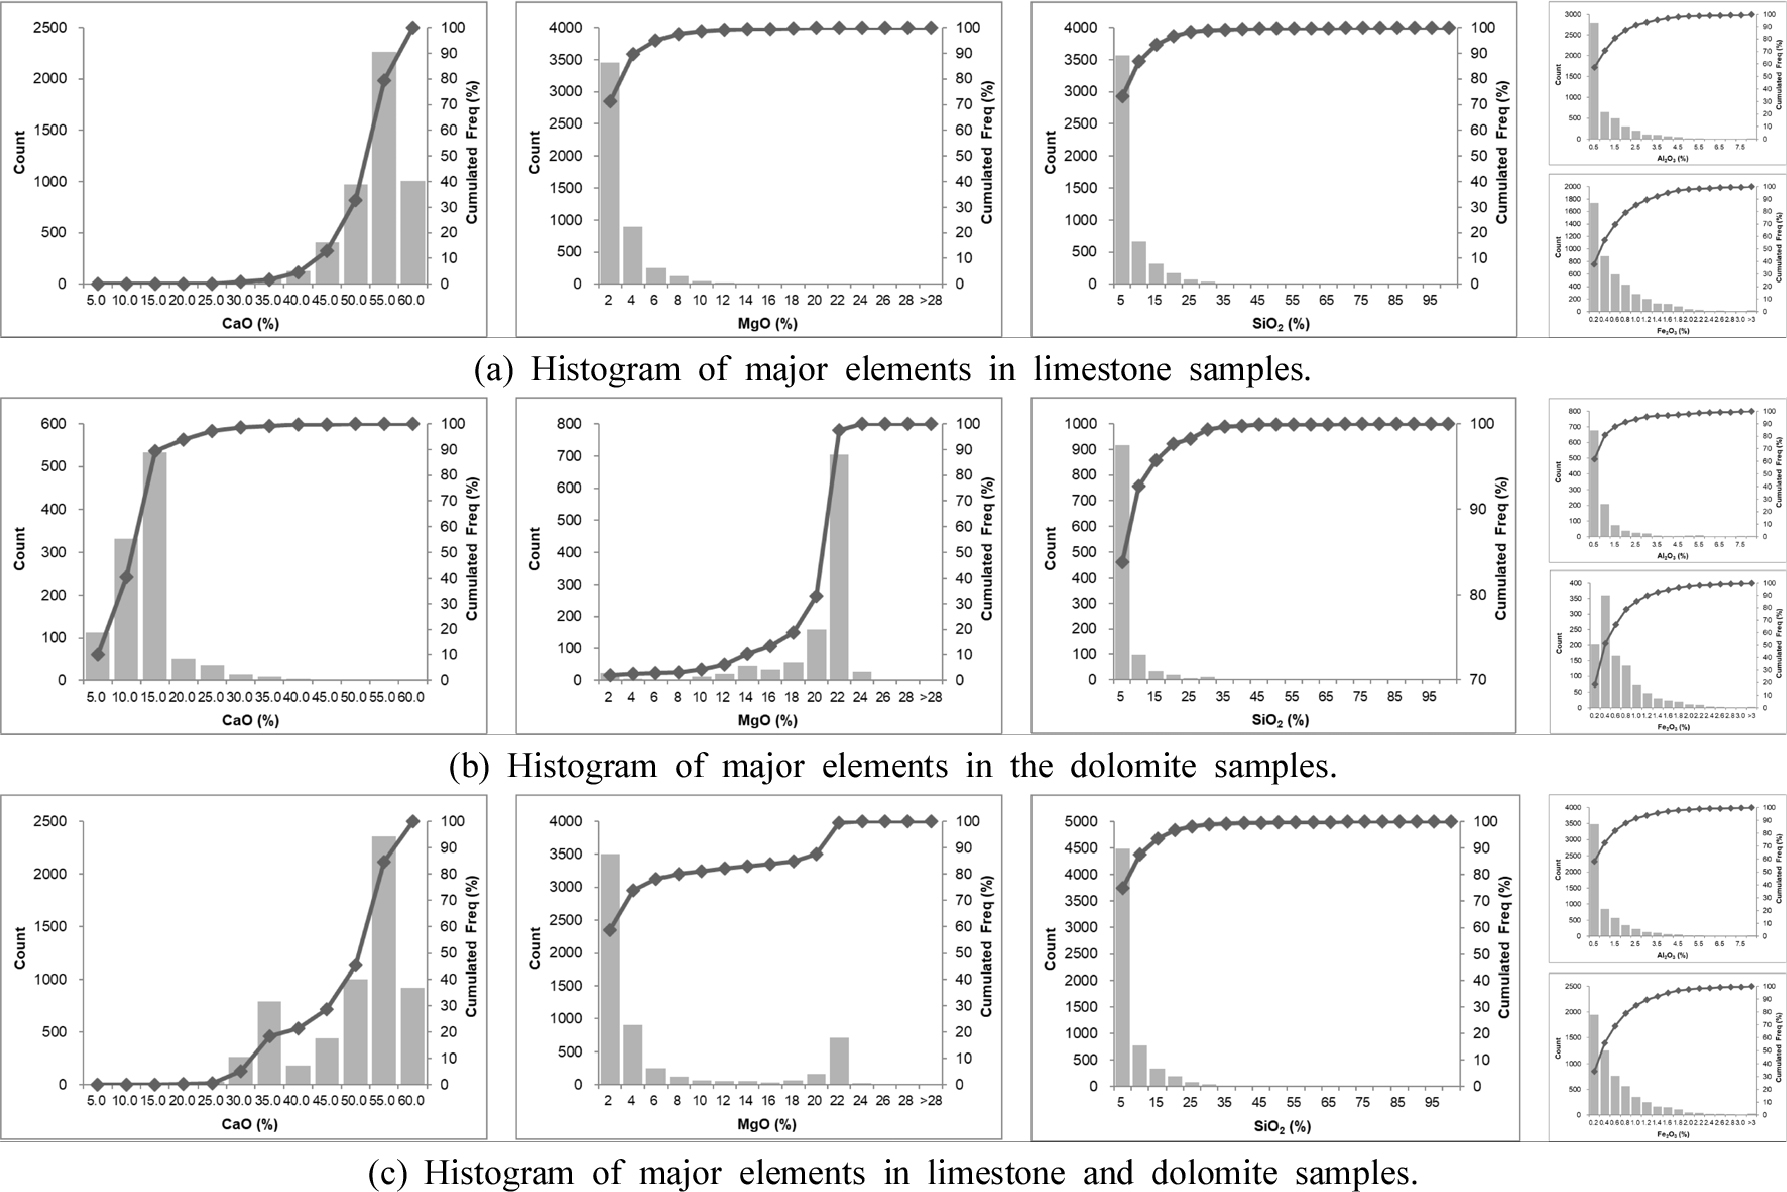
한국광해광업공단 국가광물정보센터가 보유하고 있는 자료 중 석회석 및 백운석 광산에서 수집한 시추 연장 약 110,000 m에 해당하는 시추코어 박스 약 22,000개에 대한 이미지와 5,993개의 칩샘플 시료 분석 자료 및 다기능 분석기를 이용한 7,545개의 XRF 분석 자료를 학습 자료로 사용하였다. Fig. 1은 이 연구에 사용된 시추코어가 수집된 광산의 위치를 표시한 것으로, 대부분 강원도와 충청북도에 집중되어 있다. 칩샘플 시료 분석은 평균 10 m 구간의 코어에 대하여 수행되었으며, 일부 시추공은 전체 광체 구간의 시추코어를 1 m 간격으로 시료 분석이 수행된 경우도 포함되어 있다. Fig. 2는 학습을 위해 제공된 시료 분석 결과에 대한 통계 특성을 석회석과 백운석으로 구분하여 도시한 것으로 암종에 따라 뚜렷한 통계 특성 차이를 확인할 수 있다. 이 연구에서는 석회석에 대한 시료 분석 결과를 선별하여 딥러닝 기반 품위 예측 모델 학습에 사용하였다.
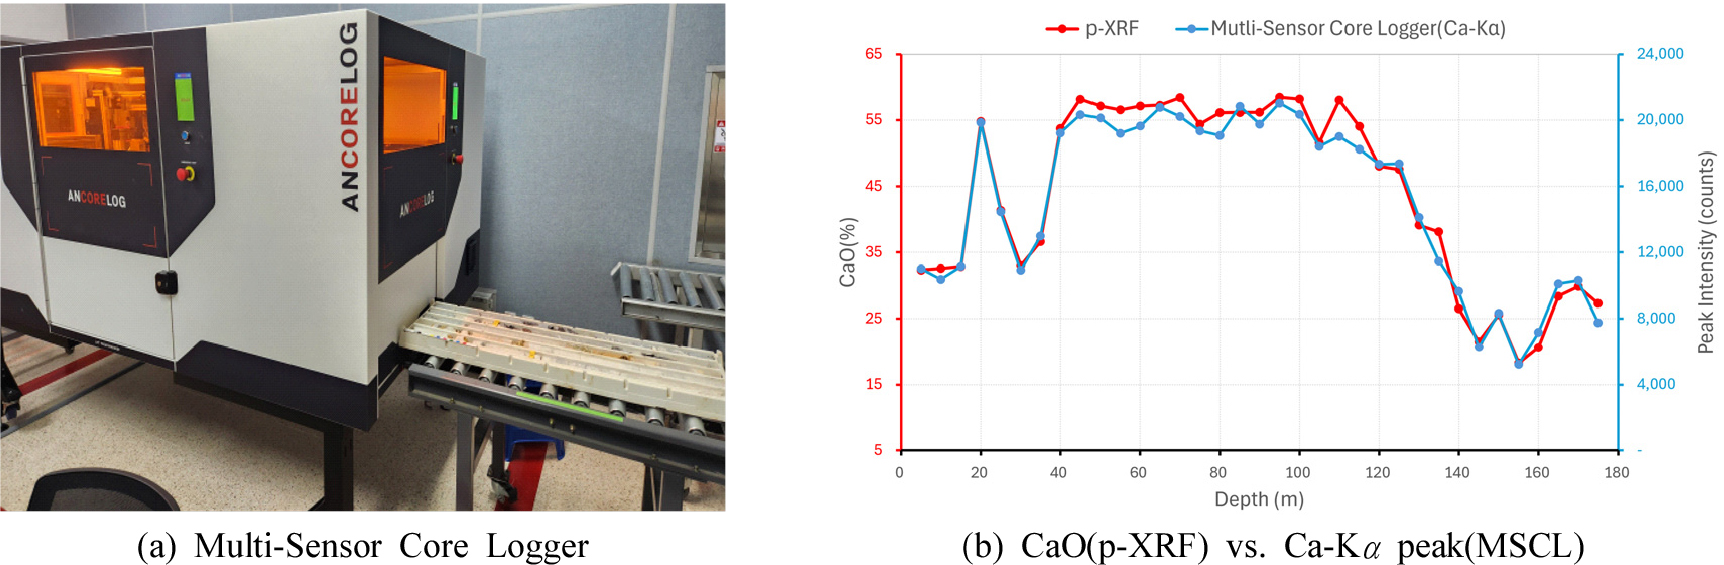
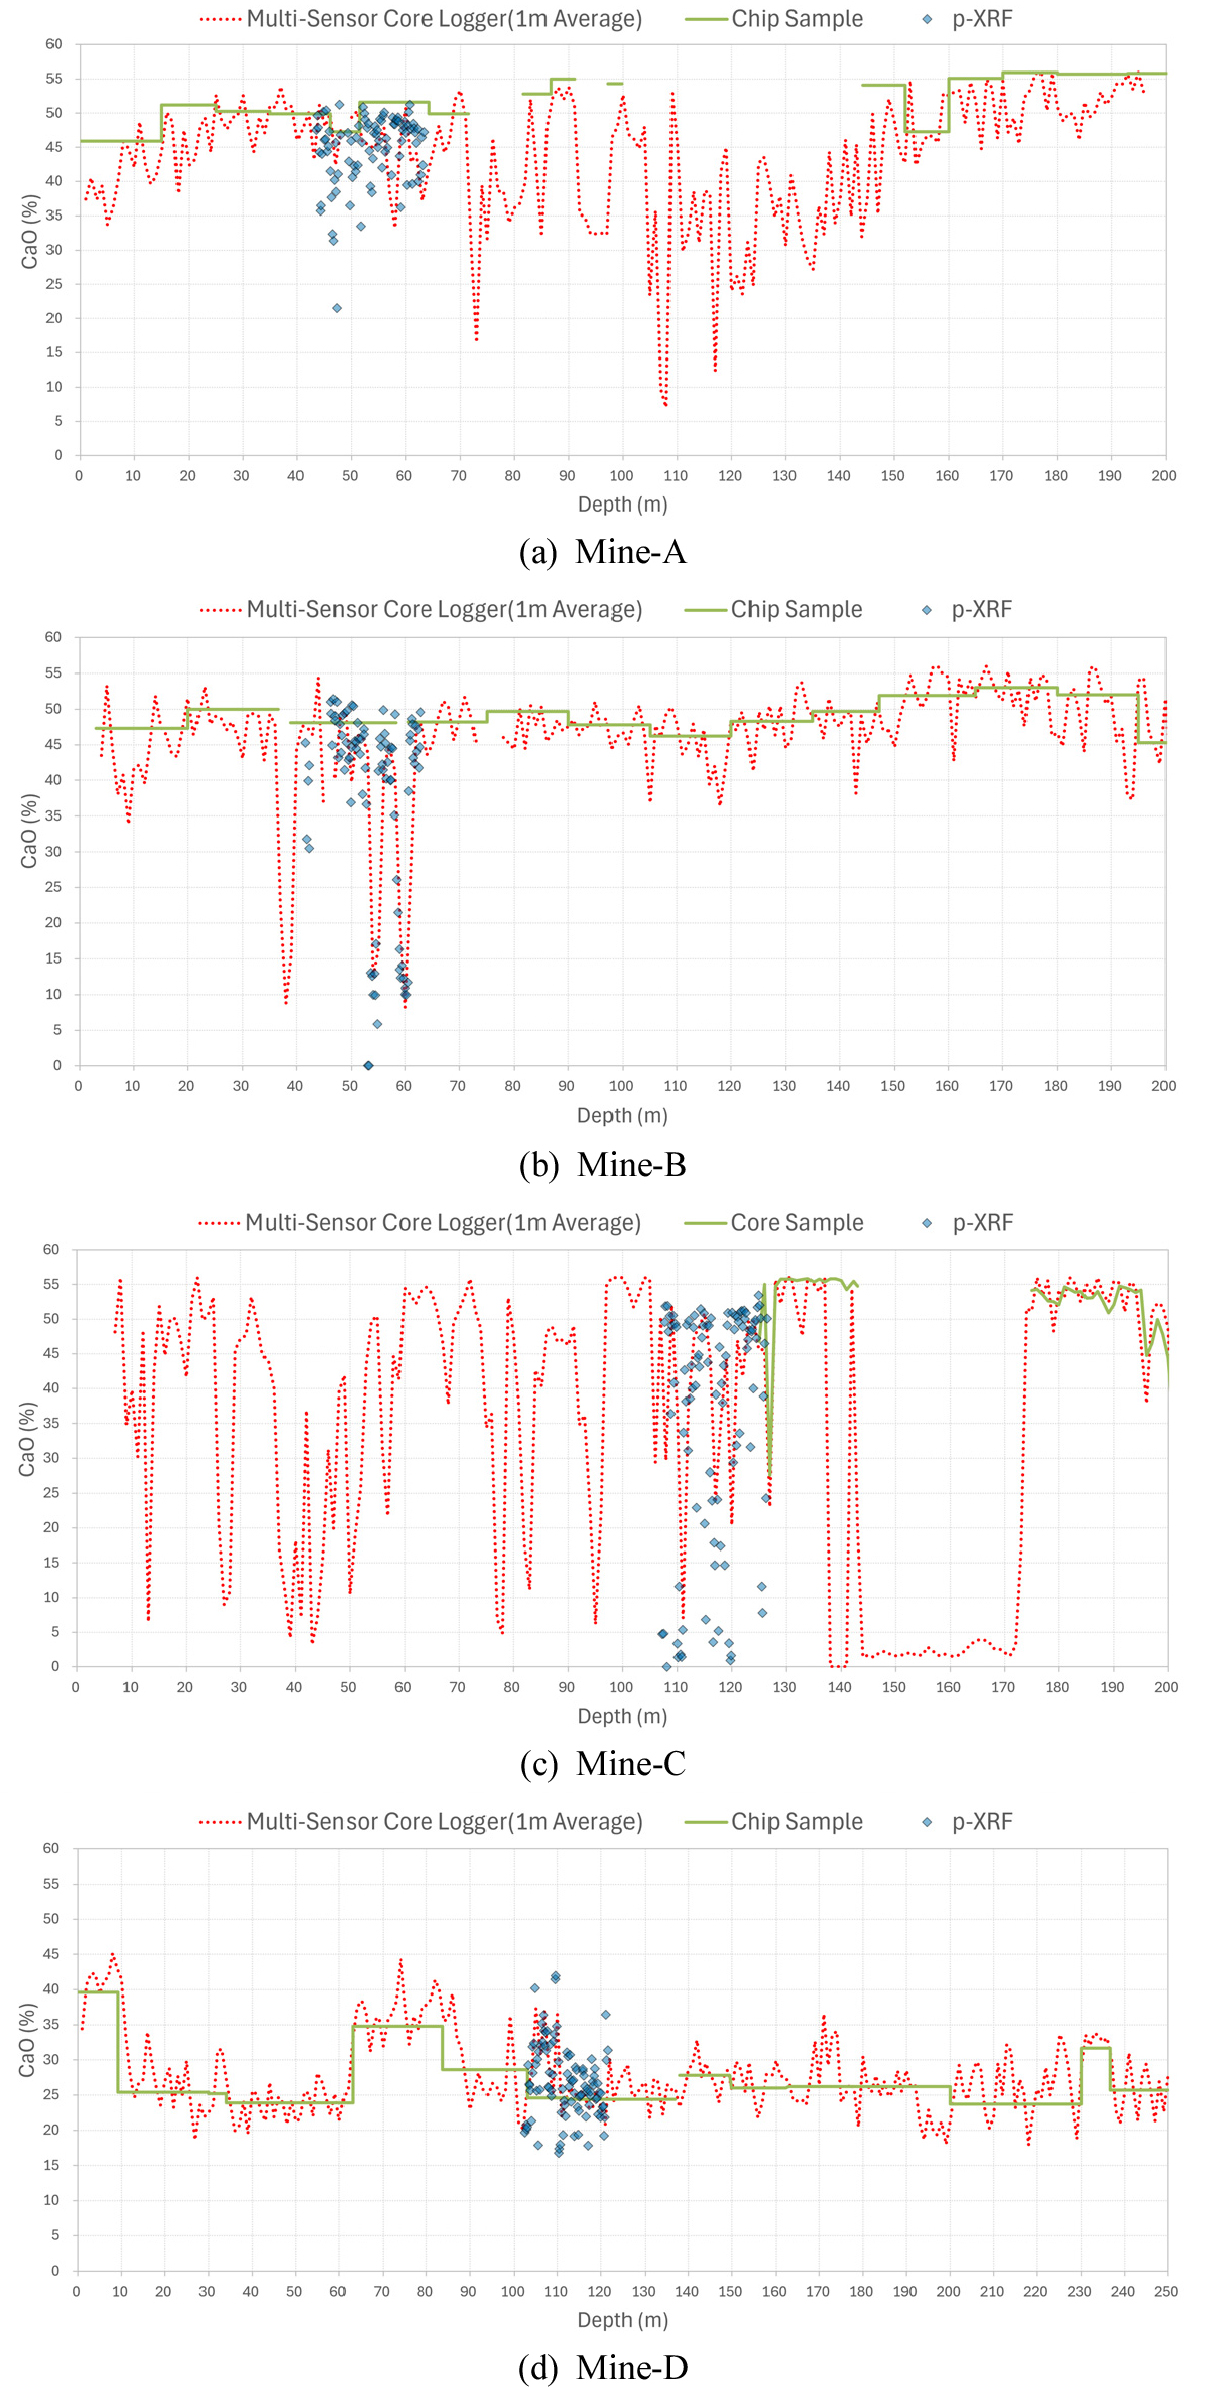
KOMIR가 보유한 시추코어 자료는 전통적인 칩샘플링 기법을 적용하여 시료 분석 자료가 관리되어 왔으나 최근 다기능 분석기 도입을 통해 시추코어에 대한 연속적 품위 분석 자료를 구축하고 있다. 연구 과정에서 석회석 품위 예측을 위한 학습 자료는 적용성 검토 단계에서는 135개 시추공에 대한 전통적 칩샘플 분석 자료를 사용하였으며, 적용성 검토 결과에 대한 분석 과정에서 시추코어 박스 2개당 하나의 칩샘플 분석 시료 자료를 적용한 품위 예측 모델은 이후 품위 분포 예측 등에 대한 활용도가 낮을 것으로 판단되어 보다 촘촘한 공간 해상도를 확보할 수 있도록 다기능 분석기를 활용한 석회석 품위 분석 자료 확보가 수행되었다. 품위회귀 모델 고도화 과정에서는 8개 시추공(시추코어 이미지 426개, 다기능 분석기 XRF 측정 자료 7,545개)에 대한 석회석 품위 분석 자료를 적용하였다. 다기능 분석기를 이용한 XRF 시료 분석은 평균 25 cm 간격에 대하여 연속적으로 측정된 결과이다. 다기능 분석기의 XRF 측정 결과는 에너지 분산형 X-ray 형광 스펙트럼이며, 측정 결과를 원소별 품위로 변환하기 위한 변환 계수(calibration factor) 산출이 필요하다. 이 연구에서는 다기능 분석기 측정 구간 일부에 휴대용 XRF 분석을 별도로 수행하고 해당 구간의 칩샘플 분석 결과와 비교함으로써 다기능 분석기 XRF 자료의 품질 검증과 변환 계수 산출에 활용하였다. 다기능 분석기의 XRF 측정은 25 cm 간격으로 연속 측정한 결과로써 25 cm 구간에 대한 평균값을 의미한다. 휴대용 XRF 측정은 20 cm 간격의 측정점에 대하여 측정한 결과로써 측정지점의 값을 의미한다. 마지막으로 칩샘플 분석 결과는 측정 대상 구간 내에서 채취한 칩샘플을 분석한 결과로써 측정 대상 구간의 평균값을 의미한다. Fig. 3은 국가광물정보센터의 다기능 분석기 운영 사진, 동일 측정 구간에 대한 다기능 분석기 XRF 자료의 Ca-K𝛼 특성 X선 강도와 표준 시료를 이용하여 변환 계수를 적용한 휴대용 XRF 기기의 CaO 측정 결과를 비교한 것으로, 절대값의 차이는 있으나 일관된 측정 결과를 보이는 것을 확인하였다. Fig. 4는 다기능 분석기 XRF 측정 구간에서의 칩샘플 분석 결과를 이용하여 도출한 변환 계수를 적용하여 CaO 품위로 변환한 결과와 휴대용 XRF 품위 분석 결과 및 칩샘플 품위 분석 결과를 동시에 도시한 그래프로써, 측정 기기별 측정 방법의 차이를 감안하면 전반적인 품위값 분포 양상이 일관적임을 확인할 수 있다.
적용성 검토 및 베이스라인 모델 선정
시추코어 이미지를 이용한 정량적 석회석 품위 예측 모델 개발을 위해 영역분할 모델과 품위회귀 모델의 베이스라인 모델을 선정하고자 각각의 모델에 대한 적용성 검토를 수행하였다. KOMIR가 제공한 전체 587개 시추공 자료 중 시추공의 지역 분포와 이미지 수량을 고려하여 선정한 42개 시추공을 적용성 검토에 활용하였다.
시추코어 이미지에 대한 영역분할 모델 적용성 검토는 U-Net, DeepLabV3+, YOLO-Seg 등 이미지 분할 성능이 높은 것으로 알려진 후보 모델을 선정하고 적용성 검토용 자료로 선정한 42개 시추공의 시추코어 이미지에 대한 영역 라벨링과 학습을 수행하였다. 영역 라벨은 코어 박스 프레임(corebox), 코어박스 내 위치별 코어(core1, core2, core3, core4, core5, core6), 심도 표시 말목(tag), 튜브(tube, 코어 로스 구간에 삽입된 스티로폼 또는 플라스틱 튜브)의 9개 클래스로 구성하였으며, 1,933장의 라벨 이미지를 작성하였다. 학습·검증·시험 데이터셋은 동일 시추공의 이미지가 모든 데이터셋에 골고루 포함되도록 8:1:1의 비율로 분할하였다. 적용성 검토 과정에 적용한 무작위 데이터셋 분할 구조는 인접한 자료가 학습·검증·시험 데이터셋에 나뉘어 포함될 가능성이 높으며 이에 따라 일반화 성능이 과대평가될 가능성을 내포하고 있다. 그러나 적용성 검토는 여러 후보 모델 중 최적의 베이스라인 모델을 선정하기 위한 탐색적 목적으로 수행되었으므로 자료 특성의 공간적 종속성을 고려하지 않았다. 따라서 적용성 검토를 통해 도출된 성능 지표는 이러한 데이터 편향 가능성에 유의하여 해석되어야 함을 밝혀 둔다.
Fig. 5는 영역분할을 위한 각 후보 모델에 대한 적용성 검토 결과를 도시한 것으로, 시추코어 이미지 만으로 구성된 경우 모든 후보 모델에서 양호한 영역분할 성능을 보여 주고 있으나 코어 손실이 발생한 구간에 인위적으로 삽입된 튜브 구간에 대한 영역분할 성능은 상대적으로 떨어지는 현상과 더불어 모델별 성능 차이도 확인된다. Table 1은 영역분할 후보 모델별 적용성 시험 결과를 정확도(Accuracy) 순서로 정렬한 것으로, U-Net 기반 영역분할 모델의 성능(valid accuracy = 95.99%, test accuracy = 95.88%)이 후보 모델 중 가장 적합한 것으로 확인되었다.
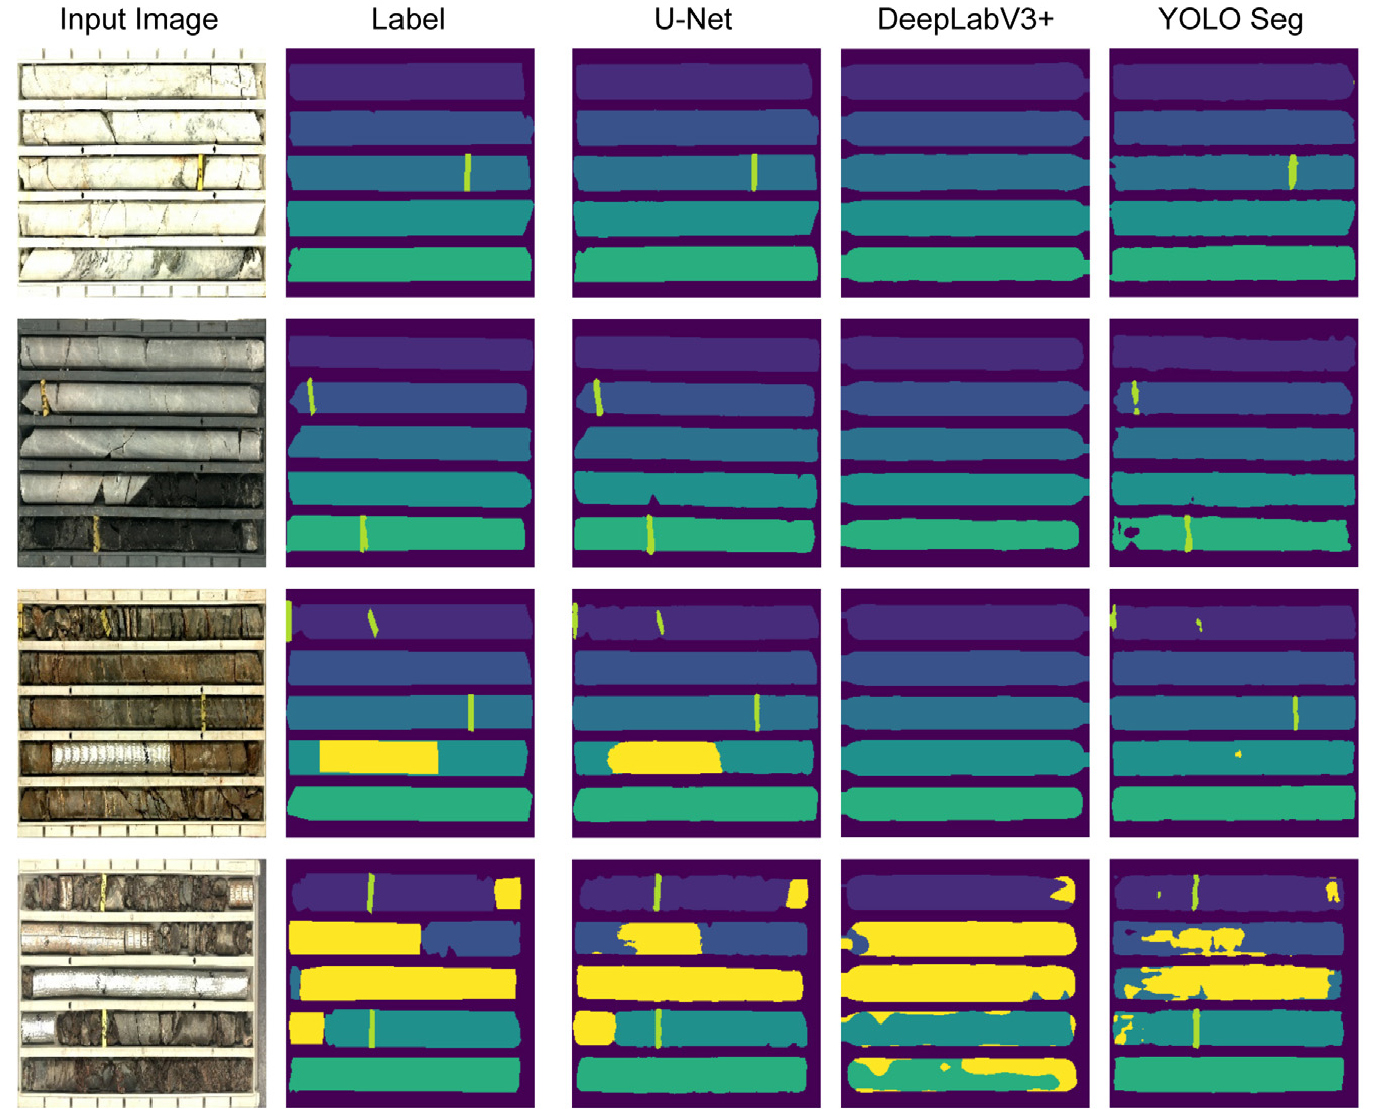
Table 1.
Comparison of the applicability test results from each segmentation model
시추코어 이미지 중 석회석 품위는 코어 박스 프레임, 심도 표시 말목 및 튜브(코어 로스 구간 표시 용도)를 제외한 코어 이미지 영역의 특성과 연관되어 있으므로, U-Net 기반 영역분할 모델을 적용하여 코어 영역을 비코어 영역과 분리하고 분리된 코어 영역의 이미지에 대하여 석회석 품위회귀 모델을 적용하도록 계획하였다. 품위회귀 모델의 적용성 검토에는 회귀(regression) 성능이 우수하다고 알려진 ResNet18, ResNet50, ResNeXt, WideResNet, ConvNext, SwinTransformer 등 6개 후보 모델을 선정하고 적용성 검토용 학습 데이터셋을 이용하여 후보 모델별 성능 비교를 수행하였다. 품위회귀 모델의 적용성 검토에는 평균 10 m 간격 칩샘플 분석 결과를 학습 자료로 사용하였다. 시추코어 박스에는 1칸에 1 m 정도의 코어가 보관되어 있으므로 1개의 코어 박스는 5 m 구간에 해당하여 10 m 간격의 칩샘플 분석 결과는 2개 정도의 코어 박스에 대응된다. 그러나 실제로 코어 박스에 보관된 시료는 코어 로스 구간이 포함되고 시료의 길이가 다양하여 개별 코어 박스 이미지에 보관된 시료의 심도 정보를 단순하게 산출하기 곤란한 상황이다. 이 연구에서는 학습용 자료의 모든 이미지에 대하여 중간에 표시된 심도 표시 말목을 기준으로 개별 코어 박스의 심도 정보를 수작업으로 정리하여 시료 분석 구간 위치 정보와 대비되도록 정리하였다. 적용성 검토 과정에서는 각 시추코어 박스 이미지 심도와 개별 칩샘플 분석 구간 위치 정보를 일대일로 대응시키고 코어 박스 심도에 해당하는 칩샘플 구간의 품위값을 비율에 따라 중률 평균하여 품위 예측 모델의 학습용 라벨로 적용하였다. 품위회귀 모델 적용성 검토에 영역분할 모델 적용성 검토에 사용하였던 시추공 42개만을 적용한 결과 ConvNeXt, SwinTransformer 등과 같이 모델 파라미터 수가 많은 모델의 경우 학습이 수행되지 않는 문제가 발생하여 적용성 검토용 자료를 135개 시추공으로 확대하였다. 품위회귀 모델 적용성 검토에는 135개 시추공의 코어박스 이미지 중 품위 분석 자료가 있는 2,421개 이미지를 사용하였으며, 학습·검증·시험 데이터셋은 동일 시추공의 이미지가 모든 데이터셋에 골고루 포함되도록 8:1:1의 비율로 분할하여 적용하였다. 영역분할 모델의 적용성 검토에서 언급한 바와 같이 최적 베이스라인 모델 선정을 위한 탐색적 목적을 고려하여 이와 같은 무작위 분할 데이터셋 구조를 적용하였다. 적용성 검토 실험은 각 후보 모델별로 학습 데이터셋 수량 변경, 하이퍼파라미터 변경 등 다양한 조건에서 총 190회의 실험을 수행하였다. 적용성 검토는 각 모델별로 최소 27회 이상 수행하였으며, CaO 품위값에 대한 validation R2-score를 기준으로 성능을 비교하였다. 모델의 성능 지표를 평가하는데 있어서 검증 데이터셋은 모델 학습에 대한 편향성을 포함하므로 최종 모델의 일반화 성능을 온전히 대표한다고 보기 어렵다. 그러나 품위회귀 모델의 최적 베이스라인 모델을 선정하는 적용성 검토의 목적에 집중하여 이 적용성 검토 단계에서는 validation 성능 지표만을 활용하였다. 후보 모델 간의 공정한 성능 비교를 위해, 모든 모델에 동일한 학습 데이터셋(135개 시추공, 2,421개 이미지)과 고정된 기본 하이퍼파라미터(학습률, 배치 크기 등)를 적용한 통제 조건 실험을 우선적으로 수행하였다. 이 선행 시험 결과, ConvNeXt나 SwinTransformer와 같이 파라미터 수가 많은 대규모 모델들은 동일 조건임에도 불구하고 검증 손실이 조기에 발산하거나 과적합되는 경향이 뚜렷하게 관찰되었다. Table 2에서 모델별 시도 횟수가 서로 다른 이유는, 앞선 통제 조건에서 학습이 불안정했던 대규모 모델들의 학습 과정을 안정화하여 각 모델이 낼 수 있는 최대 성능을 확인하기 위해, 모델별로 데이터셋 수량 조절과 하이퍼파라미터(학습률, 가중치 감소 등)를 다양하게 변경하며 추가적인 최적화 탐색을 수행했기 때문이다. 이러한 개별 최적화 과정을 포함하여 총 190회의 실험을 수행하였다.
Table 2.
Comparison of the applicability test results from each regression model
Table 2의 “within Rank 10%”는 190회 실험 전체를 validation R2-score 순으로 정렬했을 때 상위 10%(19회)에 포함된 해당 모델의 실험 횟수이며, Average score는 학습이 수렴하지 않은 실험을 포함한 모든 실험의 평균이므로 절대값보다는 모델 간 상대 비교의 지표로 해석하여야 한다. 적용성 시험 결과 ResNet18, ResNet50, ResNeXt 등 ResNet 계열의 모델 성능 지표가 상위 10% 순위를 차지하였다. ImageNet 사전학습 가중치를 활용하는 전이학습 조건에서 파라미터 수가 상대적으로 적은 ResNet 계열이 우수한 성능을 보인 것은, 수천 건 수준의 제한된 라벨 자료에서는 대규모 모델이 과적합 되기 쉽다는 점을 시사한다. 적용성 검토 과정에서 각 모델에 최적화된 하이퍼파라미터를 적용하기 위해 시도 횟수를 늘려가며 조건을 변경하였음에도 불구하고, 파라미터 수가 상대적으로 적은 ResNet 계열(ResNet18, ResNet50)이 최상위 성능 지표(Table 2의 within Rank 10% 다수 차지)를 달성하였다. 이는 본 연구와 같이 확보된 라벨 자료가 수천 건 수준으로 제한된 환경에서는 대규모 모델의 파라미터를 미세조정(Fine-tuning)하기에 데이터가 부족하여 과적합이 발생하기 쉬우며, 오히려 모델 복잡도가 적절한 ResNet 계열이 안정적인 학습과 우수한 일반화 성능을 확보하는 데 유리하다는 점을 강력히 뒷받침한다.
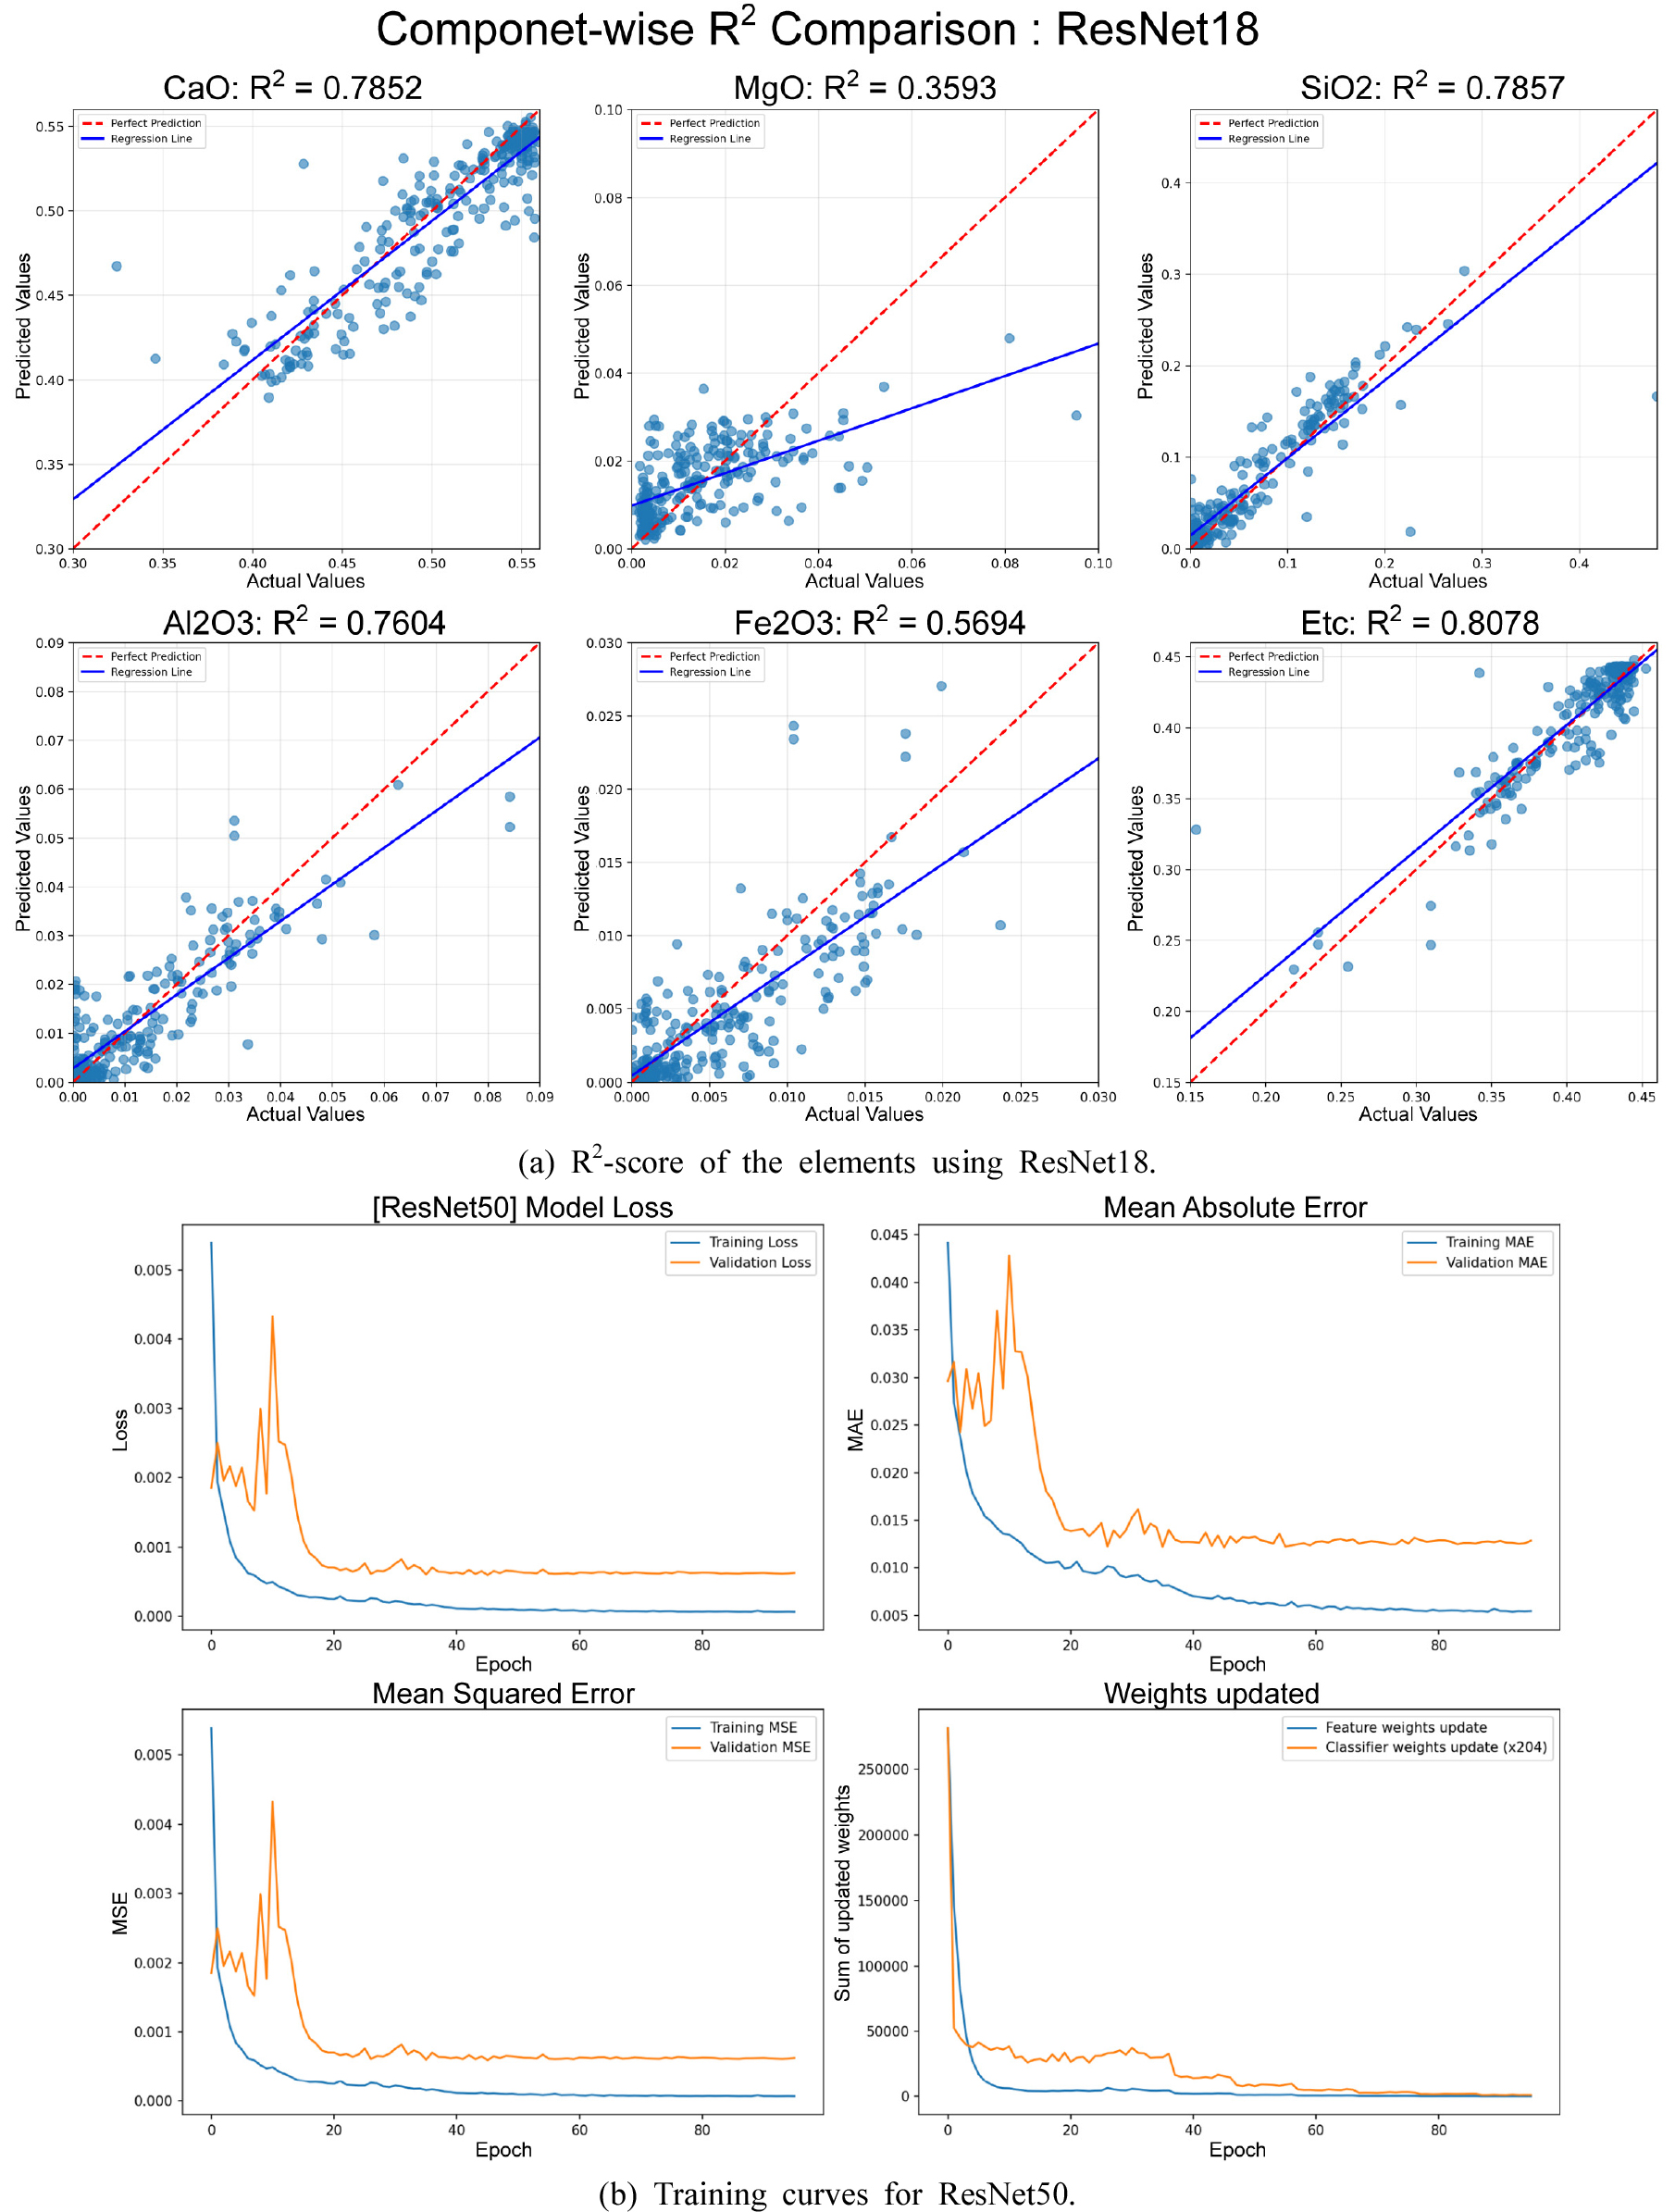
Table 2에 품위 예측 모델의 적용성 검토 결과를 정리하였으며, Fig. 6에는 가장 양호한 성능을 보인 ResNet18 모델의 성분별 R2-score와 ResNet50 모델의 성능 지표별 학습 곡선을 도시하였다. Fig. 6(a)에서 CaO의 validation R2-score(0.7852)에 비해 MgO, SiO₂등 부성분의 validation R2-score가 낮게 나타나는데, 이는 석회석 시료에서 부성분의 함량 범위가 좁아 이미지 특성과의 상관이 약하기 때문으로 판단된다. 또한 Fig. 6(a)의 ResNet18 모델 CaO 예측 산점도를 살펴보면, 실제값과 예측값의 차이가 커서 그래프에서 멀리 떨어진 오차 데이터들의 분포 특성을 확인할 수 있다. 데이터가 집중된 45~55%의 구간에서는 상대적으로 예측이 정확한 반면, 저품위 구간에서는 모델이 실제보다 품위를 높게 예측(과대평가)하고 고품위 구간에서는 낮게 예측(과소평가)하는 전형적인 평균 회귀(regression to the mean) 편향 특성이 관찰되었다. 이러한 오차는 학습 데이터셋의 극심한 클래스 불균형(class imbalance)에 기인한 것으로 판단된다. 앞서 Fig. 2의 석회석 시료 통계 특성에서 나타나듯 확보된 시료의 절대다수가 특정 고품위(약 50% 내외)에 편중되어 있어, 딥러닝 모델이 다수 클래스의 평균적인 이미지 질감에 학습이 최적화되고 소수 클래스인 저품위 및 이상치 대역의 특성을 충분히 학습하지 못한 것으로 해석된다. Fig. 6(b)의 학습 곡선에서는 학습 초기에 validation metrics가 급격히 상승되었다가 안정화되는 현상이 확인되며 epoch 25 이후에는 validation metrics의 개선이 중단되는 양상을 확인할 수 있다. 이와 같이 학습 과정에서 일반화가 수행되고 향상되는 것을 통해 시추코어 이미지를 이용한 품위 예측 학습 가능성을 확인하였다. 적용성 검토 과정에서 확인한 베이스라인 모델의 한계를 극복하고 모델의 예측 성능을 실질적으로 향상시키기 위해서는 부족한 품위 구간의 데이터를 보완할 수 있는 적절한 자료증강(Data augmentation) 기법과 이상치(Outlier) 오차에 가중치 파괴가 덜 발생하는 강건한 손실함수(Robust loss function)의 도입이 필요한 것으로 판단되었다.
이미지 특성 추출 확보를 위한 백본 모델 사전학습
시추코어 이미지 영역분할 모델 후보 3개와 품위 예측 모델 후보 6개에 대한 적용성 검토를 통해 U-Net 모델과 ResNet 모델을 각각 영역분할 모델 및 품위 예측 모델의 베이스라인 모델로 선정하였다. 학습을 위해 제공된 자료는 22,000장 이상의 방대한 이미지 자료로 구성되어 있으며, 백본 사전학습을 위한 데이터셋 분할은 이미지 자료의 공간적 종속성을 고려하여 동일한 시추공의 이미지가 학습·검증·시험 데이터셋에 분산되어 모두 포함되지 않도록 시추공을 기준으로 분할하였다. 적용성 검토를 통해 선정된 베이스모델을 기반으로 품위예측 모델을 고도화하는 단계에서는 공간적 종속성의 영향을 감소시키기 위한 학습 데이터셋 분할 구조를 적용하였다. KOMIR가 제공한 전체 시추코어 이미지 자료를 시추공별로 분류하고 각 시추공의 특성(다기능 분석기 시료 분석 적용 여부, segmentation label 적용 여부, 칩샘플 분석 자료 존재 여부 등)을 기준으로 구분하고, 각 특성별 시추공이 모든 데이터셋에 골고루 포함되도록 7:2:1의 비율로 분할하였다. Table 3은 백본 사전학습 및 이후 전이학습에 적용된 데이터셋 분할 현황을 정리한 것이다.
Table 3.
Summary of training dataset splitting
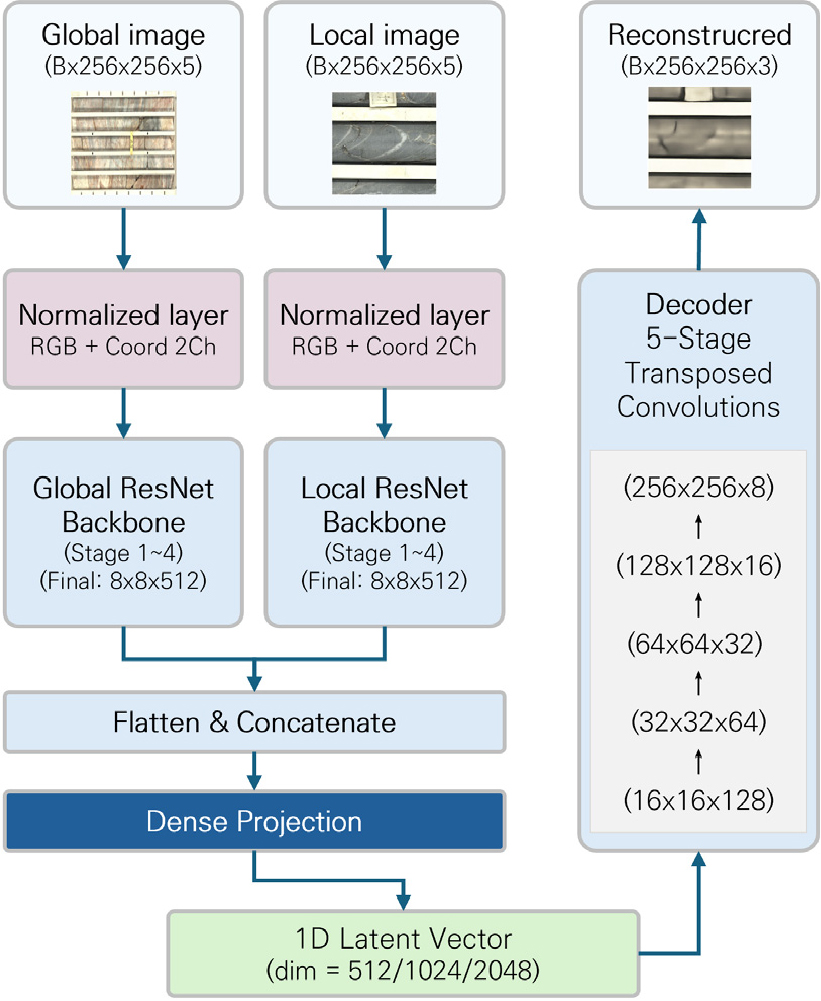
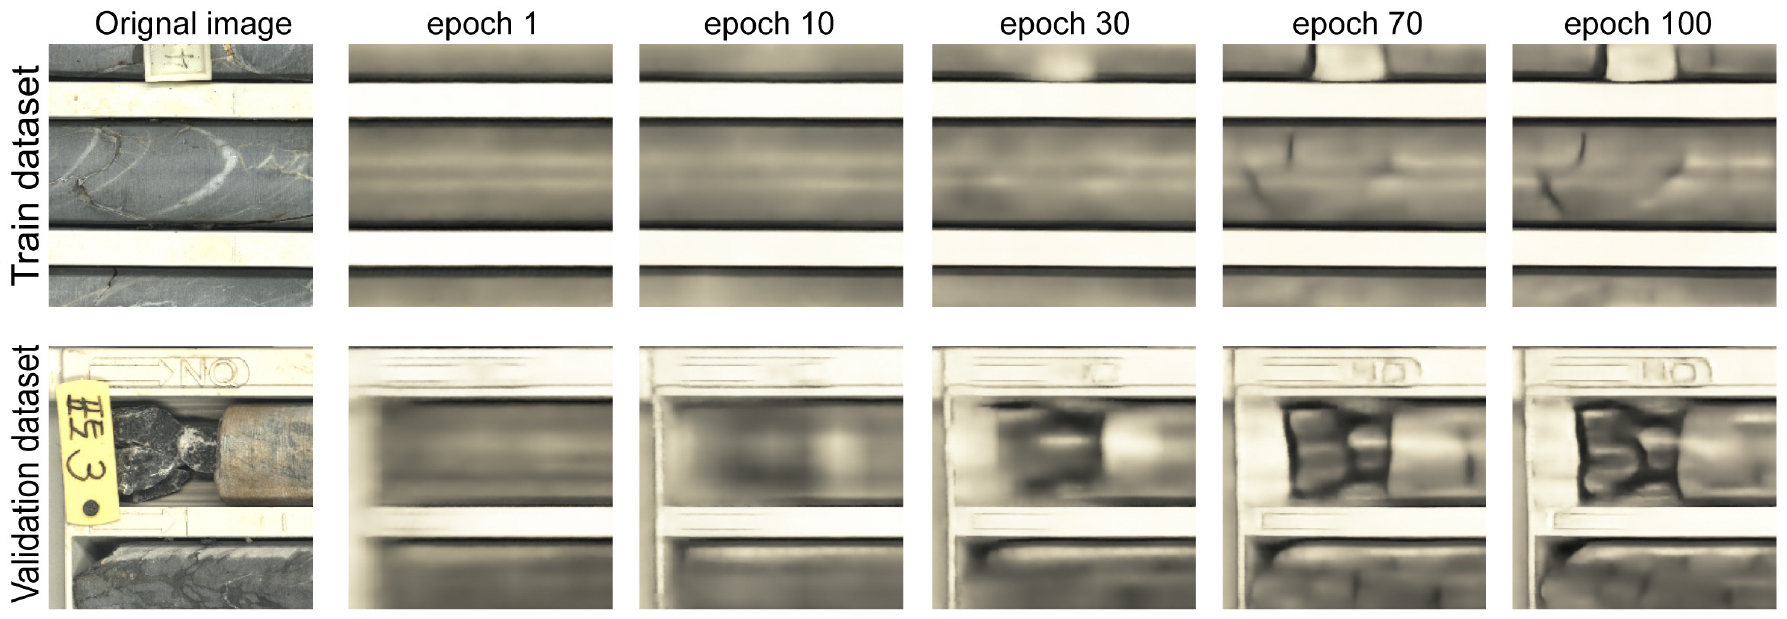
전체 자료의 방대한 이미지 수량에 비해 영역분할 모델 및 품위회귀 모델 학습에 직접 사용할 수 있는 라벨링 자료의 수는 상대적으로 빈약한 상황이다. 영역분할 라벨링은 Table 3의 MSCL analyzed와 Segmentation에 해당하는 이미지에 대하여 수행되었으며 총 1,936장으로 전체 학습 데이터셋의 약 9% 정도에 해당한다. 품위 분석 자료 중 칩샘플 분석 자료는 평균 10 m 구간에 대한 자료이기에 1 m 이하 구간에 대한 촘촘한 품위 예측에 사용하기 곤란하고, 상세 품위 예측에 활용할 수 있는 다기능 분석기를 활용한 품위 분석자료는 전체 이미지의 2%에 못미치는 426장에 대해서만 확보된 상황이다. 따라서 방대한 시추코어 이미지 자료를 효과적으로 활용하기 위하여 Auto-encoder 형태의 모델을 구성하여 비지도 방식의 사전학습을 수행하여 코어 이미지의 특성을 추출하는 기반 모델(encoder backbone)을 도출하고, 기반 모델을 이용하여 영역분할 모델 및 품위회귀 모델에 대한 전이학습을 수행하도록 계획하였다. 이는 라벨이 희소한 조건에서 대규모 미라벨 자료로 인코더 사전학습을 수행한 다음 소량의 라벨 자료로 파인튜닝하는 자기지도 학습 전략(He et al., 2022)과 같은 접근이다. 영역분할이나 품위회귀 모델은 근본적으로 이미지에 포함된 다양한 특성 정보를 얼마나 효과적으로 추출하는가에 모델 성능이 좌우될 것으로 예상되어 두 가지 모델에 공통으로 사용할 수 있는 Auto-encoder 모델을 설계하였다. 시추코어 이미지의 전역적 특성은 코어 박스 전체 이미지를 이용하여 추출하고, 암석 표면의 질감, 불연속면 상태, 입자 구성 특성, 코어 경계 등 상세 정보는 코어 직경 크기 2배 정도의 상세 이미지를 이용하여 추출하는 것으로 계획하였다. 이와 같이 광역적 특성과 상세한 특성은 상호 보완적 정보를 포함하고 있으므로, 두 가지 이미지를 동시에 입력으로 받아 학습할 수 있는 Two-stream Auto-encoder 아키텍처를 도입하였다. 또한 이미지 내의 x축과 y축에 대한 상대적 위치 정보를 별도의 채널로 학습 데이터셋에 포함하도록 CoordConv(Coordinate Convolution) 개념(Liu et al., 2018)을 도입하였다. Fig. 7은 시추코어 이미지 특성 추출 성능을 향상시키도록 구성한 Two-Stream Auto-encoder 아키텍처를 도시한 것으로, 위치 정보를 각각 CoordConv로 포함한 전역 이미지와 상세 이미지를 입력 자료로 받아 상세 이미지를 복원하도록 구성하였다. Two-Stream Auto-encoder는 ResNet encoder를 광역 이미지와 상세 이미지에 각각 연결하고 각 encoder 백본에서 추출된 특성맵을 Flatten 레이어를 통해 잠재벡터(Latent Vector)에 투영하는 구조로써, 잠재벡터가 특성맵의 정보를 추상화시키는 bottle neck 역할을 수행하게 된다. Two-Stream Auto-encoder 모델의 손실함수로 MSE(mean squared error)만을 적용하면 세부 질감 손실과 과도한 평활화가 발생함을 확인하였기에, MSE와 SSIM(structural similarity index measure, 구조적 유사도 지수)를 결합한 손실함수를 적용하여 전역적 이미지 형태와 암석 특유의 세부 미세 질감 특성을 균형 있게 학습하도록 유도하였다. Fig. 8은 Two-Stream Auto-encoder에 대한 사전학습을 통해 상세 이미지가 복원되어 가는 과정을 도시하였다. 잠재벡터가 bottle neck 역할을 하는 Two-Stream Auto-encoder의 구조적 특성에 의해 복원된 상세 이미지는 원본에 비해 세부 특성이 다소 손실된 형태임을 알 수 있다. 잠재벡터의 dimension과 learning_rate 등 하이퍼파라미터를 변경하여 실험을 수행한 결과, learning rate를 5.0e-4로 설정한 실험에서 잠재벡터 dimension이 1024일 때 validation SSIM = 0.5959, 잠재벡터 dimension이 2048일 때 validation SSIM = 0.6239 값을 보여 가장 높은 성능 지표를 달성하였다.
영역분할 모델 및 품위회귀 모델 전이학습
영역분할 모델 전이학습
Two-Stream Auto-encoder의 encoder layer의 가중치를 기반으로 영역분할을 수행하는 U-Net segmentation 모델의 아키텍처를 Fig. 9에 도시하였다. U-Net segmentation 모델의 성능 확보에 필요한 encoder layer와 decoder layer를 skip-connection을 적용하기 위해서 Auto-encoder를 4-stage ResNet 레이어를 이용하여 구성하였으며 ResNet 각 stage의 특성 맵이 U-Net decoder의 각 블록에 skip-connection으로 전달되도록 구성하였다. Fig. 10은 Two-Stream encoder 백본에 Bottleneck fusion 레이어와 U-Net decoder로 구성된 영역분할 head를 결합한 후 전이학습을 수행한 중간 과정의 이미지를 도시한 것이다. Two-Stream ResNet 백본의 이미지 특성 추출 성능을 활용한 이미지 영역분할 모델 학습 결과의 성능 지표는 잠재벡터 dimension이 1024인 백본 모델에 대한 전이학습을 수행한 모델에서 validation accuracy = 96.34%, test accuracy = 96.11%로 확인되었으며, 잠재벡터 dimension이 2048인 백본 모델에 대한 전이학습 모델에서 validation accuracy = 96.25%, test accuracy = 96.33%로 확인되었다. Table 4에 백본모델의 잠재벡터 dimension별 전이학습 모델의 성능지표를 정리하였다. 평균 test accuracy는 잠재벡터 dimension이 2048인 경우 가장 높게 확인되었으며, 전이학습을 통해 개발한 모델이 적용성 검토 과정에서 확인한 최대 성능인 validation accuracy 95.99% 및 test accuracy = 95.88%에 비하여 소폭 향상된 성능을 달성하였다. 개별 항목 중 코어로스 구간에 삽입된 Tube에 대한 test accuracy 결과가 매우 낮게 확인되었는데 이는 전체 시추코어 이미지 중 해당 부분이 희소한 상황(전체 라벨 이미지 1,936장의 약 2.1%인 40장에만 포함)에 기인하는 것으로 해석된다.
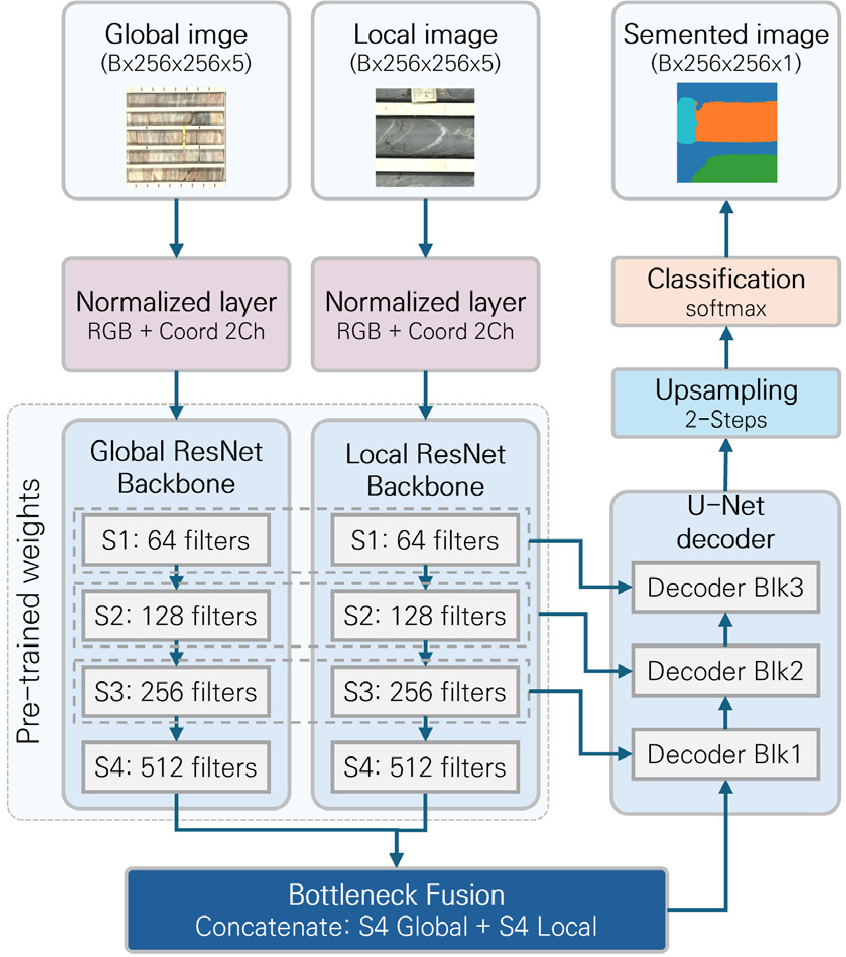
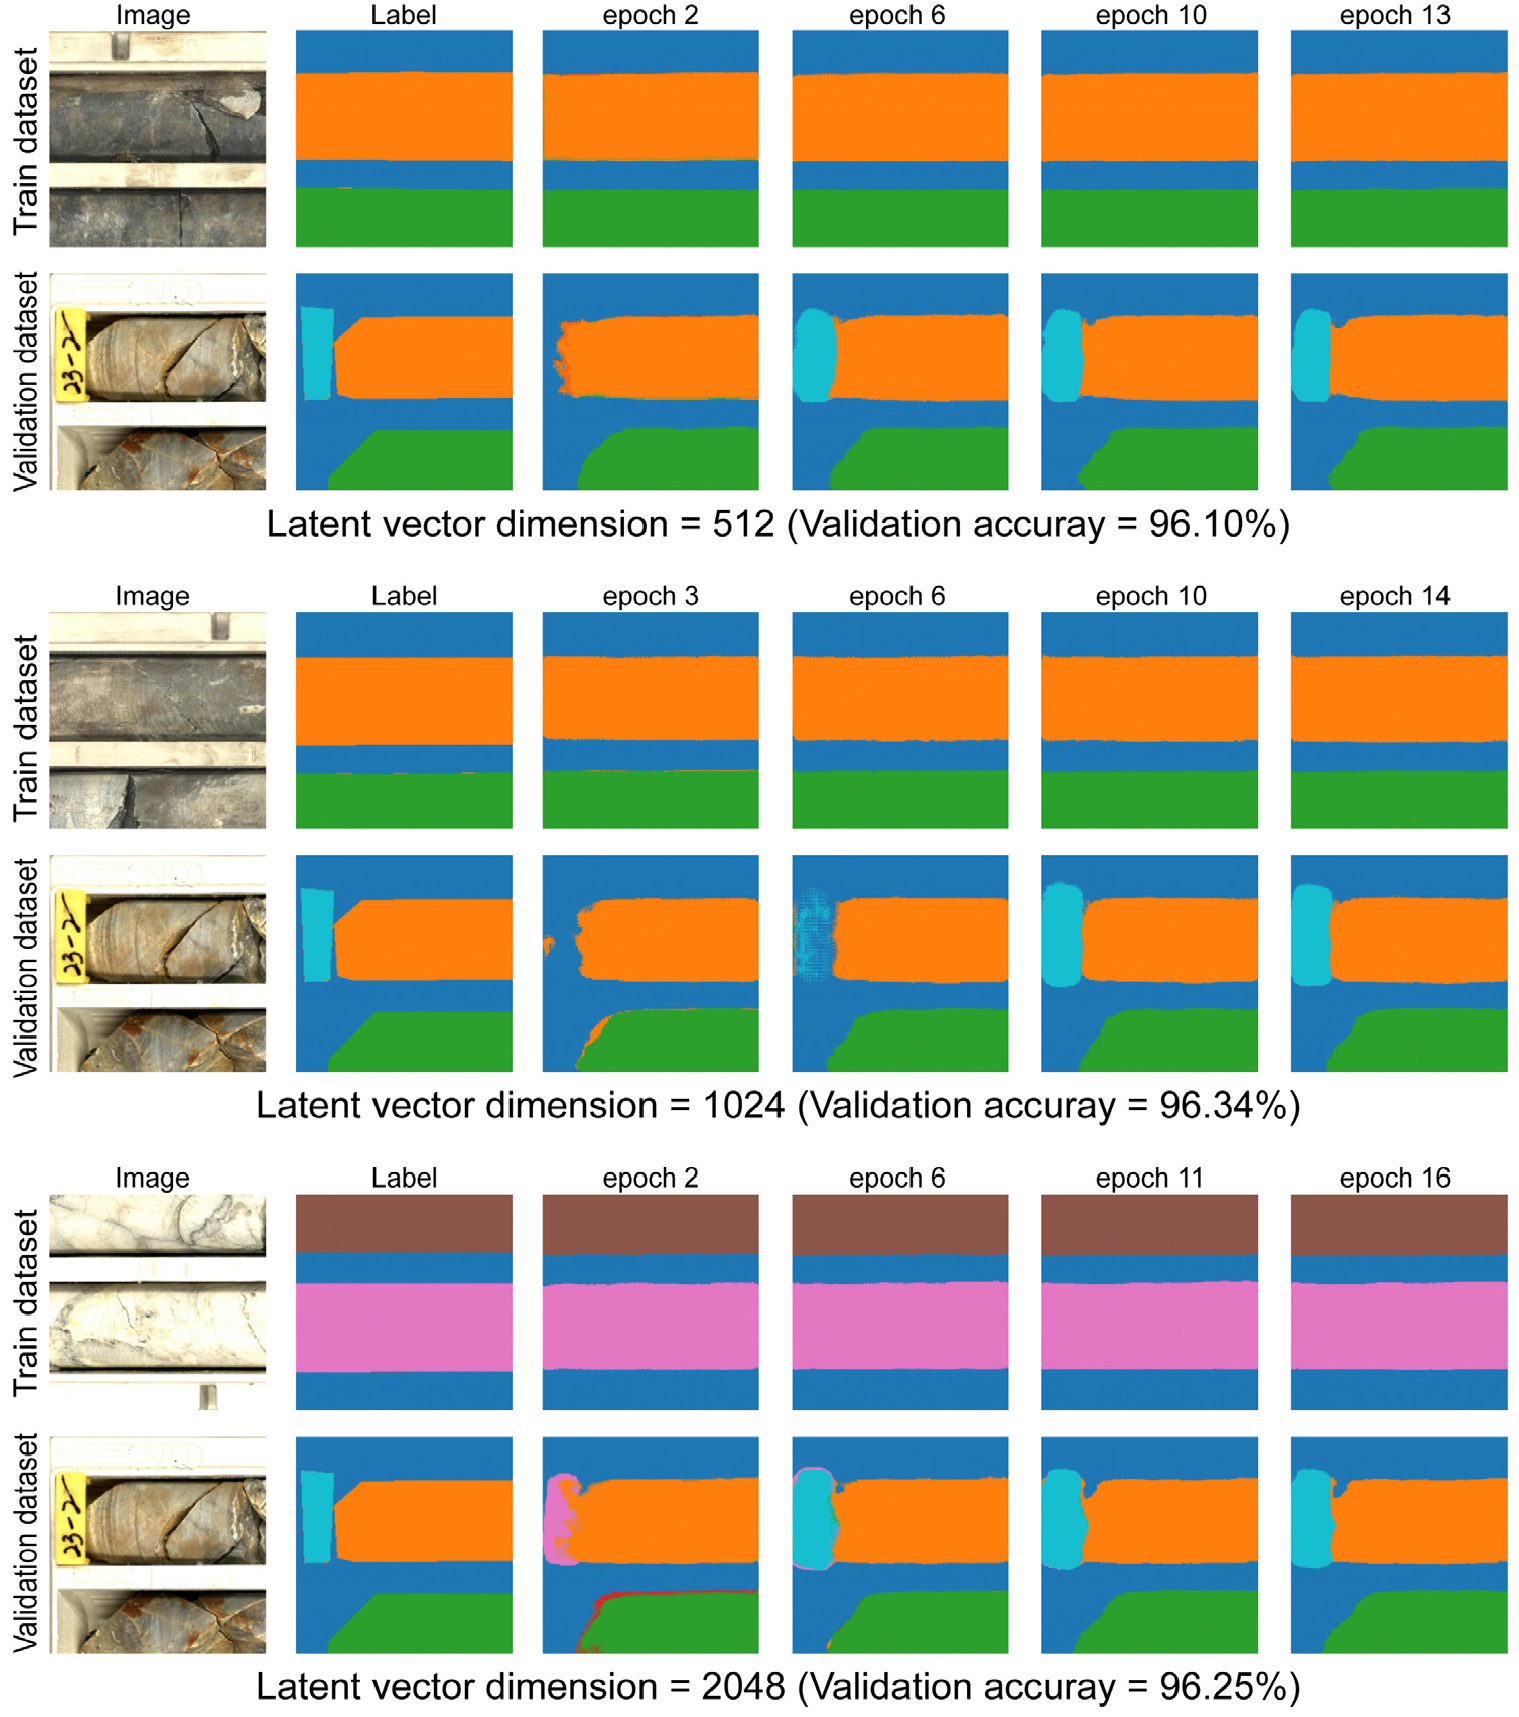
Table 4.
Comparison of the transfer training results from U-Net segmentation models
품위회귀 모델 전이학습
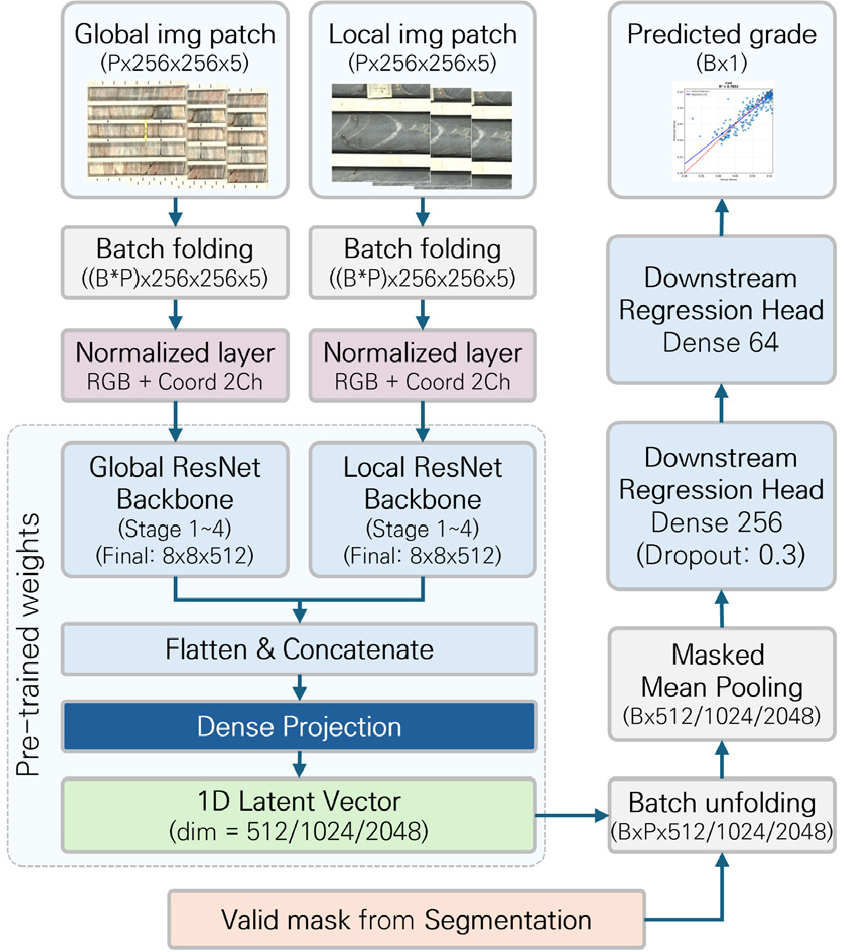
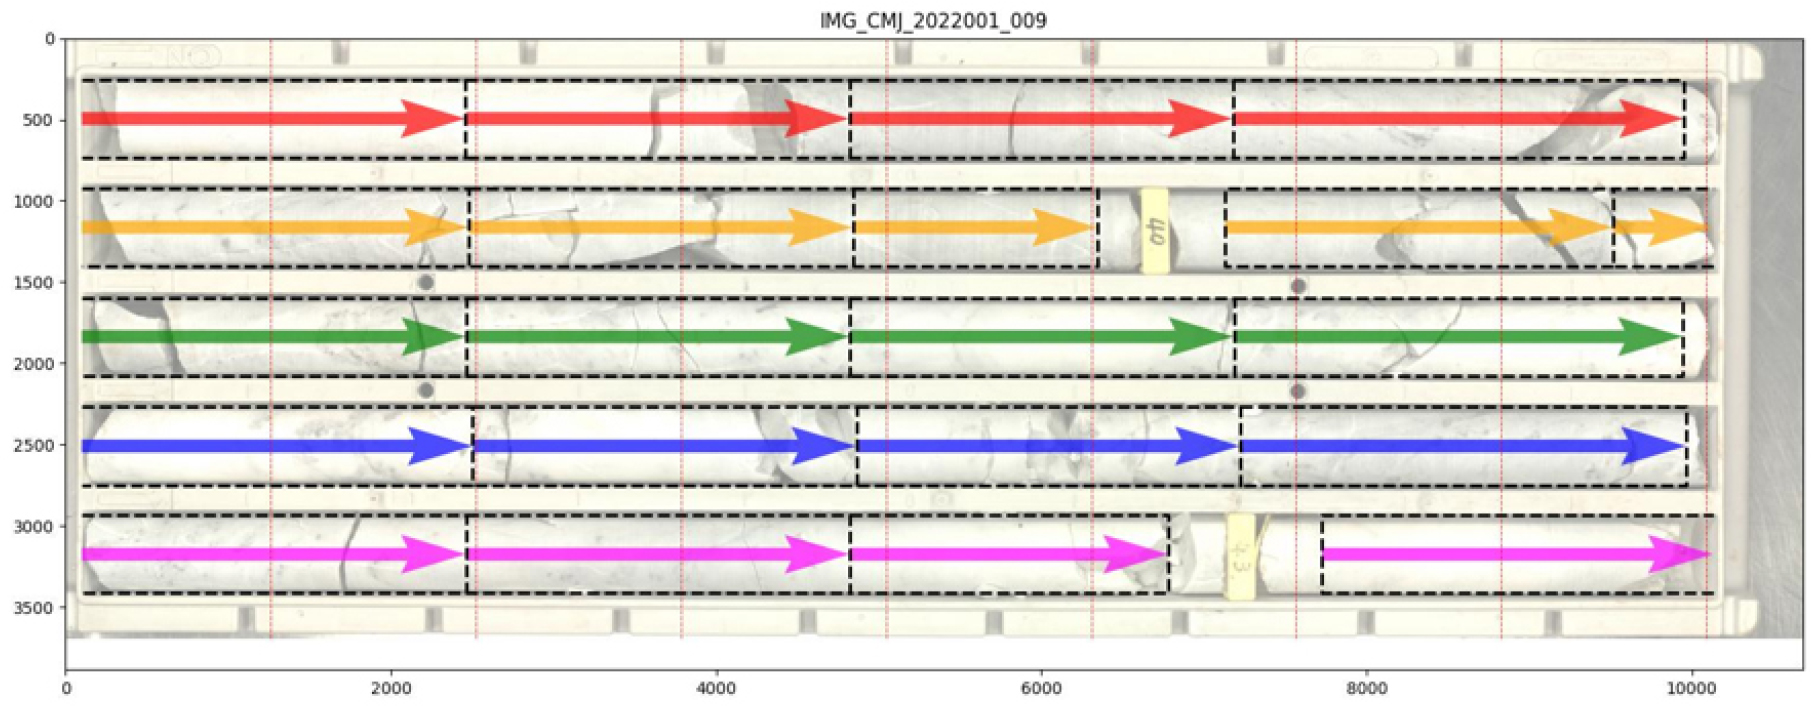
Fig. 11은 Two-Stream ResNet 백본의 잠재벡터에 Regression head를 결합한 품위 예측 모델의 아키텍처를 도시한 것이다. 적용성 검토를 위한 실험에서는 시추코어 이미지 전체 즉 전역 이미지에 대하여 10m 구간 칩샘플 분석 자료를 사용하였으나, 이는 앞서 설명한 바와 같이 상세 이미지에 대한 촘촘한 품위 예측 목적으로 사용하기 곤란하다. 따라서 상세 이미지에 대한 품위 예측 모델 학습을 위해서는 다기능 분석기를 이용하여 추가로 확보한 XRF 측정 자료를 학습용 라벨 자료로 적용하였다. XRF 측정 자료는 Fig. 12에 도시한 바와 같이 시추코어 이미지의 특정 심도 구간에 대한 연속적 XRF 측정 결과이기 때문에 모델 학습을 위해 정규화된 크기의 이미지를 일괄적으로 적용할 수 없는 문제를 가지고 있다. 이를 해결하기 위하여 XRF 측정이 수행된 구간을 여러 개의 patch로 구분하여 학습 데이터셋을 생성할 수 있도록 Multi-patch 개념을 적용하였다. Multi-patch는 다양한 측정 구간 길이 변화에 따라 적절한 개수의 코어 이미지를 patch로 구성함으로써 라벨 자료 즉 품위값 측정 구간의 길이 변화에 유연하게 대응할 수 있다. 또한 품위 예측 모델 학습 적용시 XRF 측정 구간 이외 영역, 즉 코어 박스, 배경, 심도 표시 말목 및 튜브에 해당하는 픽셀값이 품위 학습에 영향을 미치지 않도록 영역분할 모델을 통해 구분하여 학습 데이터셋 생성 시 마스킹 처리하였다. 마스킹 적용 시 비코어 영역을 0으로 치환하는 경우 수치의 급격한 변화로 인하여 코어 영역과 비코어 영역 사이에 극단적 경계가 존재하는 것 같은 효과가 발생한다. 또한 학습 과정에서 동일한 값으로 치환된 비코어 영역의 분산이 0으로 계산되며 특히 비코어 영역이 넓은 경우 해당 이미지 전체의 분산이 비정상적으로 작게 계산되는 분산 붕괴, 배치 정규화 왜곡 및 zero-gradient 문제 등을 초래하게 된다. 따라서 이러한 부작용을 극복하기 위하여 비코어 영역의 픽셀을 0으로 치환하는 대신, 코어 영역의 평균값과 분산을 고려한 노이즈를 주입하는 통계적 노이즈 주입(Gaussian noise injection) 기법을 적용하였다. 통계적 노이즈 주입은 segmentation 엔진을 적용한 결과를 regression 학습 데이터셋으로 저장할 때 적용하였다. 이와 더불어 전체 이미지 중에서 코어 영역이 차지하는 비율인 유효 코어 픽셀 비율은 해당 코어 박스 내의 코어 회수율과 관련이 있으므로, 유효 코어 픽셀 비율을 스칼라 값으로 추출하여 전역 이미지 처리 과정에 어텐션 가중치 계산에 활용하였다.
품위회귀 모델 고도화
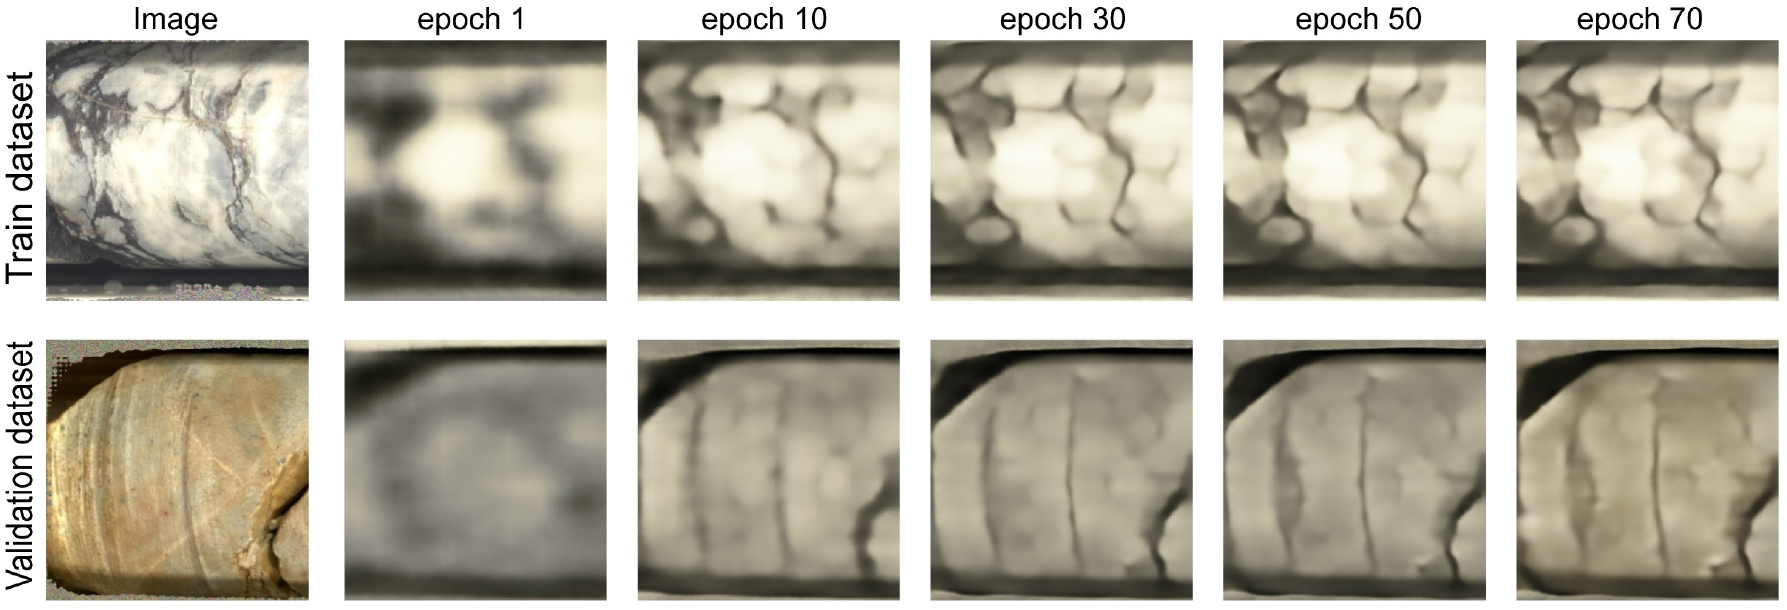
Two-Stream Auto-encoder는 영역분할 모델과 품위회귀 예측 모델의 전이학습에 공통으로 사용할 목적으로 학습을 수행하였기에, 사전학습 데이터셋 중 상세 이미지의 크기 선정 기준을 코어박스의 분리 칸이 포함될 수 있도록 코어 직경 2배 정도로 결정하였다. 이와 같이 상세 이미지의 크기를 품위 예측 대상인 코어 직경보다 크게 적용하였기에 특정 열에 대한 XRF 측정값을 라벨로 사용할 경우 상세 이미지 입력 자료는 해당 코어 열 이외의 다른 열의 이미지는 제외하여야 하는데 이 경우 품위회귀 전이학습을 위한 데이터셋에서 상세 이미지의 절반 이상이 마스킹 처리되어야 하는 문제가 발생하였다. 따라서 품위회귀 모델의 백본을 당초 계획과는 달리 상세 이미지의 크기를 줄여서 재학습을 수행할 필요성이 제기되었다. 게다가 영역분할 모델에서는 유용한 위치 편향(spatial bias)은 품위회귀 측면에서는 암석 고유의 질감 학습을 저해할 가능성이 높아, 품위회귀 모델의 사전학습 과정에는 CoordConv를 이용한 위치정보를 학습 데이터셋의 입력에서 제외하는 것이 성능 확보에 유리할 것으로 판단되었다. 이러한 두 가지 수정 사항을 반영하여 품위회귀 모델을 위한 별도의 사전학습을 수행하였다. Fig. 13은 품위회귀 모델을 위한 전용 Auto-encoder에 대한 사전학습 수행 결과이다. Fig. 8에 도시한 기존 사전학습 모델의 결과와 비교하면 질감 등 상세 특성의 복원 성능이 더 향상된 것으로 확인되며, 정량적으로도 validation SSIM의 최대값이 0.6668으로 기존 Two-Stream Auto-encoder의 0.6239에 비해 높은 결과를 보여준다.
또한 Auto-encoder 아키텍처에서 이미지 특성 맵의 잠재벡터 투영을 위해 Flatten 레이어를 적용하였었는데, 이는 Auto-encoder 자체의 성능 지표를 향상하기 위한 목적으로써 상당히 큰 파라미터를 차지한다. 그런데 Auto-encoder의 학습은 비지도 학습으로 매우 많은 학습 데이터셋을 사용할 수 있음에 비해, 품위회귀 모델의 학습에는 자료의 수량이 제한되어 있어 Flatten 레이어를 그냥 사용할 경우 과도한 파라미터로 인해 과적합이 발생하였다. 따라서 품위회귀 모델에서는 Flatten 레이어를 Global Average Pooling(GAP) 레이어로 교체하여 잠재벡터로 투영하도록 인코더 구조를 고도화하였다.
Fig. 14는 Two-Stream Auto-encoder의 GAP 레이어로 교체된 encoder를 백본으로 적용하고 품위회귀 head를 결합하여 전이학습을 수행한 결과이다. 품위회귀 모델에 대한 전이학습은 epoch 50 까지는 선형탐색(Linear Probing) 즉 백본의 가중치를 동결한 상태로 수행하였고 epoch 51 이후에는 백본 레이어 중 BatchNormalization 레이어를 제외한 나머지 가중치 동결을 해제하여 파인튜닝을 수행하였다. 전이학습 중 선형탐색 과정에서는 학습이 진행됨에 따라 학습 데이터셋과 검증 데이터셋의 R2-score가 동시에 향상되는 양상을 보이며, 파인튜닝 단계에서는 학습 데이터셋의 R2-score는 지속적으로 향상됨에 비해 검증 데이터셋의 경우에는 평균값으로 수렴하는 경향이 확인된다. 해당 학습의 best 모델은 파인튜닝 이후 13번째 epoch에서 나타나며, best 모델의 validation R2-score는 0.5424, validation MAE는 8.767로 계산되었고, 학습에 사용하지 않은 별도 시추공의 테스트 데이터셋으로 평가한 성능지표는 test R2-score = 0.2199, test MAE = 9.369로 산출되었다(Table 5 참조). 검증 성능지표에 비해 평가 성능지표의 값이 작은 것으로 보아 일반화 성능이 충분히 확보되지 않은 것으로 판단하였다.
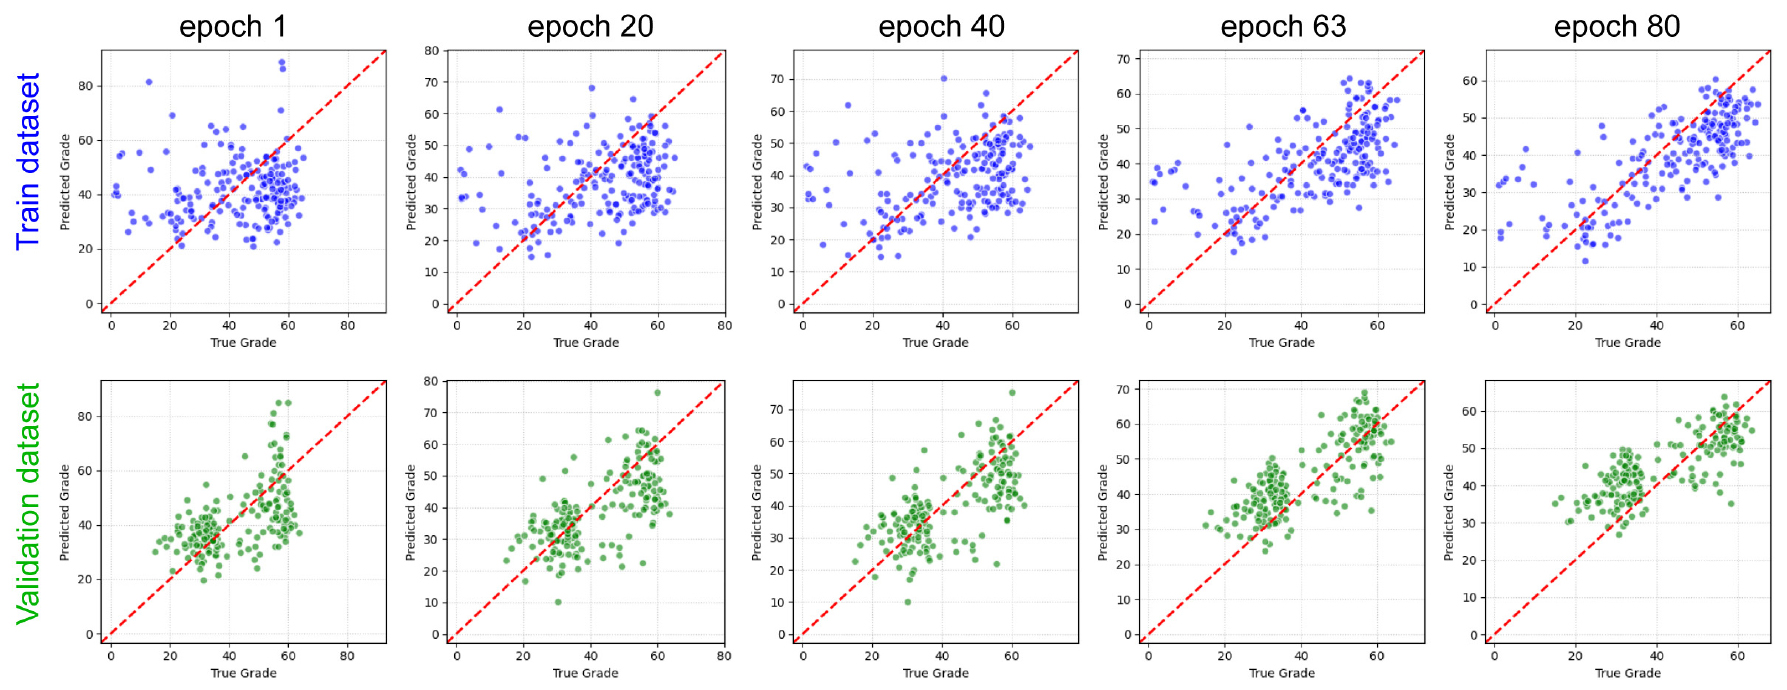
Table 5.
Comparison of the transfer training results from Regression models
품위회귀 모델 성능 향상을 위한 자료증강 및 Huber 손실함수 도입
Two-Stream ResNet Auto-encoder의 encoder layer를 백본으로 하는 품위회귀 모델의 성능 향상을 위해 학습 데이터셋에 대한 자료증강(augmentation)을 적용하였다. 다기능 분석기 XRF 자료는 약 25 cm 길이의 코어 구간에서 측정되므로 2개의 서로 다른 측정값을 임의의 비율로 가중 평균하면 50 cm 구간에 대한 측정 자료와 유사한 효과가 생길 것 같은 단순한 아이디어에서 출발하여, 시추코어 이미지 자료의 지질학적 타당성을 유지하기 위해 통제된 베타 분포 기반의 다이나믹 믹스업(Dynamic MixUp) 기법을 도입하였다. 품위 예측을 위한 회귀 모델 개발 과정에서 제한된 XRF 측정 자료의 수량적 한계를 극복하고 특정 품위 구간에 데이터가 편중된 불균형 문제를 해소하여 품위회귀 모델의 일반화 성능을 향상시키기 위한 MixUp (Zhang et al., 2017) 기반의 맞춤형 자료증강 기법을 적용하였다. 일반적으로 데이터 증강을 위해 두 이미지를 단순 가중 평균하면, 두 이미지의 특성이 반반씩 섞인 흐릿한(blurry) 이미지가 생성되어 실제 암석의 물리적 형태나 시각적 매니폴드(manifold)에서 크게 이탈하는 부작용이 발생한다. 이를 방지하기 위해 본 모델은 추출 가중치를 결정하는 베타 분포의 매개변수를 alpha = 0.2, beta = 0.2로 설정하였다. 이러한 하이퍼파라미터 설정은 확률 밀도 함수를 양극단(0과 1)으로 치우친 극단적인 U자형 분포로 유도한다. 이에 따라 추출된 난수 값은 0.5 부근의 중간값보다는 0.0이나 1.0에 매우 가까운 값으로 편향 추출된다. 그 결과 믹스업 블렌딩 시 한쪽의 지배적 원본 이미지(dominant original)가 80~90% 이상의 시각적 주도권을 유지하게 되며, 다른 한쪽의 이미지는 10~20% 수준의 미세한 노이즈 텍스처 형태로만 투영된다. 결과적으로 원본 암석 이미지의 고유한 균열, 입자 형태, 질감 등 구조적 형태를 온전히 보존하면서도, 신경망의 결정 경계(decision boundary)를 국소적으로 부드럽게 만들어주는 연속적인 정규화(regularization) 효과만을 부여함으로써, 매니폴드 이탈 현상 없이 과적합을 방지하는 최적의 임계점 역할을 수행하도록 구현하였다. 코어 이미지에서 배경을 제외한 실제 암석의 면적(유효 코어 픽셀 비율)은 XRF 측정 면적과 직접적으로 연관되므로 품위 예측의 중요한 메타데이터이다. 본 연구에서는 영역분할 모델에서 도출된 유효 코어 비율(valid ratio) 변수를 시각적 잠재벡터와 결합하여 어텐션 메커니즘(Attention Pooling)의 가중치 변수로 입력하였다. 이 구조는 신경망이 시퀀스(Multi-crop patches) 내에서 실제 코어의 면적이 넓어 신뢰도가 높은 패치에 더 높은 어텐션 점수를 부여하도록 학습을 유도한다. 특히 이 유효 코어 비율 역시 믹스업 과정에서 이미지 텐서, 품위와 동일한 추출 가중치로 가중 평균되어 동적 결합된다. 따라서 모델에 전달되는 최종 혼합 이미지는 시료 A의 시각적 형태를 거의 90% 이상 유지한 상태이며, 딥러닝 어텐션 층은 “시료 A와 매우 유사하게 생긴 암석이 0.85 면적 비율을 가질 때, 49%의 품위 특징을 갖는다”는 논리적으로 보정된 상호관계를 학습하게 된다. 이처럼 시각적 특징, 유효 면적비, 품위값이 모두 동일한 궤적을 따라 수학적으로 동기화됨으로써, 모델은 물리적으로 상충되지 않는 풍부한 가상의 품위-면적 조합을 안전하게 학습하여 일반화 성능을 향상시킬 수 있도록 구현하였다.
또한 예측 품위값이 참값에 비해 극단적 차이를 보이는 소수의 이상치(outlier)를 포함할 때 단순한 MSE 손실함수를 적용하면 손실 왜곡에 따른 가중치 파괴 현상이 발생할 수 있으므로, L1 손실(MAE)과 L2 손실(MSE)을 선택적으로 적용하는 Huber loss 함수를 도입하였다. 이때 MAE와 MSE의 적용을 구분하는 전환 임계값(delta)를 사전에 정의하여 모델 학습에 적용하였다. 개선된 품위회귀 모델에 대한 전이학습은 선형탐색만 수행하였으며, 하이퍼파라미터(학습률, regression head의 drop out, Huber loss의 전환 임계값)를 변경하면서 실험을 수행하였다.
Fig. 15는 자료증강 기법과 Huber loss 함수를 적용하여 수행된 학습 결과 중 학습률 1.0e-3, drop out 0.4, huber delta 27.0으로 설정한 학습 결과를 epoch 별 절대오차(Absolute Error, AE) 값의 분포와 함께 도시하였다. 해당 학습은 epoch 14에서 가장 낮은 validation loss를 기록하였다. 자료증강 및 손실함수 개선을 통해 고도화된 학습 결과는 validation R2-score 0.5632로 이전 학습 결과(GAP과 파인튜닝을 적용한 전이학습 결과 중 best model의 결과, Table 5 참조) 0.5424에 비해 향상되었으며, validation MAE는 8.67로 이전 결과인 8.84에 비해 약간 향상되었다. Fig. 15의 우측 epoch 별 AE 분포에서 validation AE 95% percentile에 해당하는 값이 20.015로 나타났다. 여기서 절대오차(AE)는 참값과 예측값의 상대적 비율(%)이 아닌, 두 값 간의 절대적인 중량 퍼센트(wt%p) 차이를 의미한다. 즉, 검증 데이터셋의 95%가 실제 품위 대비 ‘±20 wt%p’ 이내의 절대오차 범위 내에 분포함을 의미한다.
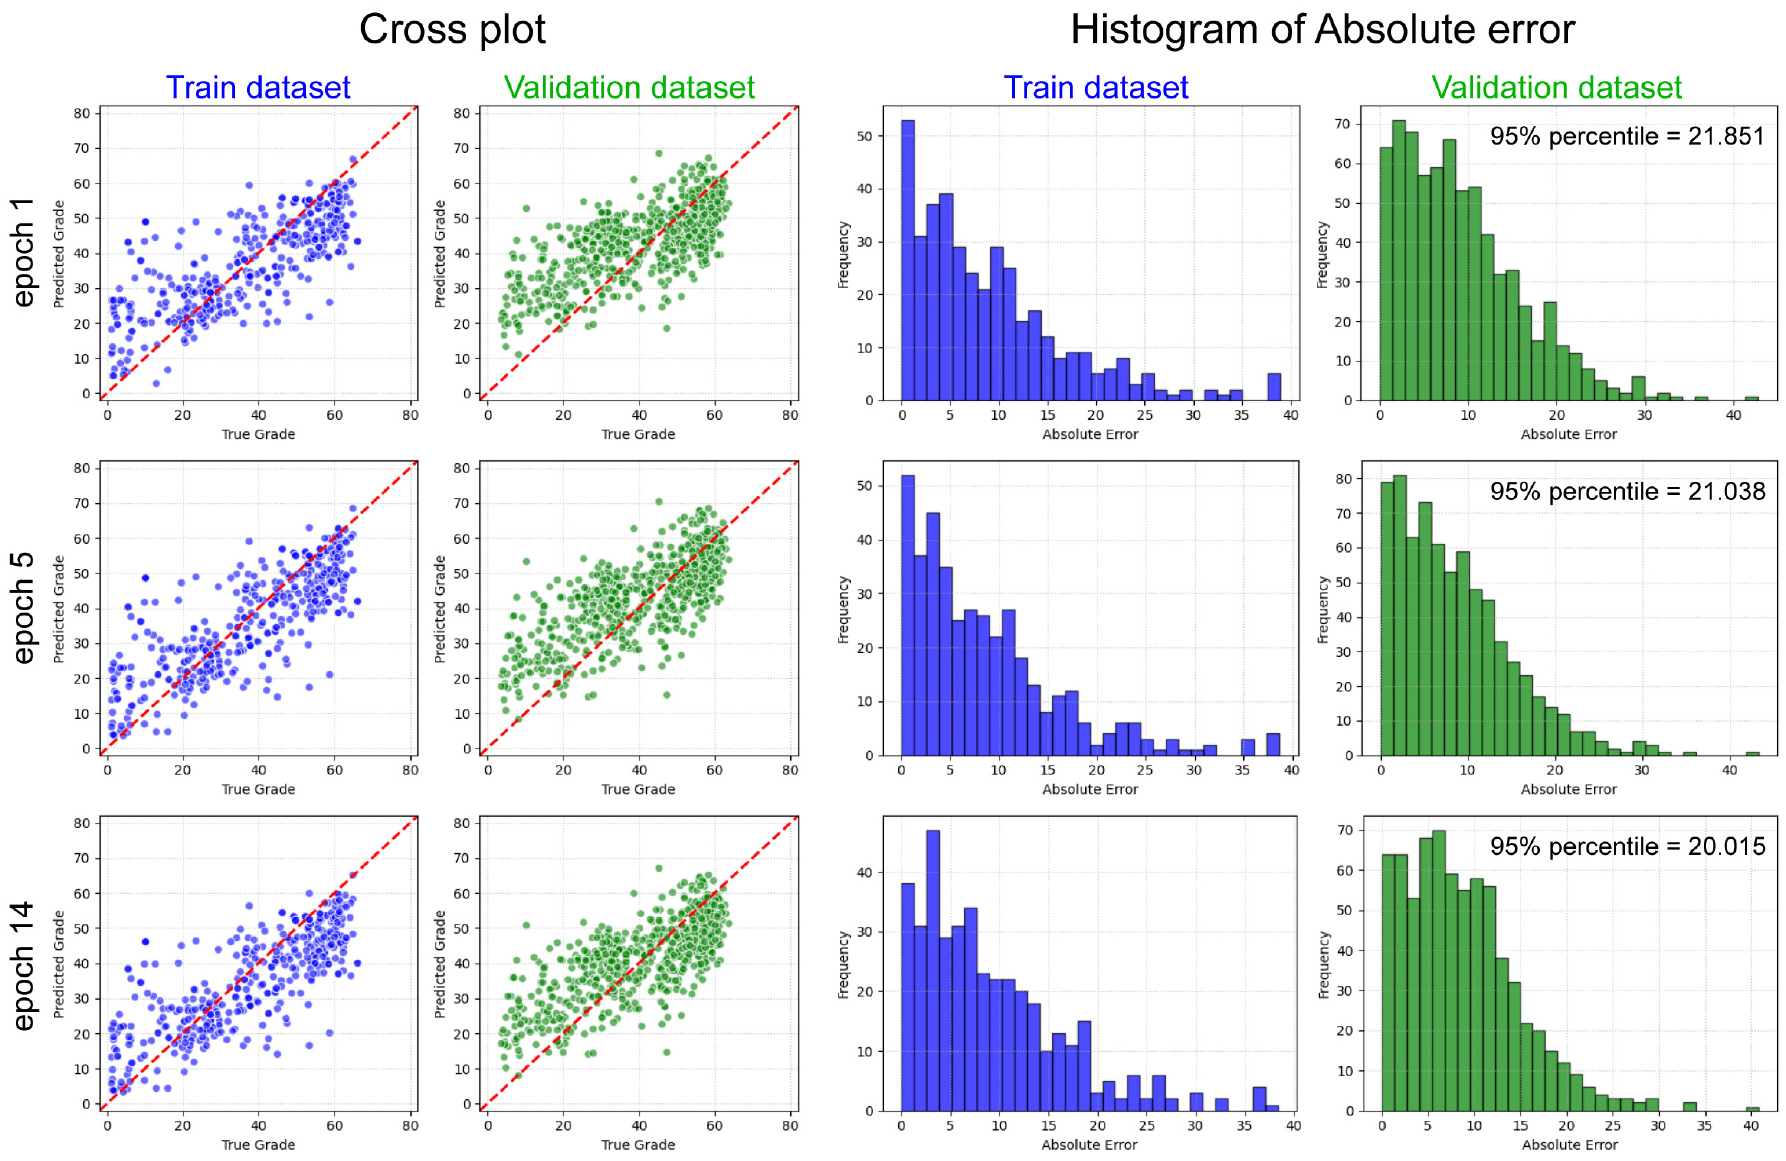
Fig. 16은 해당 학습 과정의 metrics를 도시한 것으로 epoch가 증가함에 따라 train loss와 train R2-score는 악화하는 것에 비해 validation loss와 validation R2-score는 epoch 14까지 지속적으로 향상되는 형태를 확인할 수 있다. 이는 학습 진행에 따라 학습 데이터셋에 대한 과적합이 해소되면서 검증 데이터셋에 대한 성능 지표가 향상된 것으로 일반화 성능이 향상된 것으로 해석된다.
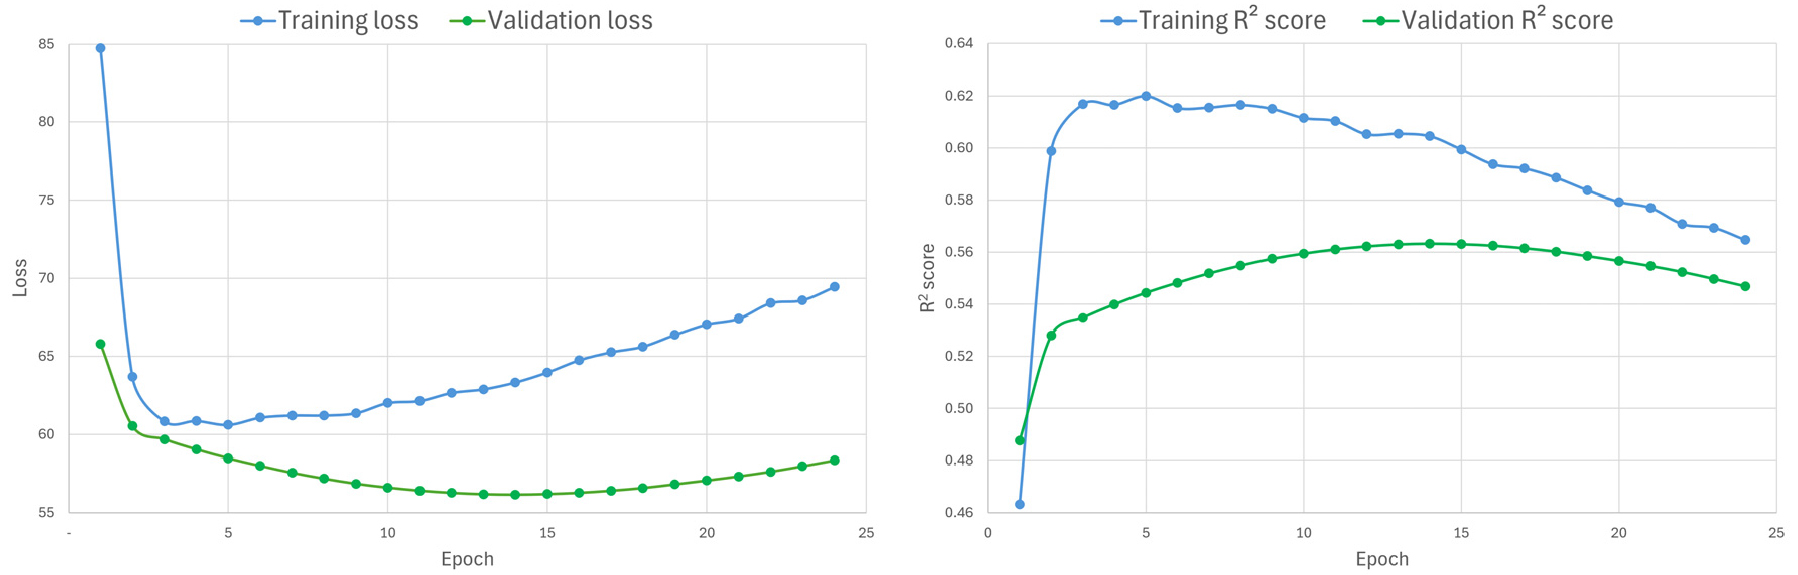
Table 5에는 사전학습 모델을 기반으로 GAP을 적용한 전이학습, 자료증강 기법과 Huber loss 함수를 적용하여 수행된 학습 수행 과정에서 도출된 단계별 모델의 성능지표를 정리하였다. 품위회귀 모델에 대한 고도화 단계에 따라 검증 성능 지표 및 평가 성능 지표가 소폭이지만 증가하는 추세가 확인된다. 실험 결과 중 자료증강을 적용한 결과는 GAP과 Huber loss 함수를 적용한 경우에 비하여 검증 성능 지표는 향상된 반면 평가 성능 지표는 오히려 감소함을 확인할 수 있다. 이는 자료증강을 적용함으로써 오히려 일반화 성능이 감소했음을 시사하고 있다. 그런데 파인튜닝의 하이퍼파라미터 검색 과정에서 백본 모델의 가중치 동결을 일부 해제한 경우 급격한 과적합이 발생한 사례가 다수 확인된 상황에 비추어 볼 때 학습 데이터셋 수량의 절대적 부족에 기인한 상황을 강하게 의심하게 된다. 또한 품위회귀 모델 고도화 단계에서는 시추공별 자료를 동일한 데이터셋에 포함하는 그룹 K-Fold 기법을 적용하였는데, 전체 시추공 8개 중 1개를 검증용 데이터셋에 할당하고 다른 1개를 평가용 데이터셋에 할당한 결과 각 시추공 자료가 가지고 있는 자료 편향의 영향을 배제하기 어려운 것으로 이해된다.
지금까지의 연구를 통해 개발된 석회석 품위회귀 모델은 평가 데이터셋 기준 R2-score가 0.4199로 도출되어 일반화 성능은 확인하였으나, 정밀한 예측 성능 관점에서는 아직 뚜렷한 한계를 내포하고 있다. 이러한 품위 예측 성능의 한계는 주로 학습 데이터셋 수량의 절대적 부족과 시추공별 자료 편향에 기인한 것으로 판단된다. 전체 8개의 시추공 중 1개를 검증용, 다른 1개를 평가용으로 할당하는 그룹 K-Fold 기법을 적용한 결과, 특정 시추공이 가진 지질학적 특성 편향의 영향을 배제하기 어려웠으며, 저품위 구간과 고품위 구간에서 예측값이 학습 자료의 품위값 평균에 치우치는 평균 회귀 편향(regression to the mean bias) 역시 주요 한계점으로 확인되었다.
현재 수준의 모델은 광체와 폐석 구간을 개략적으로 구분하는 1차 스크리닝 도구로서의 효용성은 가지나, 실무에서 정밀 XRF 스캔이나 시료 분석을 일부 보완하고 3차원 매장량 평가의 보조 데이터(soft data)로 융합되기 위해서는 예측 성능의 획기적인 향상이 필수적이다.
석회석 품위 예측 모델의 성능 개선 및 한계 극복을 위한 세부 방안은 다음과 같다.
첫째, 예측 정확도를 높이고 편향을 해소하기 위해 다기능 분석기 기반의 고해상도 연속 XRF 측정 자료를 지속적으로 축적하여 절대적인 학습 데이터 수량을 확대할 계획이다. 둘째, K-Fold 모델 앙상블 기법 및 반복 교차 검증을 도입하여 특정 폴드의 데이터 편향과 왜곡을 상쇄하고 안정적 일반화 성능 확보를 수행할 계획이다. 마지막으로 자료증강 기법의 부작용을 최소화할 수 있는 추가적인 파인튜닝 하이퍼파라미터 최적화 연구를 수행하고, 현장 적용성 향상을 위해 앙상블 기법을 통해 도출된 불확실성(Uncertainty) 지표의 정량화 기법에 대한 검토를 수행할 계획이다.
품위회귀 모델의 활용성 검토
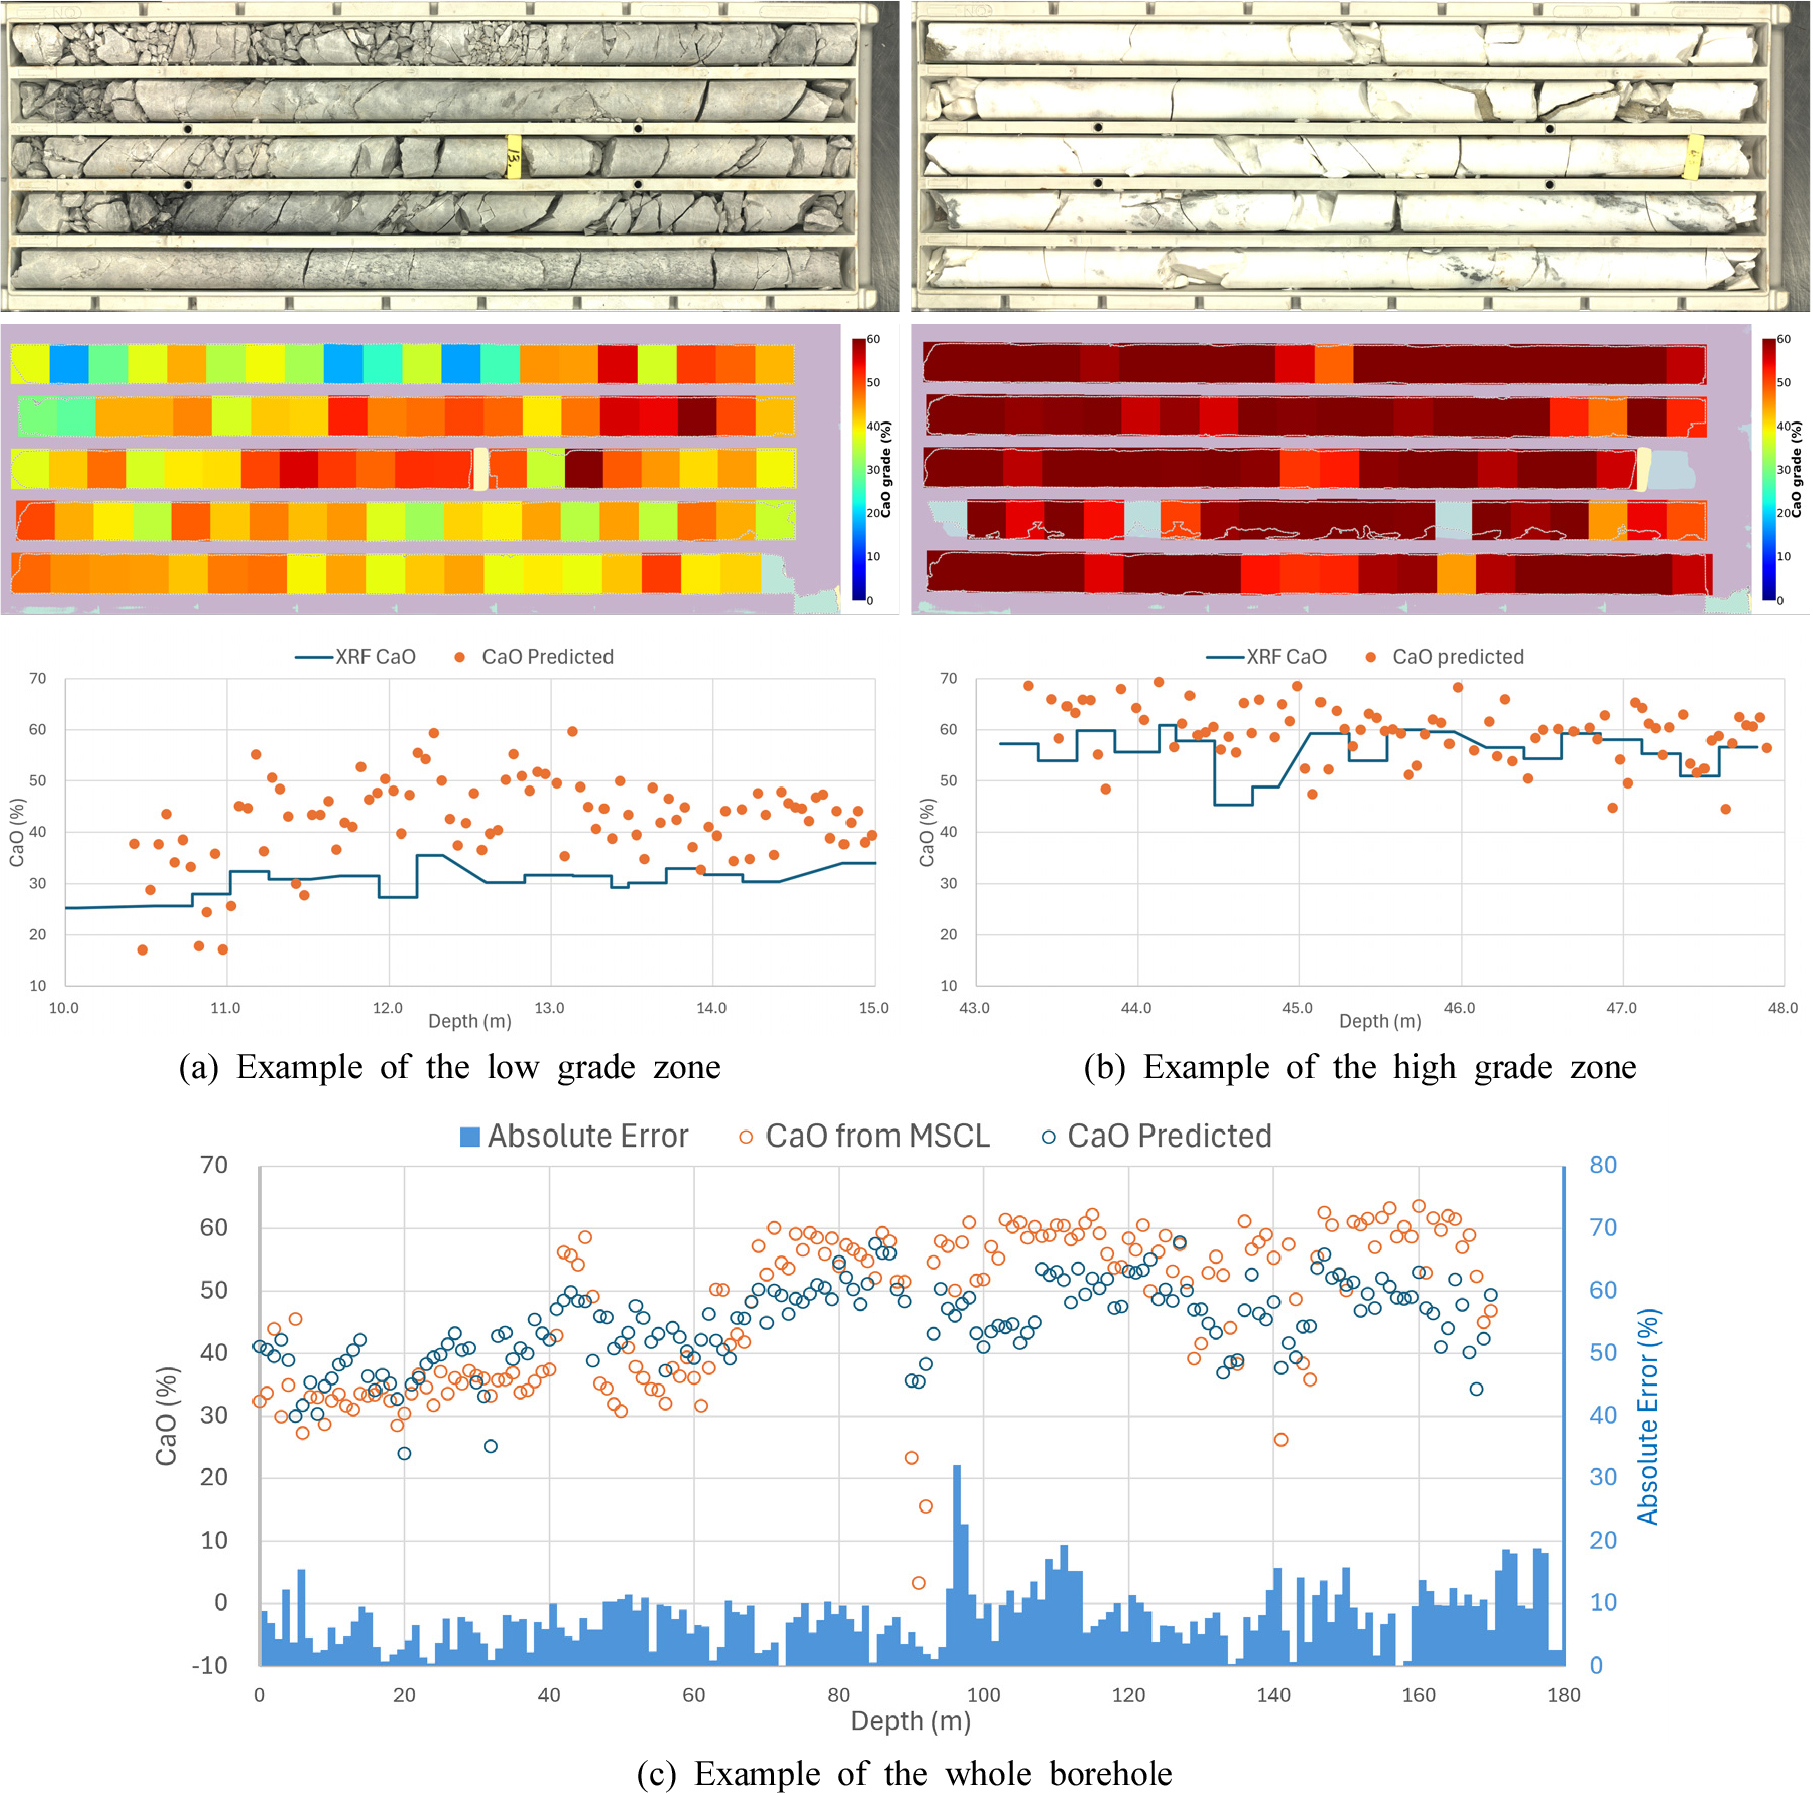
Fig. 17은 현재까지 개발된 품위회귀 모델을 활용성에 대한 검토를 위해 시추코어 이미지로부터 CaO 품위를 추론하고 추론된 결과를 원본 이미지와 대비할 수 있도록 시추코어 박스별 품위 분포 영상 및 심도별 품위분포 그래프를 작성한 예시이다. 고도화 단계에서 설명한 바와 같이 품위 추론은 코어 두께와 동일한 정방형 패치에 대하여 수행되며 상황에 따라 연속된 패치를 동시에 추론의 입력으로 사용할 수 있다. Fig. 17에 도시된 품위 예측 간격은 가로 세로 각각 약 5 cm 정도의 패치가 적용되었으며, 패치 영역은 영역분할 엔진의 결과를 이용하여 자동으로 생성되도록 구현되어 있다. Fig. 17(a)는 저품위 구간에 대한 추론 결과의 예시이며 Fig. 17(b)는 고품위 구간에 대한 예시로써, 현재 모델이 가지고 있는 한계인 평균 회귀 편향, 즉 저품위 구간은 더 높은 값으로 추론되고 고품위 구간은 더 낮은 값으로 추론되는 경향성을 보여주고 있다. 다만 고품위 구간의 경우에 상대적으로 오차가 적은 것으로 판단되며, 이는 학습 자료의 품위 분포가 고품위 영역에 집중된 영향으로 판단된다. 품위회귀 모델로부터 추론된 CaO 품위값을 시추코어 이미지와 동일한 크기로 영상화함으로써 코어박스 이미지별 품위 경향과 분포 특성의 직관적 파악에 활용될 수 있다. Fig. 17(c)는 하나의 시추공 전체 구간에 대한 추론을 수행하고, 추론 결과를 1 m 간격으로 평균값을 구하여 XRF 분석 결과와 대비하여 도시하고, 그림 하단에는 추론 결과와 XRF 값의 절대 오차를 막대그래프 형태로 도시하였다. 여기에서도 저품위 구역의 오차가 상대적으로 큰 것을 확인할 수 있다. 예시한 자료는 품위회귀 학습시 평가 데이터셋으로 적용된 시추공 자료를 Fig. 15와 Fig. 16에 설명한 모델을 이용하여 품위를 예측한 결과이다. 해당 시추공에 1 m 간격 절대 오차의 평균은 7.74 wt%p로 계산된다.
이 연구를 통해 현재까지 도출된 품위예측 모델에 대한 평가용 데이터셋 기준 모델 성능(Test MAE 약 8.18, R2 score 약 0.42 수준)은 석회석의 엄밀한 광석 품질 구분(수 % 이내의 오차 허용)에 사용되는 전통적인 정밀 XRF 스캔이나 화학 분석을 완전히 대체하기에는 오차 범위가 넓다. 그러나 본 연구 과정에서 확보한 시추코어 이미지에 대한 딥러닝 적용 방법론을 기반으로 추가적인 학습 자료 확보 및 추가 학습을 통해 다음과 같은 실무적 활용이 가능한 품위 예측 모델을 확보할 수 있을 것으로 기대된다.
첫째, 기존 10 m 단위로 수행되던 칩샘플(Chip sample) 분석의 낮은 공간 해상도를 보완할 수 있다. 고가의 다기능 분석기 스캔을 모든 시추공에 적용하기 어려운 현장 상황에서, 기 구축된 시추코어 이미지만을 활용하여 약 5~50 cm 단위의 촘촘한 품위 경향성을 신속하게 확보할 수 있다.
둘째, 광체와 폐석 구간의 1차적 스크리닝 도구로써 효용성이 기대된다. 품위 모델을 통해 고품위(광체)와 저품위(폐석 및 불순물) 구간을 사전에 개략적으로 분류함으로써, 향후 정밀 실험실 분석이 필요한 시료 구간을 효율적으로 선별하고 분석 비용을 최적화하는 가이드라인 역할을 할 수 있다.
셋째, 향후 3차원 품위 분포 모델링 시, 이 연구를 기반으로 추가 개발될 딥러닝 모델의 예측값과 해당 MAE 오차 범위를 불확실성(Uncertainty) 지표로 포함하여 크리깅(Kriging) 등의 공간 통계 기법에 보조 데이터(Soft data)로 융합 적용한다면, 데이터가 부족한 미시추 구간의 매장량 평가 신뢰도를 높이는 데 크게 기여할 수 있을 것으로 판단된다.
결론 및 향후 계획
한국광해광업공단(KOMIR)의 국가광물정보센터에서 보유하고 있는 국내 석회석 광산의 시추코어 자료를 기반으로 시추코어 이미지로부터 석회석 품위를 예측하는 딥러닝 모델 개발에 관한 연구를 자료 현황 분석, 적용성 검토를 통한 베이스라인 모델 선정, 대규모 자료를 이용한 비지도 사전학습, 라벨링 자료를 이용한 전이학습 및 파인튜닝 등의 단계로 수행하였다. 개발 과정에서 딥러닝 모델의 목적에 따라 달라지는 이미지 자료에 대한 요구사항과 이를 고려한 모델 아키텍처 선정의 중요성을 확인하였고, 학습 데이터셋이 부족한 경우 해결 방법에 대한 검토와 적용을 통해 딥러닝 고도화 프로세스를 수립하였다. 연구 과정을 통해 확인한 주요 사항은 다음과 같다.
1. 딥러닝 기반 시추코어 이미지 분석 시 영역분할 모델과 품위회귀 모델 간의 상충되는 데이터 요구사항을 확인하였다. 영역분할 모델은 공간 위치 정보가 필요함에 비해 품위회귀 모델은 미세 질감 정보가 더 중요하므로, 사전학습을 통한 전이학습을 수행할 때 사전학습 백본을 공동으로 사용하는 방법보다는 각각의 특성과 목적에 맞추어 태스크별로 구분하여 개발하는 것이 효과적인 것으로 판단된다.
2. 학습 자료가 부족한 경우 과대한 파라미터는 과적합을 초래할 가능성이 높으므로 딥러닝 네트워크 설계 및 선정 시 학습 자료 수량을 고려한 레이어 선택이 중요하며, 다양한 형태의 자료증강 기법 적용과 자료 특성을 고려한 손실함수 적용이 필수적임을 확인하였다.
3. 회귀 모델 구현 시 이미지 중 불필요한 부분은 처리할 때 단순히 0으로 치환하는 것을 지양하고 해당 이미지의 평균값과 분산을 적용한 통계적 노이즈 주입을 통해 학습 자료 내부의 인위적 경곗값 발생과 zero-gradient 현상을 방지하는 것이 필수적임을 확인하였다.
지금까지의 연구 개발 과정을 통해 확인한 시추코어 이미지에 대한 영역분할 모델 및 품위회귀 모델의 한계와 문제점을 지속적인 고품질 학습 자료 확보, 검증 방법 보완, K-Fold 모델 앙상블 적용 등을 통해 미해결된 편향성 및 왜곡을 최소화하고 현장 적용성을 확보하도록 보완할 계획이다. 보완 과정에서 추가적인 파인튜닝 하이퍼파라미터 최적화와 앙상블 기법을 통한 불확실성 검증을 수행하고, 지속적인 학습 자료 확보 및 추가 학습을 통해 다양한 활용이 가능한 수준으로 모델의 성능지표를 향상할 수 있는 기반을 마련할 계획이다.