

서 론
연구방법
프로토타입 플랫폼 개발
데이터 수집 및 표준화
K-RISK 산출
근거 기반 다중 에이전트 숙의
검증 방법
연구결과 및 고찰
프로토타입 플랫폼 구현 결과
K-RISK 검증 결과
다중 에이전트 AI 숙의의 예비 평가 결과
기존 연구와의 비교 및 한계
결 론
서 론
핵심광물은 이차전지, 반도체, 방위산업 등 첨단산업의 필수 소재로, 그 안정적 확보는 국가 산업경쟁력과 직결된다(IEA, 2024). 그러나 핵심광물의 생산은 소수 국가에 편중되어 있어, 세계 광산 생산에서 코발트는 콩고민주공화국이 약 76%, 니켈은 인도네시아가 약 60%, 희토류는 중국이 약 70%를 차지한다(USGS, 2025). 이러한 생산 편중은 자원보유국의 정책 변화나 국제 분쟁이 곧바로 공급 차질로 이어지는 구조를 만든다. 실제로 인도네시아가 니켈 원광 수출 금지를 예고한 직후 니켈 가격은 이틀 만에 14% 상승하였다(Lim et al., 2021). 중국은 2023년 8월 갈륨·게르마늄을 시작으로 2024년 9월 안티모니, 2025년 2월 텅스텐 등 5개 품목, 같은 해 4월 중·중희토류 7종으로 수출통제를 순차 확대하였는데, 통제 시행 이후 갈륨 가격은 1년 만에 58%, 게르마늄 가격은 2년 사이 약 3배 상승하였다(USGS, 2025, 2026). 또한 2022년 러시아의 우크라이나 침공 직후에 니켈 가격이 이틀 만에 t(ton)당 10만 달러를 넘어서면서 런던금속거래소의 거래가 정지되고 체결 거래가 취소되기도 하였다(Khurshid et al., 2023). 이처럼 광물 공급은 이제 시장 논리만이 아니라 국가 간 경쟁과 정책 수단에 의해서도 좌우된다(Gulley et al., 2018; Kalantzakos, 2020).
광물 수요의 대부분을 수입에 의존하는 한국은 이러한 공급 충격에 취약하며(Bowen, 2023; Deberdt and Park, 2026), 정부는 핵심광물 확보전략(MOTIE, 2023)과 2025년 시행된 국가자원안보 특별법(MOTIE, 2024)을 통해 대응 체계를 갖추어 가고 있다. 그러나 광물별 위험을 판단하는 데 필요한 수급, 무역, 가격, 매장량 자료는 기관별로 나뉘어 발표되고 있어 어떤 광물이 얼마나 위험한지 종합적으로 파악하기 어렵다. 또한 위험이 감지되더라도 그것이 조달과 정책에 미치는 영향을 해석하기 위해서는 공급망, 경제, 지정학 등 여러 분야의 검토가 필요하므로 신속한 대응이 쉽지 않다. 따라서 분산된 자료를 통합하여 위험을 상시 진단하고, 진단 결과의 의미를 해석하여 대응 방향까지 제시할 수 있는 체계가 필요하다.
광물 공급망 위험을 정량적으로 평가하려는 연구는 원료 임계성(criticality) 평가를 중심으로 이루어져 왔다. 임계성이란 특정 광물의 경제적 중요도와 공급위험을 함께 평가하여 그 광물이 얼마나 중요하면서 취약한지를 판정하는 개념으로, 각국이 핵심광물 목록을 지정하는 근거가 된다. Graedel et al.(2015)이 금속 임계성을 공급위험과 취약성 등 다차원으로 평가하는 방법론을 정립한 이래, 평가 방법과 데이터를 종합한 리뷰(Schrijvers et al., 2020; Hayes and McCullough, 2018), 공급 다양성의 측정(Brown, 2018; Thomas et al., 2022), 공급 정량화의 불확실성 평가(McNulty and Jowitt, 2021), 배터리 소재 공급위험과 회복탄력성 평가(Helbig et al., 2018; Liu et al., 2023; Cheng et al., 2024; Wang et al., 2023) 등이 이어졌다. Sun et al.(2021)이 리튬이온배터리 공급망을 대상으로 국가 간 경쟁 관점의 임계성 분석을 제시한 데 이어, 최근 Zhamasheva and Choi(2026)는 여기에 생산 집중도와 정치·경제 안정성을 결합한 전략적 경쟁지수를 제안하고 리튬이온배터리 핵심광물 5종의 국가별 경쟁 구도를 분석하였다. 복합지표의 가중·집계·강건성에 관한 방법론(Greco et al., 2019; Saltelli et al., 2021)도 지수 설계의 준거로 활용되고 있다.
그러나 진단된 위험이 조달과 정책에 무엇을 뜻하는지 해석하는 일은 지수만으로 해결되지 않는다. 같은 위험 신호라도 공급망, 경제, 통상, 지정학 등 분야에 따라 해석이 달라지며, 실제 대응 방안은 이러한 서로 다른 관점을 함께 검토하는 과정에서 도출되기 때문이다. 이는 그동안 각 분야의 전문가들이 담당해 온 영역으로, 시간과 비용이 소요된다는 제약이 있다. 최근 대규모 언어모델(large language model, LLM)의 발전으로 이러한 다관점 검토를 자동화하려는 시도가 이어지고 있다. Du et al.(2024)은 여러 LLM 인스턴스가 서로의 답변을 비판하고 수정하는 과정을 반복할 때 사실성과 추론 정확도가 개선됨을 보였고, 역할을 부여받은 에이전트 간 상호 비판이 단일 모델의 사고 경직을 완화한다는 결과도 보고되었다(Liang et al., 2024). 이와 함께 역할 기반 생성 에이전트의 상호작용(Park et al., 2023)과 다중 에이전트 대화 프레임워크(Wu et al., 2023)가 제시되었다. 다만 이들 연구는 정답이 정해진 과제에서 모델 간 상호작용의 효과를 검증한 것으로, 실측 자료에 근거해야 하는 실무 판단에 그대로 적용하기는 어렵다. 특히 LLM이 근거 없는 사실을 생성하는 환각(hallucination) 문제가 해소되지 않은 상태에서는(Ji et al., 2023), 외부 지식을 결합하여 발언을 실제 자료에 묶어 두는 장치가 함께 요구된다(Lewis et al., 2020).
한편 국내 자원공학 분야에서도 정보기술을 활용한 시스템 개발 연구가 지속적으로 수행되어 왔다. 증강현실·가상현실의 지질자원 분야 활용이 정리되었고(Suh, 2019), 광산 작업자 교육용 증강현실 콘텐츠(Jang et al., 2025), LoRa 기반 노천광산 트럭 모니터링 시스템(Kim et al., 2025), 정보통신기술(information and communication technology, ICT) 모니터링 자료와 타임스터디를 결합한 운반공정 이산사건 시뮬레이션(Jung and Choi, 2026) 등이 개발되었다. 다만 현재까지의 연구는 광산 현장의 장비 운영과 공정 관리에 초점을 두고 있어 공급망 차원의 의사결정을 다루지는 않는다. 즉 위험을 정량화하는 연구와 다관점 검토를 자동화하는 연구는 각각 진행되어 왔으나, 분산된 공공데이터에 기반한 위험 진단과 근거에 기반한 인공지능(artificial intelligence, AI) 토론을 하나의 흐름으로 연결하여 하나의 통합 의사결정 지원 워크플로(workflow)로 구현한 연구는 아직 제한적이다.
본 연구에서는 기관별로 분산된 핵심광물 공공데이터를 통합하고, 공급망 위험을 복합지수(K-RISK)로 진단한 뒤, 감지된 위험을 근거 기반 다중 에이전트 AI 숙의와 연계하여 사용자 유형별 대응 브리핑을 제공하는 위기대응 의사결정 지원 플랫폼을 개발하였다. 본 연구의 목적은 기존 임계성 평가에서 활용되어 온 공급위험 구성요소를 한국의 수입 구조 자료에 맞게 재구성한 위험진단 모듈과, 출처 표기 및 근거자료 제약을 적용한 다중 에이전트 AI 숙의 구조를 하나의 통합 workflow로 연계함으로써 핵심광물 공급망 위기대응을 지원하는 시스템 구조를 제시하는 데 있다. 또한 과거 각 평가시점 기준으로 지수를 재산출하여 이후 가격변동과 대조하는 소급 백테스트(backtesting)와 예비 AI 비교평가를 통해 위험진단 및 다중 에이전트 AI 연계 방식의 구현 가능성과 플랫폼의 주요 기능을 평가하였다.
연구방법
프로토타입 플랫폼 개발
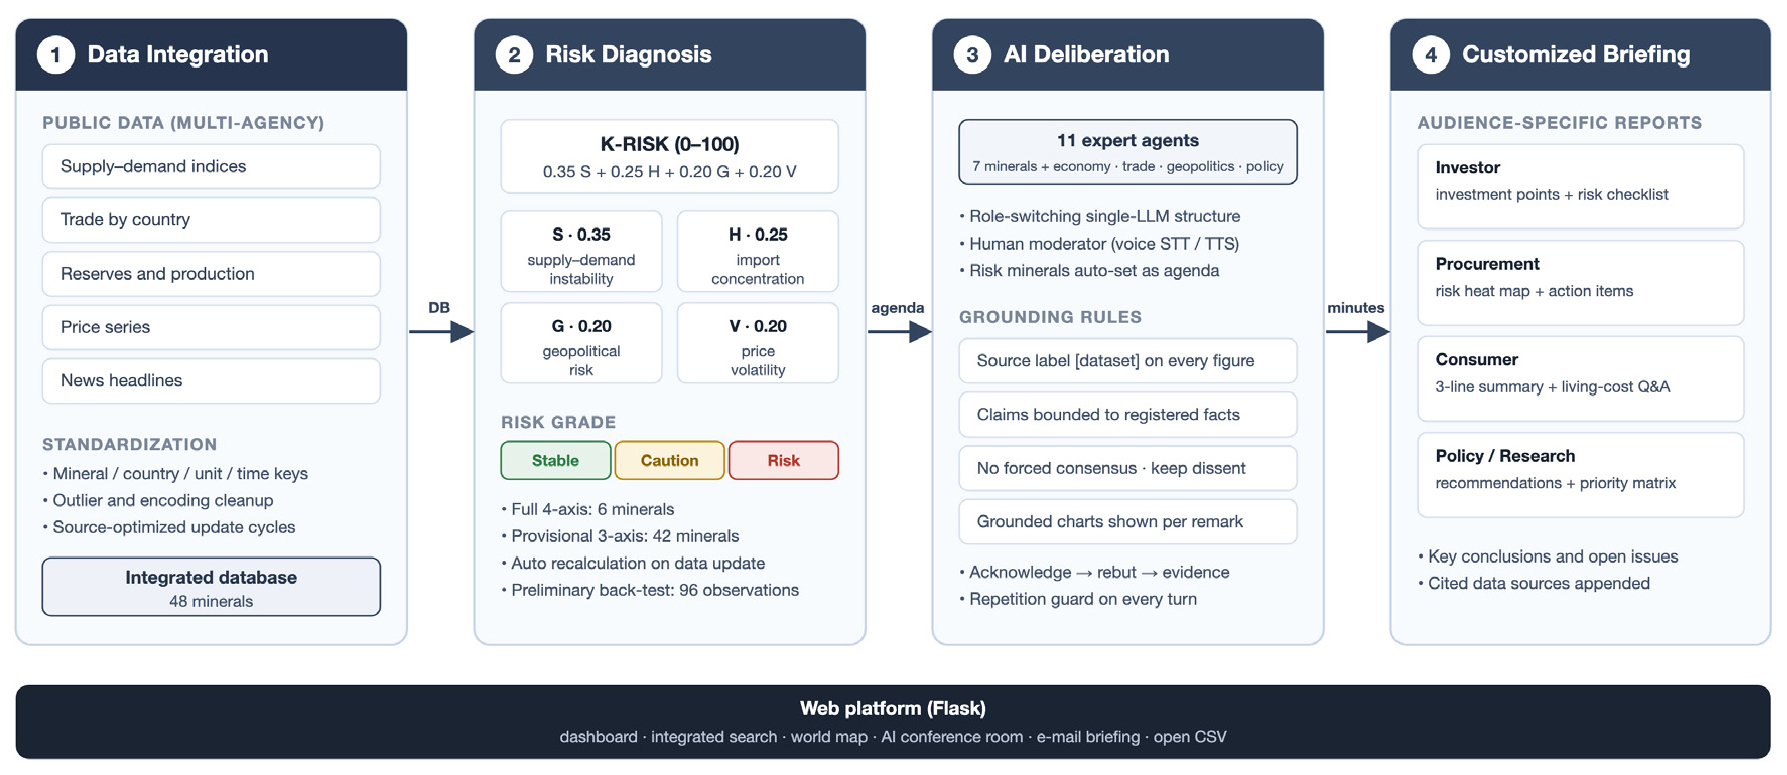
본 연구에서 개발한 플랫폼은 데이터 통합, 위험 진단, AI 숙의 및 맞춤형 브리핑의 4단계로 구성되며, Fig. 1에 전체 구조를 나타냈다. 데이터 통합 단계에서 구축한 통합 데이터베이스는 위험 진단에 사용되고, 진단 단계에서 위험 등급을 받은 광종은 AI 숙의의 회의 안건으로 자동 제안되며, 숙의 결과는 사용자 유형별 브리핑으로 변환된다. 즉 각 단계의 산출물이 다음 단계의 입력으로 연결되는 end-to-end 구조이다. 서버는 Python 기반 웹 프레임워크인 Flask로 구현하였다. 사용자 인터페이스에는 광물별 가격·수급·매장량 정보 조회, 관심광물 설정 및 정기 리포트, 뉴스·이슈 브리핑, 에이전트 간 회의(agent-to-agent, A2A) 설정 및 진행 기능을 배치하였다. 최신 뉴스는 네이버 뉴스 검색 API(application programming interface)로 매시간 수집한 뒤 광물 용어 사전과의 교차 검증과 AI 관련성 판정을 거쳐 브리핑으로 요약되도록 구성하였고, 수입경로 이슈는 주요 해협별로 등록한 키워드로 같은 API를 조회하여 해협 지도 위에 표시하도록 하였다. 관심광물 리포트는 사용자가 설정한 광종 위험 등급과 당일 동향을 담아 매일 오전 9시에 전자메일로 발송되도록 구현하였다.
데이터 수집 및 표준화
데이터 수집에는 한국광해광업공단(Korea Mine Rehabilitation and Mineral Resources Corporation, KOMIR)의 수급안정화지수와 광물가격지수, 관세청 및 KOMIR의 국가별 수출입 실적, 미국 지질조사국(United States Geological Survey, USGS)의 매장량·생산량 통계(USGS, 2025), World Bank의 원자재 가격, 뉴스 검색 API 자료를 사용하였다. 수집·갱신은 각 자료원의 공표 주기에 맞추어 구성하였다. 뉴스는 매시간, 수급안정화지수와 가격지수는 매월, USGS 매장량·생산량 통계는 연 1회 갱신하며, 수출입 실적은 관세청 통계를 전월 확정치 기준으로 매월, KOMIR의 국가별 수출입 통계를 연 단위로 반영하였다(Table 1).
Table 1.
Public data sources used in the platform and their update cycles
기관별로 상이한 데이터는 광종명·국가명·단위·시점의 표준화를 거쳐 광종·국가·시점의 3개 공통키로 결합하였다. 정제 단계에서는 인코딩 오류, 중복 수집, 단위 변환 오류와 같이 자료 자체의 오류로 판별되는 값만 제거하였으며, 실제 공급 충격에 해당할 수 있는 급변값은 제거하지 않았다. 이렇게 구축한 통합 데이터베이스는 총 48개 광종을 포함한다(Fig. 2). 이 가운데 한국 정부가 지정한 핵심광물 33종 중 스트론튬과 팔라듐을 제외한 31종에 중국 수출통제 대상인 게르마늄을 더한 32종은 화면에서 별도로 표시되며, 네 지표값을 모두 산출할 수 있는 광종은 수급안정화지수가 공표되는 6종(리튬·니켈·코발트·동·텅스텐·몰리브덴)이다. 나머지 광종은 수급안정화지수에 기반한 수급불안정 지표(S)를 제외한 세 지표값을 재정규화한 잠정 점수로 제시한다(Table 2). 여기서 잠정 점수 42종은 정부 지정 핵심광물에 한정된 수치가 아니라, 통합 데이터베이스 48종 중 full four-axis K-RISK가 가능한 6종을 제외한 전체 광종을 의미한다. 구축한 데이터베이스는 위험 진단과 AI 숙의의 근거자료로 사용된다.
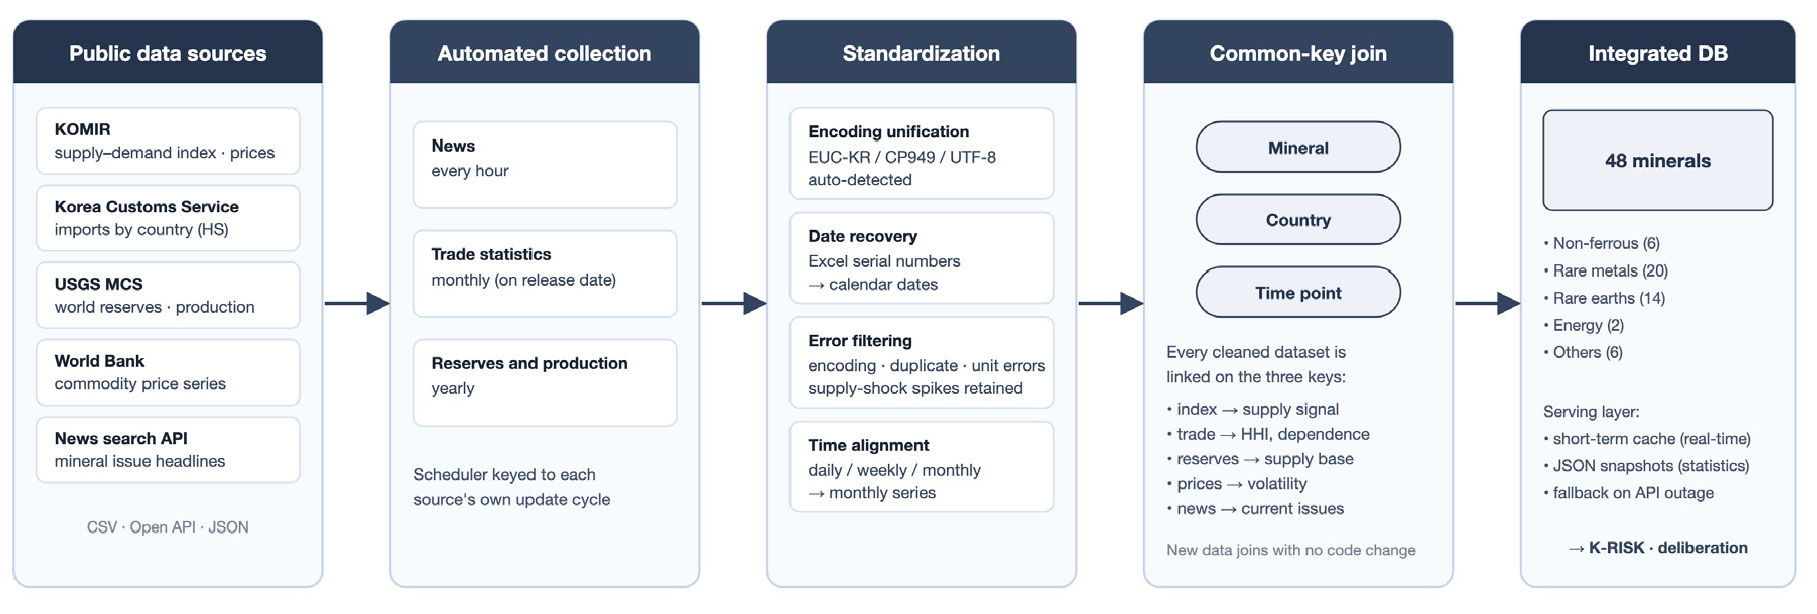
Table 2.
Mineral coverage of the integrated database and the K-RISK index
K-RISK 산출
K-RISK는 기존 원료 임계성 및 공급위험 평가에서 활용되어 온 구성요소를 한국의 수입 구조 자료에 맞게 재구성한 광종별 공급망 위험진단 지수이다. 수급불안정(S), 수입집중도(H), 지정학위험(G), 가격변동성(V)을 나타내는 네 개의 지표 값을 식 (1)과 같이 가중 합산하여 산출하며, Fig. 3에 지수의 구성과 산출 체계를 나타냈다.
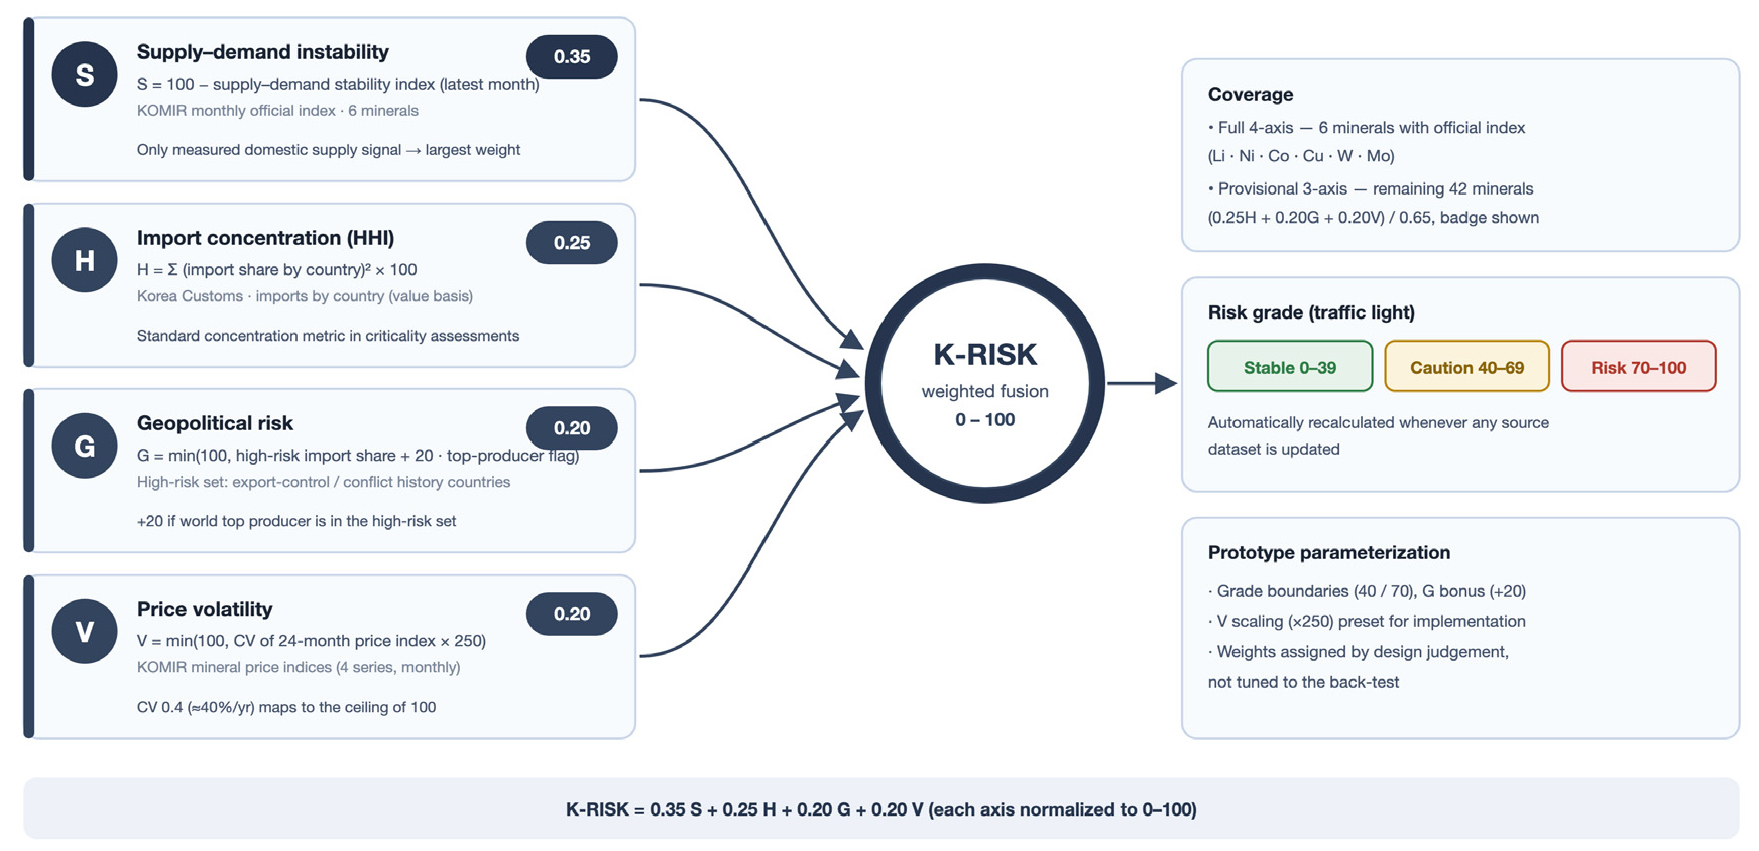
각 지표의 값은 0~100으로 정규화하였다. S는 KOMIR가 매월 공표하는 수급안정화지수(supply–demand stability index, SSI)의 반전값으로 정의하였다.
H는 국가별 수입금액 비중의 허핀달-허쉬만 지수(HHI)로 정의하였다. HHI는 임계성 평가에서 공급 집중도를 측정하는 데 가장 널리 쓰이는 지표이다(Thomas et al., 2022).
여기서 pᵢ는 국가 i의 수입금액 비중이다. 공급국의 정치적 안정성과 정책위험을 함께 고려하는 방식은 기존 임계성 평가에서도 활용되어 왔다(Schrijvers et al., 2020). 본 프로토타입에서는 수출통제 또는 공급망 교란 이력이 상대적으로 빈번한 국가군으로 중국(2023년 이후 갈륨·게르마늄·안티모니·텅스텐·희토류 수출통제), 러시아(2022년 우크라이나 침공에 따른 원자재 공급 교란), 콩고민주공화국(세계 코발트 생산의 약 76% 점유와 수출정책 변동), 미얀마(희토류 원료 공급 중단 사례)를 사전 정의하고(USGS, 2025, 2026; Khurshid et al., 2023), 이들 국가로부터의 수입 비중을 G에 반영하였다. 또한 세계 1위 생산국이 해당 국가군에 속하는 경우 통제 시 대체 조달 여력이 제한된다는 점을 고려하여 20점을 가산하였다.
V는 최근 24개월 광물가격지수의 변동계수(CV)를 스케일링한 값으로 정의하였다. 가격 변동성은 IEA의 핵심광물 공급위험 평가에서도 구성 지표로 사용되고 있다(IEA, 2024). 다만 국제기구의 분석이 가격의 표준편차를 사용하는 것과 달리, 본 연구에서는 가격 수준이 서로 다른 광종을 함께 비교해야 하므로 표준편차를 평균으로 나눈 변동계수를 채택하였다(Helbig et al., 2021).
산출 점수는 안정(0~39)·주의(40~69)·위험(70~100)의 3등급 신호등으로 표시하였다. 등급 경계와 G의 가산점 20점, V의 배율 250은 플랫폼 구현을 위해 사전 설정한 규칙 기반 값이다. 이들 설정값의 최적성을 확정하는 것은 본 연구의 범위에 포함하지 않았으며, 가중치와 등급 경계가 결과에 미치는 영향은 민감도 분석으로 검토하였다.
수급안정화지수가 공표되지 않는 광종에는 S를 제외한 세 지표를 원 가중치의 비율을 유지한 채 재정규화한 잠정 점수를 적용하였다.
잠정 점수는 가장 큰 가중치를 갖는 S를 포함하지 않으므로 네 지표 K-RISK와 구성이 다르며, 두 점수를 같은 순위체계에서 직접 비교하는 데에는 제약이 있다. 두 점수에 같은 등급 경계를 적용한 것은 신호등 표시를 통일하기 위한 것이며, 화면에서는 잠정 점수 광종에 ‘잠정’ 표지와 산출 기준 안내를 함께 두어 두 점수를 구분하였다.
가중치는 각 지표가 위험을 설명하는 성격과 국내 데이터의 직접성을 고려하여 차등 부여하였다. S는 국내 수급 상태를 직접 반영하는 공인 지표이므로 가장 큰 가중치를 두었고, 구조적 위험을 나타내는 H, 위험 촉발 요인을 나타내는 G, 시장에서 관측되는 가격 변동을 나타내는 V 순으로 배분하였다. 본 연구에서는 이 가중치를 플랫폼 구현을 위한 사전 설정값으로 사용하였다(Fig. 3).
근거 기반 다중 에이전트 숙의
다중 에이전트 숙의(multi-agent deliberation)는 서로 다른 관점을 부여받은 AI 에이전트가 앞선 발언과 근거를 검토하고, 필요한 경우 이견을 제시하면서 안건을 다각도로 분석하는 방식이다. 본 플랫폼에서는 이를 A2A 회의 형태로 구현하였다.
전문가 에이전트는 광물 분야 7인(리튬·코발트·니켈·희토류·텅스텐·망간·흑연)과 경제·통상·지정학·정책 분야 4인, 총 11인으로 구성하였으며, 소속과 전문분야, 관점, 근거 자료 및 화법을 직접 작성한 역할 지시문으로 규정하였다(Table 3).
Table 3.
Composition of the expert agents and their grounding datasets
Fig. 4는 안건 제안에서 브리핑 작성까지 다중 에이전트 숙의가 진행되는 절차를 나타낸 것이다. 회의는 사람이 진행자를 맡도록 설정하였다. K-RISK에서 위험 등급을 받은 광종이 안건으로 제안되면 진행자가 참여 전문가를 정하고, 각 턴마다 전문가를 지정하여 발언권을 부여한다. 각 전문가는 앞선 발언과 근거를 검토한 뒤 자신의 관점에서 의견을 제시하며, 회의가 끝나면 서기 에이전트가 회의록을 사용자 유형별 브리핑으로 재구성한다.
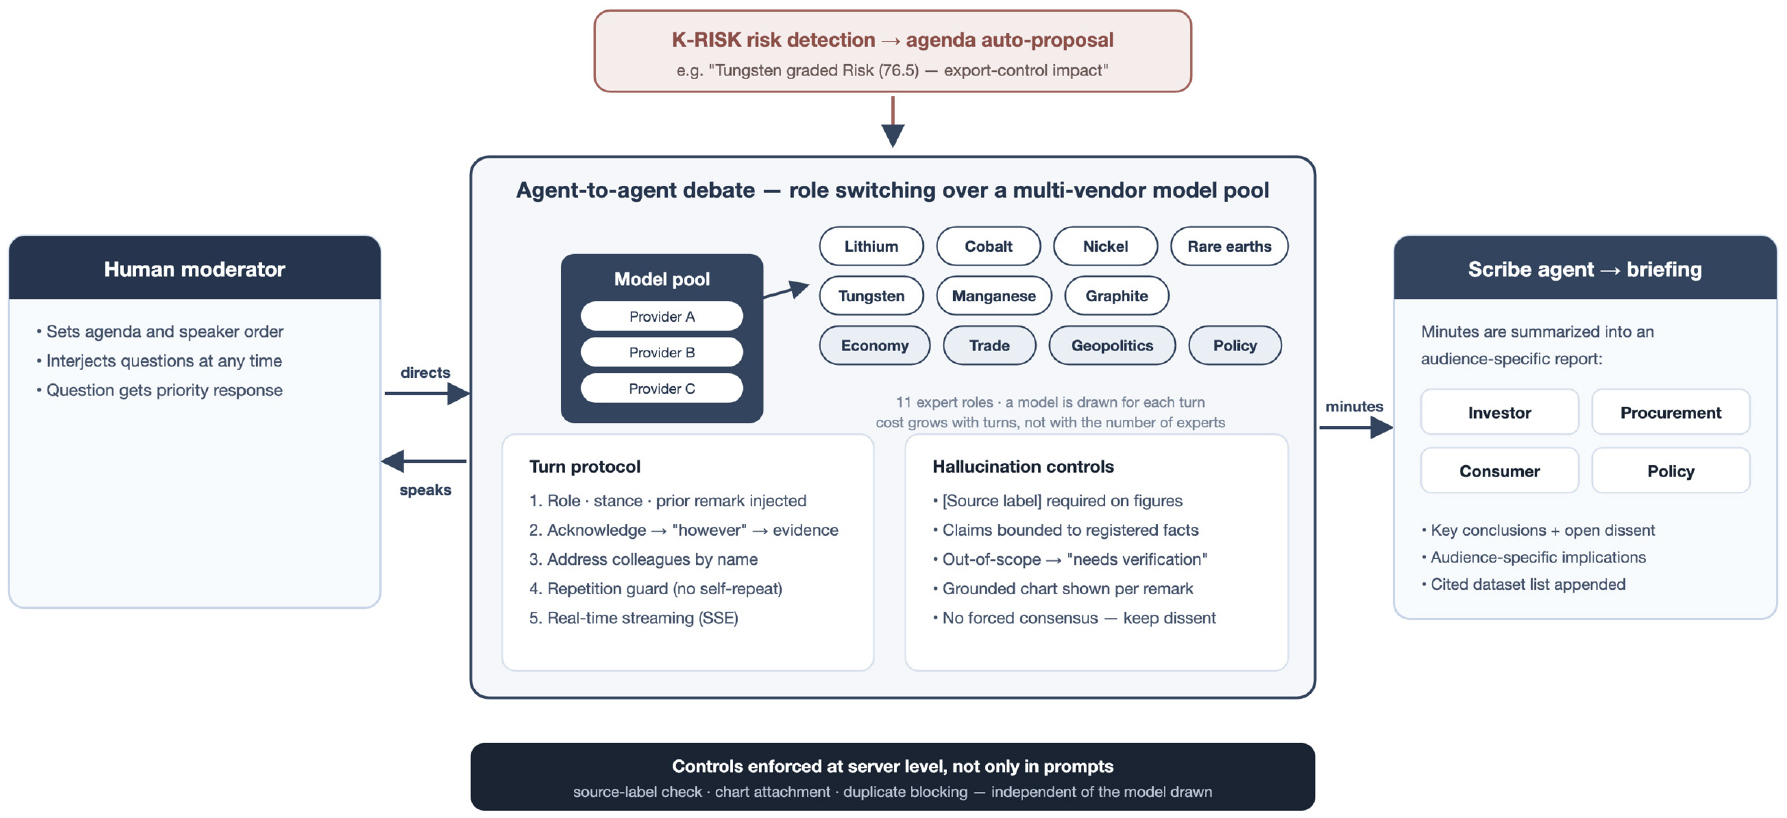
전문가마다 언어모델 인스턴스를 고정적으로 배정하지 않고, 각 발언 시점에 지정된 전문가 역할을 언어모델이 수행하도록 구성하였다. 전문가 역할은 역할 지시문으로 분리되어 있으므로 새로운 전문가를 추가할 때 별도의 모델 구조를 추가할 필요가 없다. 운영 플랫폼에서는 단일 공급사의 모델 성향이 전체 숙의에 고정되는 것을 줄이기 위해 발언마다 여러 공급사의 모델 중 하나를 선택할 수 있도록 구성하였다. 프롬프트는 매 발언마다 새로 조립되며, 공통 규칙, 해당 전문가의 역할 지시문, 회의 안건, 이전 회의록 및 진행자의 지시를 포함한다(Fig. 5).
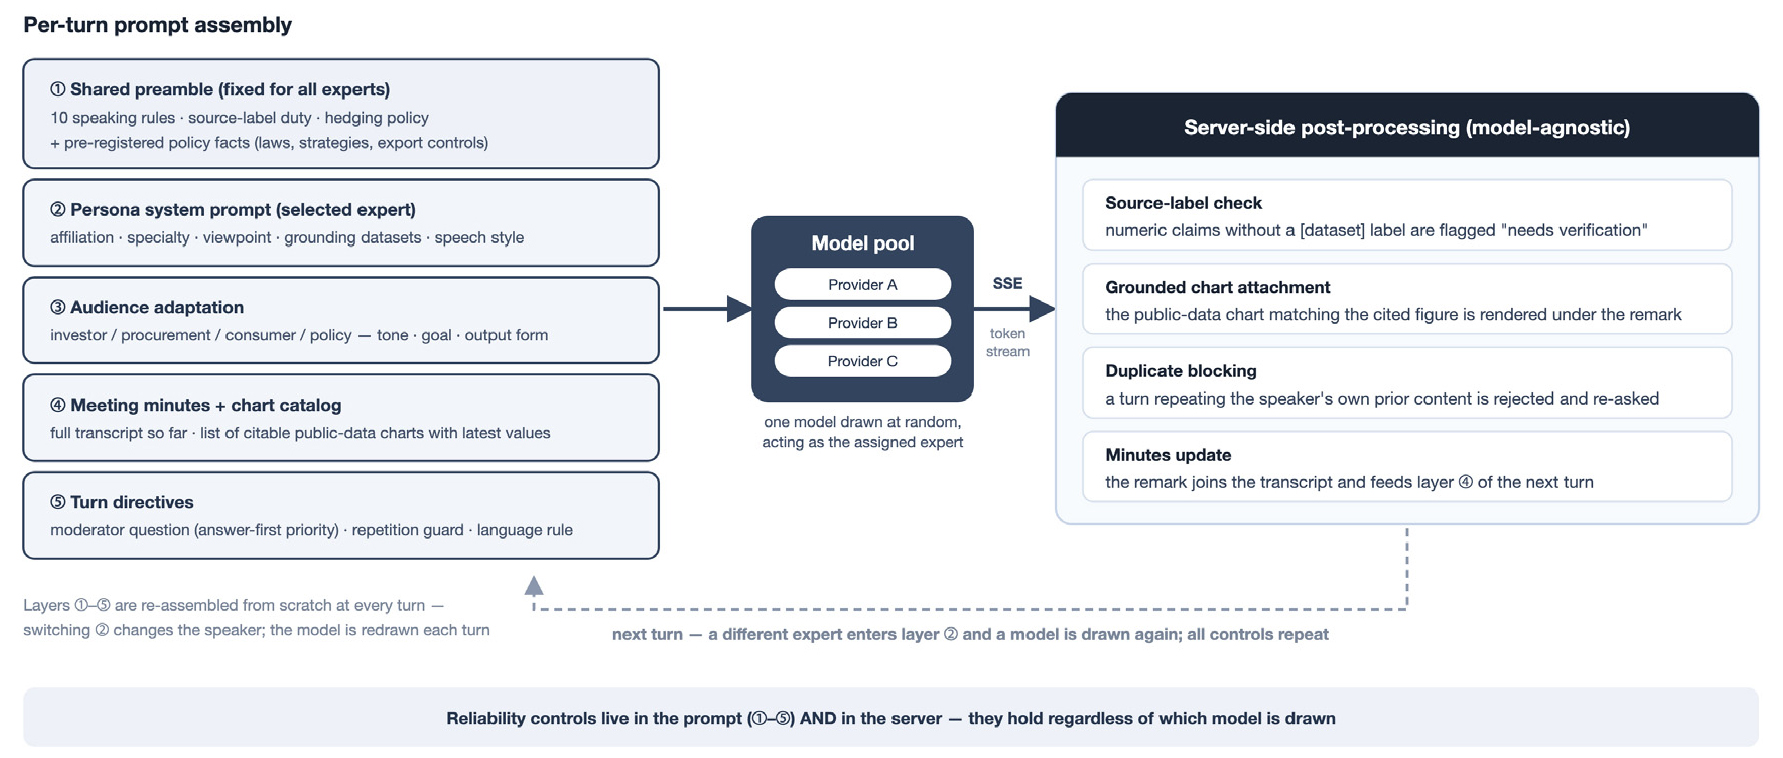
전문가 발언을 근거자료에 연결하기 위해 몇 가지 규칙을 적용하였다. 수치와 검증 가능한 사실에는 문장 끝에 [데이터셋명] 형식의 출처를 표기하도록 하였고, 사전에 등록한 근거자료를 벗어나는 수치는 임의로 생성하지 않고 추가 확인이 필요함을 표시하도록 하였다. 또한 합의를 강제하지 않고 남은 이견을 보존하며, 법령이나 최신 동향과 같이 시점에 민감한 정보는 최신 자료 확인을 권고하도록 하였다. 근거자료에는 국가자원안보 특별법, 핵심광물 확보전략, 수출통제 연표 등 사전에 검토한 정책 사실을 수록하였다. 이러한 규칙은 프롬프트와 서버 로직에 함께 구현하였다. 서버는 출처 없이 제시된 수치 문장을 표시하고, 앞선 내용을 반복하는 발언을 탐지하며, 인용된 수치와 연계된 데이터 차트를 발언과 함께 제시한다. 이에 따라 사용 언어모델이 변경되더라도 플랫폼 수준의 grounding 규칙은 유지될 수 있도록 하였다.
검증 방법
K-RISK의 위험진단 특성은 소급 백테스트 및 주요 사건 사례 분석을 통해 예비적으로 평가하였다. 소급 백테스트는 2021년 1분기부터 2024년 4분기까지 매 분기를 평가 시점으로 설정하고, 평가 시점을 한 분기씩 순차 이동시키며(rolling window approach) 산출한 지수를 이후 기간의 실제 가격 변동과 비교·대조하는 방식으로 수행하였다.
정보의 사전 유출(look-ahead bias)을 방지하기 위해 가격지수 이력(V)과 수급불안정 지표(S)는 각 평가 시점 이전 또는 당해 시점까지 공표된 자료만을 반영하였으며, 평가 시점 이후의 시계열은 입력 변수에서 완전히 제외하였다. 국가별 수입 구조(H, G)는 관세청의 품목별·국가별 수입액 자료를 활용하여 각 평가 시점 직전 12개월(전월 기준) 누적액을 합산하여 산출하였다. 운영 플랫폼은 자료 가용성에 따라 KOMIR 연간자료와 관세청 월별자료를 함께 활용하지만, 소급 백테스트에서는 평가시점 이후 정보의 유입을 방지하기 위해 6개 검증 광종의 H와 G를 관세청 월별자료의 직전 12개월 값으로 일관되게 재구성하였다.
분석 대상은 광물 원료 및 기초소재 단계의 품목으로 한정하였다. 적용된 HS 코드는 리튬(2825.20, 2836.91), 니켈(2604, 7502), 코발트(2605, 8105.20), 텅스텐(2611, 8101.10, 8101.94), 몰리브덴(2613, 8102.10, 8102.94), 전기동(2603, 7403)이다. 다만 본 분석은 현시점에서 가용한 과거 시계열을 기반으로 수행되었으므로, 과거 데이터의 사후 수정 및 정정 내역(data revisions)까지 실시간 공표본 그대로 반영하는 historical vintage를 완전하게 복원하지는 못했다는 한계를 지닌다.
가격 자료로는 KOMIR 광물가격지수의 분기 실측치를 사용하였으며, 분기 t의 가격충격은 식 (7)과 같이 이후 두 개 분기 평균 가격의 기준 분기 대비 변화율의 절댓값으로 정의하였다.
여기서 P(t)는 분기 t의 광물가격지수이다. 본 지수는 가격의 상승·하락 방향 자체를 예측하기보다 이후 큰 시장변동이 나타날 가능성이 높은 광종을 선별하는 위험진단 도구로 설계하였으므로 사후 비교지표로 절대 변화율을 사용하였다.
수급안정화지수가 공표되는 6개 광종과 16개 분기를 조합하여 총 96개 광물-분기 관측을 확보하고 등급별 평균 가격충격을 비교하였다. 또한 가중치와 등급 경계 설정이 결과에 미치는 영향을 확인하기 위해 민감도 분석을 수행하였다. 가중치는 S·H·G를 각각 −0.10, 0, +0.10 조정하고 V를 잔여 가중치로 두되 0.05 미만의 가중치가 생기는 조합을 제외한 23개 조합을, 등급 경계는 하나씩 또는 함께 ±5~10점 이동한 12개 대안을 두고 각각 동일한 백테스트를 반복하였다. 같은 6개 광종을 대상으로 2022년 러시아-우크라이나 전쟁은 2022년 1월, 2026년 미국-이란 충돌은 2026년 1월을 정보 기준시점으로 설정하여, 각 기준시점까지 이용 가능한 자료로 산출한 K-RISK 순위와 이후 가격변동의 순서를 비교하였다. 이 사건 분석은 예측성능을 일반화하기 위한 검증이 아니라 time-cutoff를 적용한 예시적 소급 사례 검토로 사용하였다.
다중 에이전트 AI 숙의는 동일한 질의에 대한 세 조건의 응답을 비교하는 예비실험으로 평가하였다. 조건 A는 역할, 규칙 및 근거자료를 부여하지 않은 단일 언어모델이고, 조건 B는 전문가 역할과 발언 규칙, 근거자료를 적용하되 에이전트 간 숙의는 수행하지 않는 단일 에이전트이며, 조건 C는 전문가 3~5인이 다중 라운드로 숙의하고 서기 에이전트가 최종 내용을 요약하는 구성이다. K-RISK 상·하위 광종과 사건 사례를 소재로 네 가지 사용자 유형에 걸쳐 20개 질의를 구성하고, 각 질의를 조건별로 3회 반복하여 조건당 60개, 총 180개 응답을 생성하였다. 운영 플랫폼은 다중 공급사 모델을 선택할 수 있도록 구현하였으나, 본 비교실험에서는 모델 간 차이를 배제하기 위해 세 조건 모두 동일한 언어모델(OpenAI GPT-5.4-mini)로 고정하였고, temperature 등 생성 설정은 API 기본값을 사용하였고, reasoning 옵션은 별도로 활성화하지 않았다. 발언 생성 상한은 조건 A와 B에서 1200토큰, 조건 C의 개별 발언은 운영 플랫폼의 발언 생성 설정과 동일한 700토큰으로 두었다. 실험은 2026년 8월 11일에 모든 조건을 동일한 설정으로 일괄 수행하였으며, 각 응답은 질의·반복 간에 문맥을 공유하지 않는 독립적인 API 호출로 생성하였다(조건 C는 하나의 회의 안에서만 회의록이 누적된다). 응답마다 사용 모델과 입출력 토큰 수를 기록하였다. 실제 토큰 생성량은 조건 A가 응답당 평균 891토큰, 조건 B가 718토큰이었으며, 조건 C는 회의당 평균 9턴으로 진행되어 평균 총 6,157토큰(발언당 평균 684토큰)이 생성되었다. 따라서 조건 간 총 생성량의 차이가 관점 커버리지에 영향을 미쳤을 가능성을 배제할 수 없으며, 본 비교 결과는 다중 에이전트 숙의의 독립적인 효과라기보다 예비적인 경향으로 해석할 필요가 있다. 또한 프롬프트와 숙의 구조 자체의 차이를 관찰하기 위해 실험 실행기를 운영 서버에 경유하지 않는 독립 스크립트로 구성하였고, 이에 따라 서버 측 출처 강제 및 후처리 기능은 적용되지 않았다.
식 (8)의 C는 수치 또는 검증 가능한 사실을 언급한 문장 중 출처가 표기된 문장의 비율이고, 식 (9)의 V(cov)는 질의별로 사전에 정의한 논점 체크리스트 중 실제 응답에서 다루어진 논점의 비율이다. 다만 C는 출처 표기 여부만을 평가하는 지표로, 인용된 자료가 해당 문장을 실제로 뒷받침하는지(근거 일치도)를 검증하지는 않는다. 출처 표기율은 문장 단위 규칙으로 자동 산출하였고, 관점 커버리지는 논점 체크리스트를 제시한 언어모델 심판을 이용하여 판정하였다. 따라서 본 실험은 운영 플랫폼 전체의 최종 성능이 아니라 grounding과 다중 에이전트 숙의 구조가 응답의 근거 추적성과 관점 범위에 미치는 경향을 확인하는 데 목적을 두었다.
연구결과 및 고찰
프로토타입 플랫폼 구현 결과
개발한 플랫폼은 통합 데이터 조회와 K-RISK 자동 재계산을 중심으로 가격·매장량·수급정보와 관심광물 모니터링 기능을 제공한다. 또한 뉴스·이슈 브리핑, 다중 에이전트 숙의 및 사용자별 브리핑 생성 기능을 연계하여 위험 탐지에서 해석과 정보 전달까지의 workflow가 하나의 웹 환경에서 수행되도록 구현하였다. Fig. 6(a)는 플랫폼 메인 화면으로 현재 기준의 위험·주의 광종 수와 수급안정화지수, 금속 시세 등 대표 지표를 한 화면에 제시하며, Fig. 6(b)는 K-RISK 진단 화면으로 광종별 점수와 등급, 산출식 및 자료 출처를 함께 표시한다. 본 연구에서는 이러한 기능들이 하나의 연속적인 의사결정 지원 workflow로 연결되는지를 중심으로 구현 결과를 제시하였다.
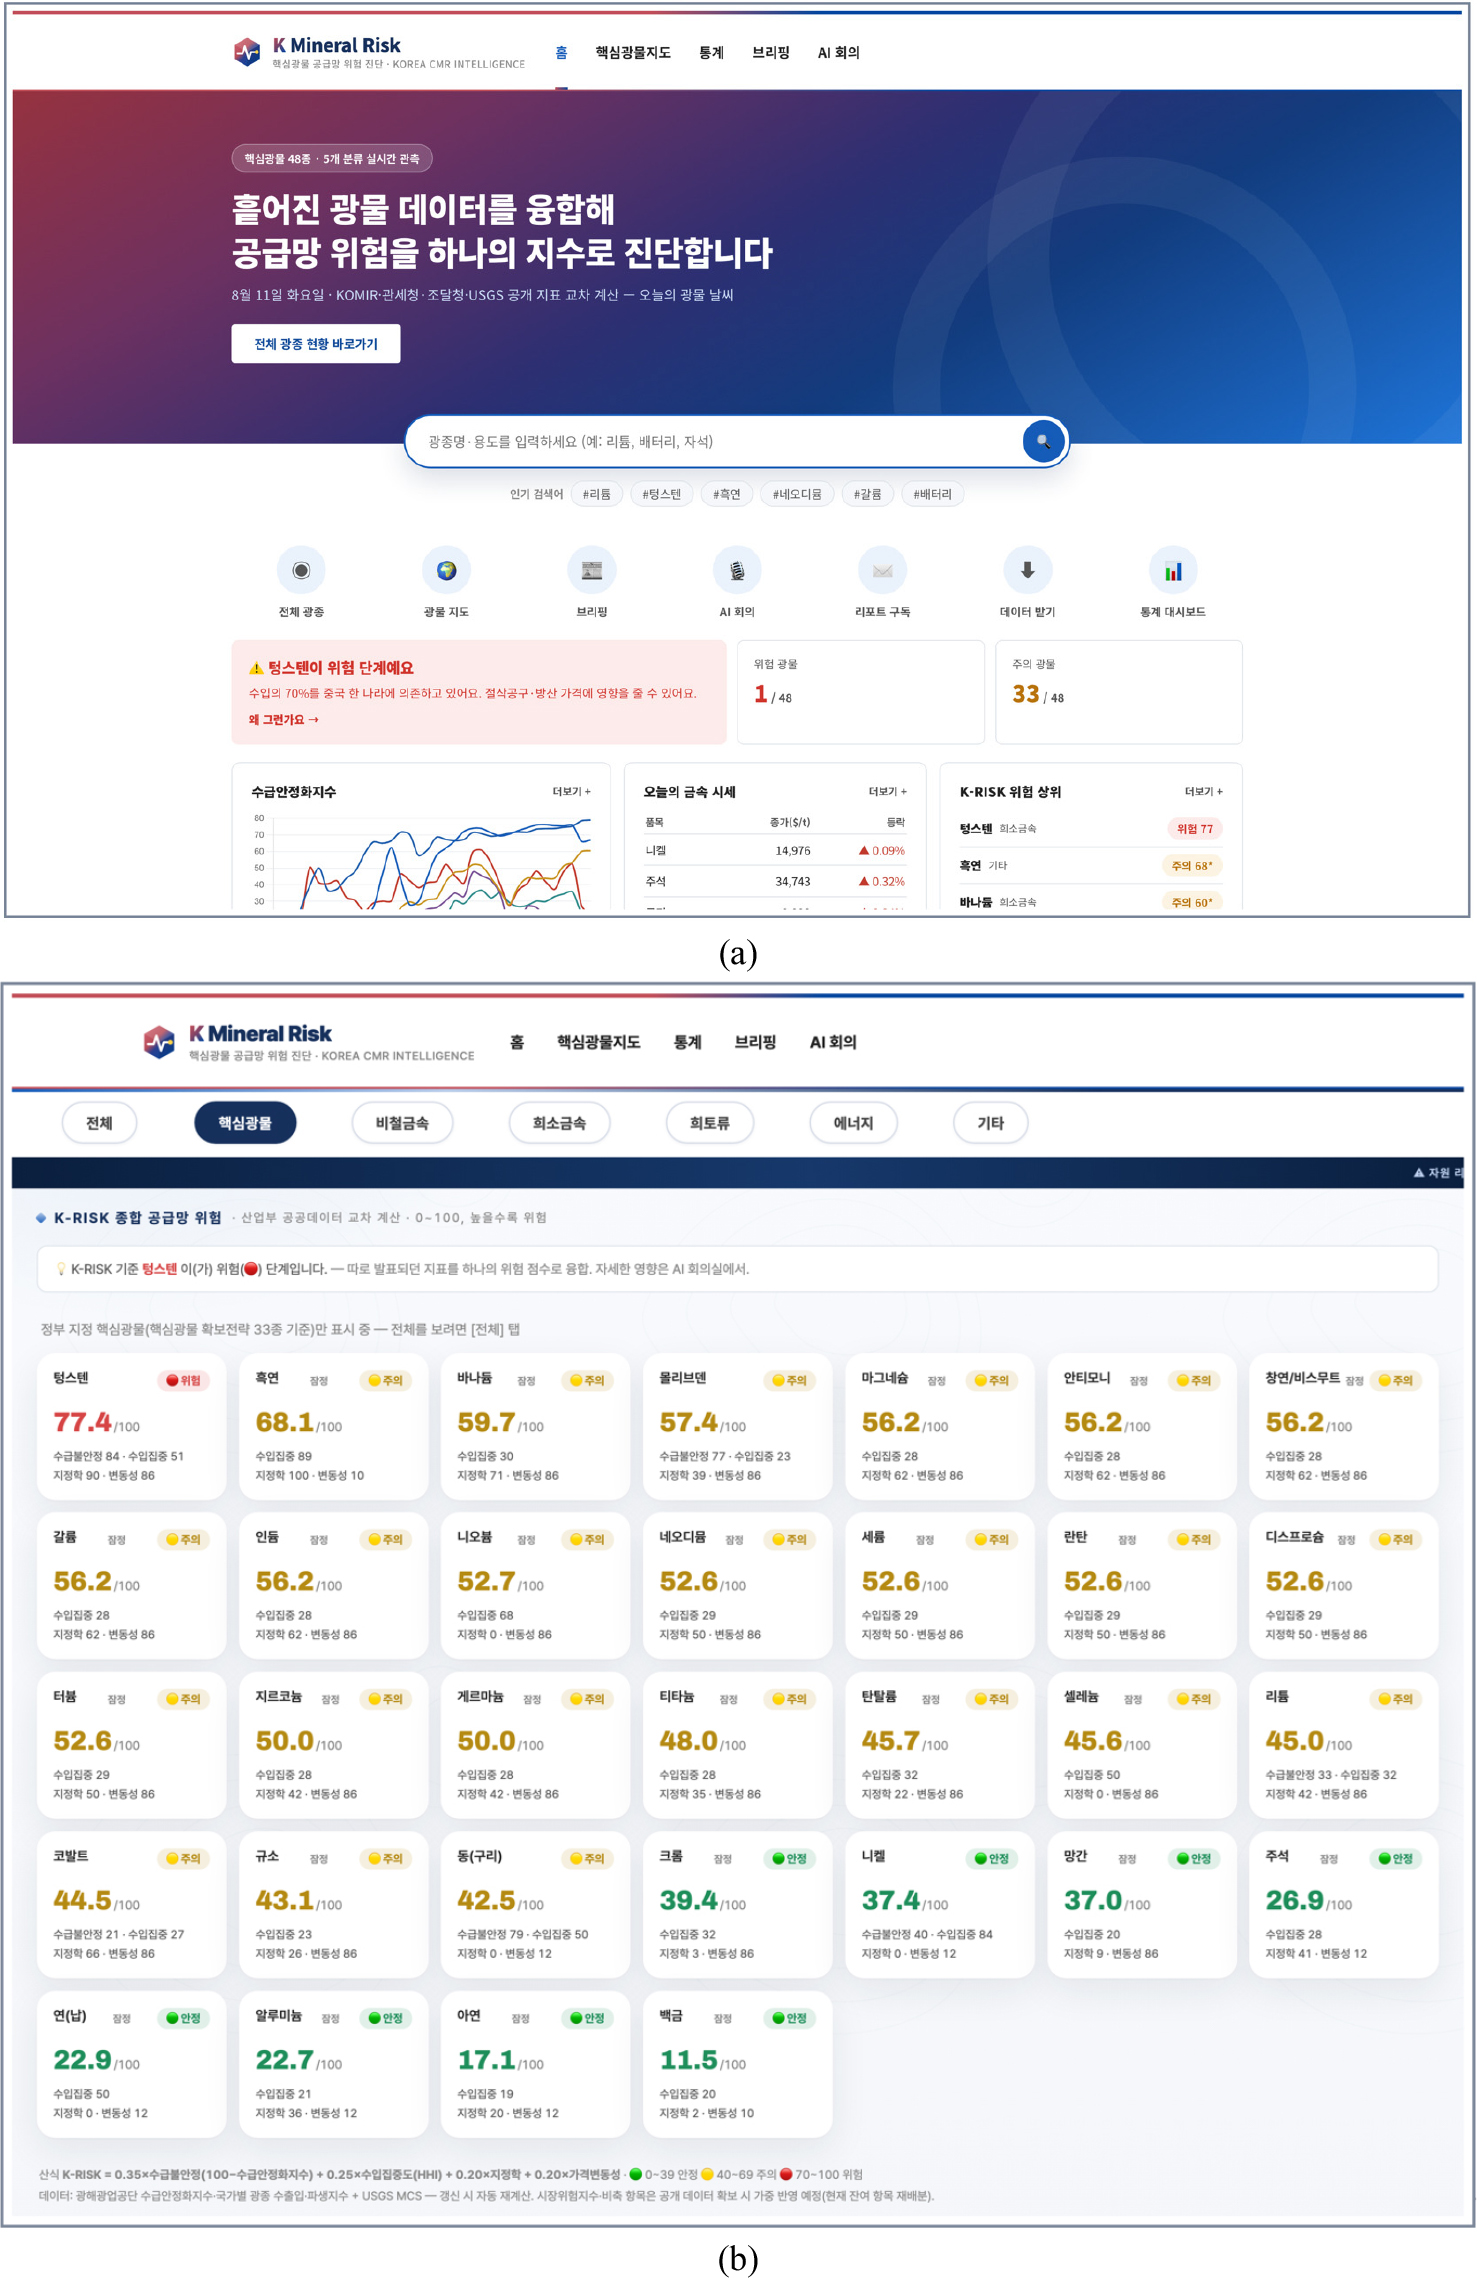
Fig. 6.
K-Mineral RISK platform: (a) main page with the current risk summary and key indicators; (b) risk diagnosis screen showing K-RISK scores and grades for 31 of the 33 minerals designated as critical by the Korean government plus germanium; provisional three-axis scores carry a separate label on each card.
플랫폼의 정보조회 기능은 가격지수와 가격 추이, 국가별 매장량 등 광물별 기초정보를 제공하고, 사용자가 관심광물을 선택하여 개인화된 모니터링 목록을 구성할 수 있도록 구현하였다. 관심광물은 별도의 리포트로 정리되며 지정된 시각에 전자메일로 전달할 수 있도록 구성하였다. 이와 함께 최신 뉴스 브리핑과 광물별 수입루트에 연계된 해상운송 이슈 브리핑을 제공하여 정량지표만으로 파악하기 어려운 공급망 이슈를 함께 확인할 수 있도록 하였다. 주요 구현 기능과 사용자 출력은 Table 4에 정리하였으며, 대표적인 모니터링 및 개인화 기능의 화면 예시는 Fig. 7에 나타냈다.
Table 4.
Functional modules implemented in the research prototype platform and their representative outputs
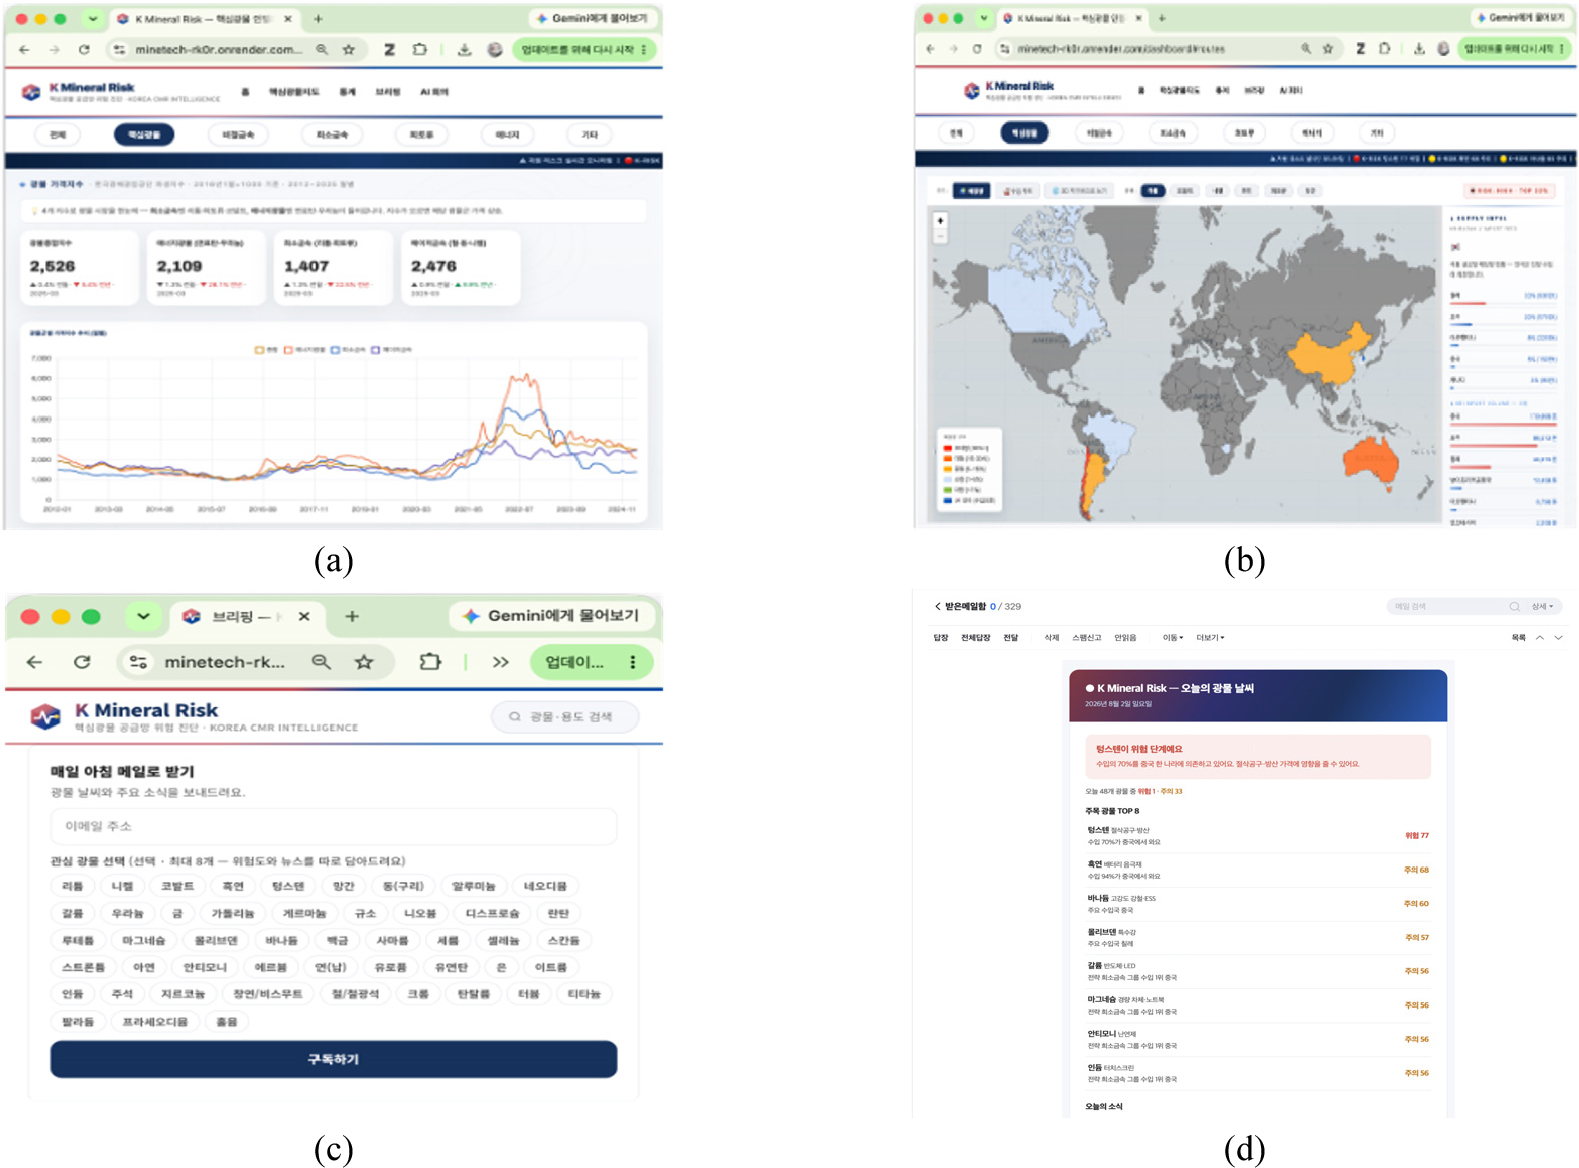
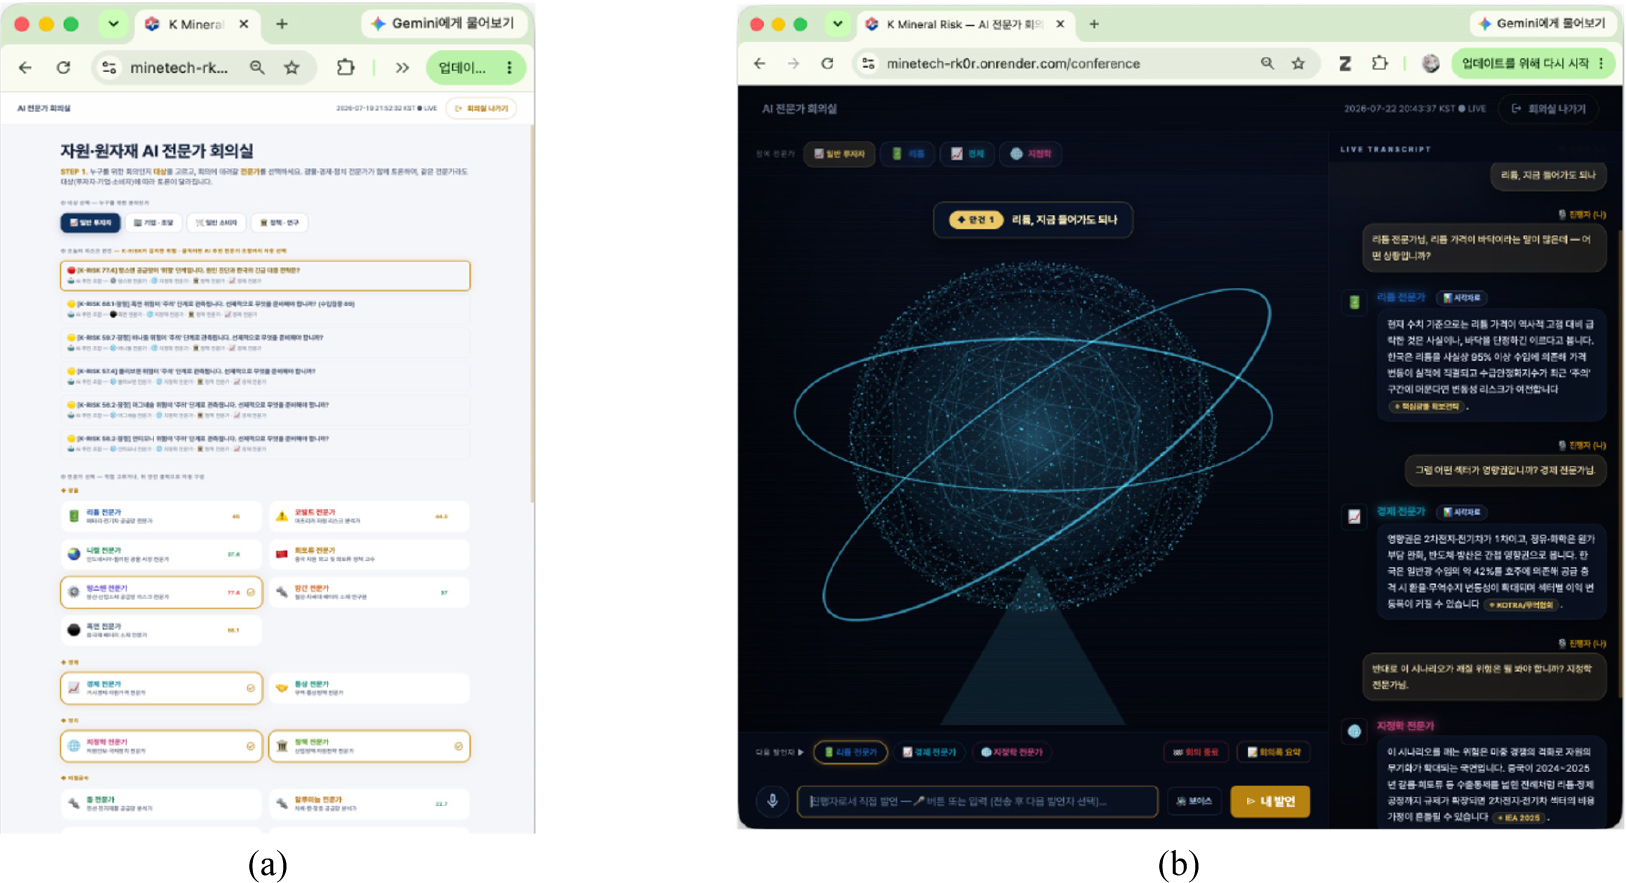
위험진단 결과는 별도의 분석화면에 머무르지 않고 A2A 숙의 단계의 입력으로 전달되도록 구현하였다. 사용자는 회의 설정 화면에서 사용자 유형과 토론 유형을 선택할 수 있으며, 시스템은 K-RISK 상위 광종과 관련된 안건을 제안하고 선택된 안건에 적합한 분야별 전문가 에이전트를 추천한다. 회의가 시작되면 A2A 인터페이스에서 전문가 발언 기록, 중심 숙의 화면, 사용자 입력 및 음성 출력 제어를 함께 제공한다(Fig. 8). 이 구조를 통해 위험등급 확인에서 안건 설정, 전문가 구성, 숙의 실행까지의 사용자 workflow를 하나의 프로토타입에서 연결하였다.
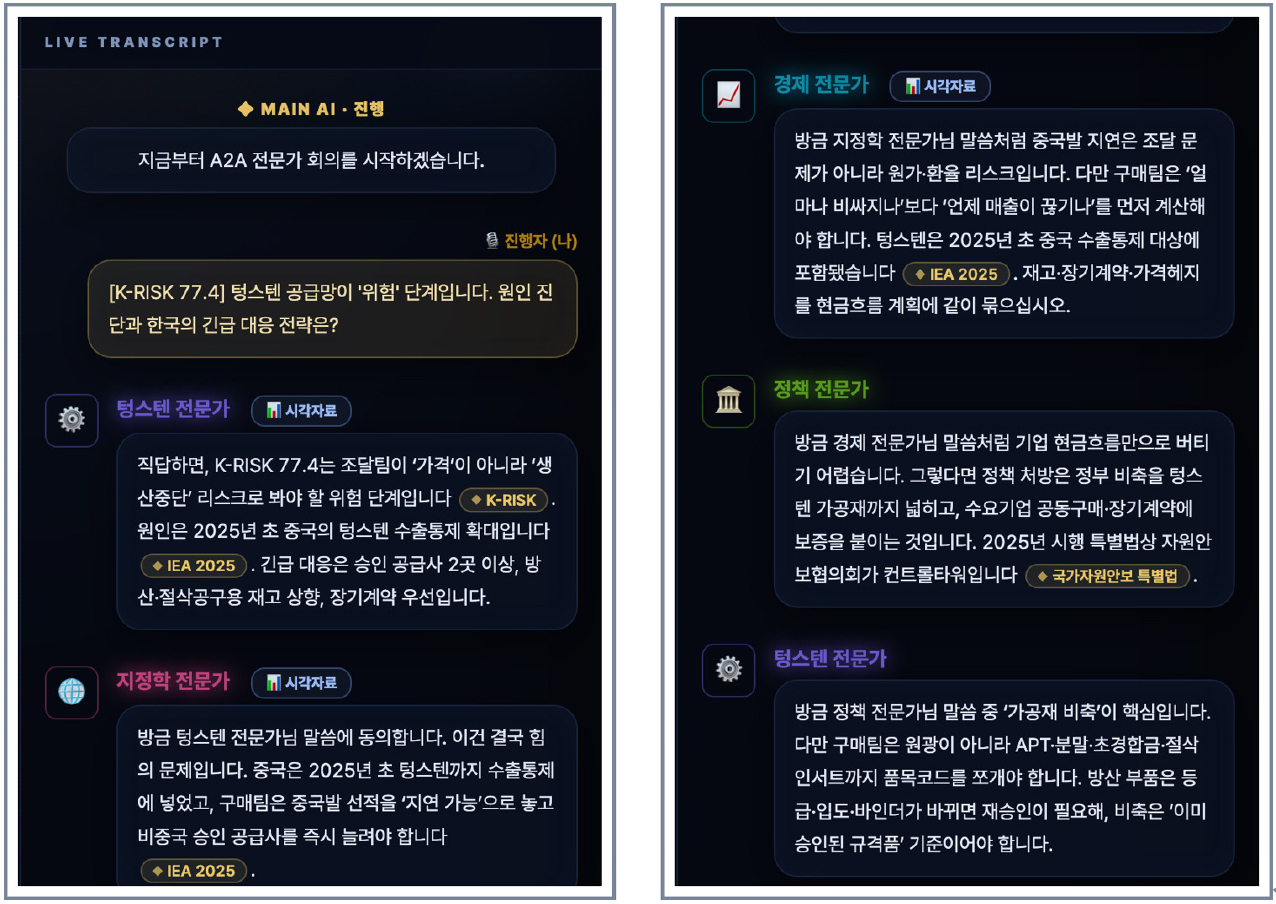
텅스텐을 예로 들면, 관세청 수출입 실적과 KOMIR 가격지수가 갱신되면 관련 입력자료를 반영하여 K-RISK가 다시 계산된다. 텅스텐이 위험 등급으로 분류되면 해당 광종은 회의 안건으로 제안되고, 회의에서는 광물·경제·통상·지정학·정책 관점의 전문가 에이전트가 순차적으로 발언한다. 각 발언은 앞선 논점과 근거를 검토한 뒤 해당 전문가의 관점을 추가하는 방식으로 이어지며, 수치 또는 검증 가능한 사실에는 출처가 표기된다(Fig. 9). 회의가 끝나면 서기 에이전트가 토론 기록을 투자자, 기업 조달 담당자, 소비자, 정책·연구자 등 사용자 유형에 맞는 브리핑으로 재구성한다.
K-RISK 검증 결과
소급 백테스트 결과, 사전에 부여한 위험 등급이 높을수록 이후 6개월의 평균 절대 가격변동이 증가하는 경향이 나타났다. 등급별 평균 변동은 안정 8.6%, 주의 17.3%, 위험 26.4%였으며, 위험 등급으로 분류된 12건 중 8건이 10% 이상의 절대 가격변동을 보였다(Table 5). K-RISK 점수와 이후 절대 가격변동 사이의 Spearman 순위상관계수는 0.19로 약한 양의 상관을 나타냈다. 다만 동일 광종의 반복 관측과 중첩된 평가기간이 포함되어 있으므로 본 결과는 통계적 일반화보다 예비적인 경향 확인에 의미를 두었다.
Table 5.
Retrospective back-test results: mean post-6-month absolute price change by K-RISK grade (96 mineral-quarter observations, 2021Q1–2024Q4)
| Pre-assigned grade | n | Mean |price change| (%) | Share of shocks > 10% (%) |
| Stable (< 40) | 20 | 8.6 | 35.0 |
| Caution (40–69) | 64 | 17.3 | 51.6 |
| Risk (70+) | 12 | 26.4 | 66.7 |
가중치와 등급 경계에 대한 민감도 분석 결과를 Table 6에 정리하였다. 채택 가중치의 순위상관계수는 균등 가중과 거의 같았고, 가중치를 섭동한 대부분의 조합과 경계를 이동한 대안 대부분에서 등급별 평균 가격변동의 증가 경향이 유지되었다. 반면 수급불안정 지표만으로는 순위상관이 크게 낮아지고 등급 간 증가 경향도 나타나지 않았다. 이러한 결과는 본 분석자료 범위에서 관찰된 등급별 가격변동의 증가 경향이 특정 단일 가중치나 등급 경계 설정에만 의존하지 않음을 시사한다.
Table 6.
Sensitivity of the back-test results to the K-RISK weights and grade boundaries
| Setting | Spearman ρ | n (Stable/Caution/Risk) | Mean |price change| (%) (Stable/Caution/Risk) | Monotonic increase |
|
Adopted weights 0.35 / 0.25 / 0.20 / 0.20, boundaries 40 / 70 | 0.194 | 20 / 64 / 12 | 8.6 / 17.3 / 26.4 | Yes |
| Equal weights 0.25 × 4 | 0.204 | 29 / 55 / 12 | 11.2 / 17.3 / 26.4 | Yes |
| S only | 0.063 | 14 / 27 / 55 | 13.8 / 18.8 / 16.3 | No |
|
Weights perturbed by ±0.10 (23 combinations) | 0.140–0.297 (median 0.196) | - | - | 21 of 23 |
| Grade boundaries shifted by ±5–10 points (12 alternatives) | 0.194 | - | - | 9 of 12 |
사건 사례에서도 유사한 경향이 관찰되었다. 2022년 1월과 2026년 1월을 각각 정보 기준시점으로 설정하여 해당 시점까지 이용 가능한 자료만으로 K-RISK를 산출한 결과, 두 사례 모두 사전 위험순위가 높은 일부 광종에서 이후 상대적으로 큰 가격변동이 나타났다. 그러나 사건 수와 분석 광종이 제한적이므로 이 결과는 예측성능의 근거가 아니라 time-cutoff 기반 소급 사례로 해석하였다.
다중 에이전트 AI 숙의의 예비 평가 결과
세 조건의 응답을 비교한 결과, 출처 표기율과 관점 커버리지는 조건 A에서 B, C로 갈수록 단계적으로 증가하였다(Table 7). 검증 가능한 수치·사실 문장 중 출처가 표기된 비율은 조건 A에서 0.0%, 조건 B에서 13.1%, 조건 C에서 23.0%였고, 사전에 정의한 논점 체크리스트의 커버리지는 각각 66.8%, 81.9%, 90.5%였다. 조건 C에서는 다중 에이전트 회의 종료 후 서기 에이전트가 생성한 최종 요약 응답을 평가 대상으로 사용하였다. 이 비교에서는 운영 플랫폼의 서버 측 출처 강제 기능을 비활성화하였으므로, 23.0 %라는 값은 실제 운용환경에서의 최종 출처 표기율을 의미하지 않는다. 따라서 본 결과는 프롬프트 기반 grounding과 다중 에이전트 숙의 구조를 적용한 조건에서 서버 후처리 이전 단계의 효과를 관찰한 것으로 해석하였다.
Table 7.
Preliminary evaluation of the three conditions (n = 60 responses per condition)
| Metric | A·Plain LLM | B·Grounded single | C·Full deliberation |
| Source-citation rate C (%) | 0.0 | 13.1 | 23.0 |
| Viewpoint coverage V_cov (%) | 66.8 | 81.9 | 90.5 |
역할과 근거자료를 제공한 조건에서 응답이 다루는 논점의 범위가 넓어졌고, 다중 에이전트 숙의를 적용한 조건에서는 출처 표기와 관점 커버리지가 추가로 증가하는 경향이 관찰되었다. 조건 B는 조건 A보다 평균 생성 토큰 수가 적었음에도 더 높은 관점 커버리지를 보였으므로, A와 B 사이에서 관찰된 차이를 단순히 생성 분량의 증가만으로 설명하기는 어렵다. 다만 조건 C는 다중 라운드 숙의 구조로 인해 조건 A와 B보다 총 생성 토큰 수가 많았으므로, 조건 B에서 C로의 관점 커버리지의 증가는 다중 에이전트 상호작용 효과뿐 아니라 응답 생성량의 차이에 영향을 받았을 가능성이 있다. 따라서 본 비교 결과는 설계요소별 독립적인 효과를 검증한 결과가 아니라 경향의 확인으로 해석하였다.
기존 연구와의 비교 및 한계
기존 연구와 비교할 때 본 연구의 주된 기여는 개별 위험지수나 다중 에이전트 기법의 우월성을 제시하는 데 있기보다, 데이터 통합-위험진단-근거 기반 숙의-맞춤형 브리핑을 하나의 연속적인 의사결정 지원 workflow로 구현한 데 있다. 기존 임계성 연구에서 활용되어 온 공급위험 구성요소(Graedel et al., 2015; Zhamasheva and Choi, 2026)를 자료 갱신에 따라 재산출되는 위험진단 모듈로 구성하고, 다중 에이전트 상호작용 연구(Du et al., 2024; Liang et al., 2024)의 구조를 실측 공공데이터와 사전 검토된 정책 사실에 연결하였다. 특히 위험진단 결과가 회의 안건을 생성하고, 에이전트별 근거가 사용자 유형별 브리핑으로 이어지도록 구성함으로써 위험정보의 탐지와 해석을 하나의 플랫폼 안에서 연결하였다.
다만 본 연구에는 몇 가지 한계가 있다. K-RISK의 네 지표값을 모두 산출할 수 있는 광종은 수급안정화지수가 공표되는 6종이며, 나머지 광종에는 S를 제외한 잠정 점수를 적용하였으므로 두 점수를 엄밀하게 비교하는 데에는 제약이 있다. 가격지수가 4개 계열로만 공표되고 일부 무역통계가 품목군 단위로 제공되므로, 같은 계열과 품목군에 속한 광종은 V 또는 H·G 값을 공유하여 점수가 같아질 수 있다. 백테스트는 96개 광물-분기 관측으로 제한되고 위험 등급은 12건에 불과하며, 그마저 리튬과 텅스텐 두 광종에 집중되어 있고 동일 광종의 반복 관측과 중첩된 평가기간이 포함되어 있어 통계적 일반화에는 한계가 있다. 또한 가중치와 등급 경계의 영향은 민감도 분석으로 검토하였으나, G의 가산점과 V의 배율은 플랫폼 구현을 위한 사전 설정값이므로 향후 강건성 및 불확실성 분석이 필요하다.
AI 및 플랫폼 평가에도 한계가 있다. 다중 에이전트 숙의 평가는 20개 질의와 제한된 반복을 이용한 예비실험이며, 관점 커버리지 일부가 언어모델 심판에 의해 평가되었다. 발언 생성 상한이 낮아 조건 A의 응답 일부가 상한에서 잘렸으므로, 상한을 높이면 조건 A의 관점 커버리지가 달라질 가능성이 있다. 또한 개발된 시스템은 연구용 프로토타입이므로 실제 기관·기업 환경에서의 장기간 운용 안정성, 사용자 경험 및 업무효과는 별도의 현장 평가가 필요하다.
결 론
본 연구에서는 기관별로 분산된 핵심광물 공공데이터를 통합하여 K-RISK로 공급망 위험을 진단하고, 감지된 위험을 근거 기반 다중 에이전트 AI 숙의와 사용자 유형별 브리핑으로 연결하는 의사결정 지원 플랫폼을 개발하였다. 제한된 소급자료를 이용한 예비 백테스트에서는 위험 등급이 높을수록 이후 6개월의 평균 절대 가격변동이 증가하는 경향이 나타났고, 두 건의 시간기준 소급 사례에서도 유사한 순위 경향이 관찰되었다. 또한 예비 AI 비교에서는 근거 기반 단일 에이전트와 다중 에이전트 숙의 구성에서 일반 대규모 언어모델보다 출처 표기율과 관점 커버리지가 높게 나타났다.
본 연구의 의의는 기존 공급위험 지표를 자료 갱신에 따라 재산출되는 진단 모듈로 구현하고, 그 결과를 실측 공공데이터와 정책 사실에 근거한 다중 에이전트 숙의로 연결하여 위험 탐지부터 대응 검토까지의 workflow를 하나의 플랫폼에서 제시했다는 데 있다. 다만 본 연구의 결과는 K-RISK의 예측력을 확정하거나 다중 에이전트 숙의의 우월성을 일반화한 결과가 아니라, 제한된 자료와 예비실험 범위에서 통합 접근의 구현 가능성과 활용 가능성을 검토한 것으로 해석하는 것이 적절하다.
향후 연구에서는 첫째, K-RISK의 분석기간과 대상 광종을 확대하고 가중치·구성요소·등급 경계의 강건성과 불확실성을 체계적으로 검증할 필요가 있다. 둘째, 다중 에이전트 AI는 생성량을 통제한 조건 비교와 인용 정확성·근거 일치도에 대한 인간 전문가 평가를 통해 근거 추적성, 관점의 포괄성, 의사결정 유용성 및 재현성을 보다 엄밀하게 평가할 필요가 있다. 이러한 후속 연구를 통해 핵심광물 공급망 의사결정 지원 체계를 보다 신뢰성 높은 자원안보 정보시스템으로 발전시킬 수 있을 것이다.