

서 론
연구 방법
연구대상 광산 및 자료 구성
AI 지원 하이브리드 계획 프레임워크 설계
과거 작업자료를 이용한 입력조건 재구성
평가대상 선정 및 비교실험
계획 유사도 평가방법
연구 결과
AI 지원 하이브리드 계획 프레임워크의 배차계획 생성 결과
작업자 사전 배차계획과 프레임워크 생성계획의 정량적 비교
대표적인 고·저운반량 유사도 사례 비교
토 의
결 론
서 론
노천광산에서 생산된 광석은 굴착, 적재 및 운반과정을 거쳐 파쇄시설이나 저장시설로 이동하며, 이 과정에서 로더와 트럭의 효율적인 배치는 광산의 생산성과 운영효율에 직접적인 영향을 미친다(Choi, 2017; Choi, 2018). 특히 일일 배차계획을 수립할 때에는 작업 가능한 구역의 위치와 품위, 장비의 가용상태, 운반거리, 목표 생산량 등 다양한 운영정보와 계획조건을 함께 고려해야 한다. 이러한 조건은 시간에 따라 변화할 수 있으므로, 실제 광산에서는 현장 운영정보와 작업자의 경험을 종합하여 작업구역과 장비배치 및 운반량을 결정한다.
광산의 운반 및 생산계획을 지원하기 위해 수리계획법, 시뮬레이션 및 인공지능을 활용한 다양한 연구가 수행되어 왔다. Noriega and Pourrahimian(2022)은 노천광산의 전략적 계획에서 활용되는 인공지능 및 데이터 기반 접근법을 체계적으로 검토하였으며, 생산계획 및 스케줄링, 장비관리 및 품위관리 등의 분야에서 다양한 방법이 활용되고 있음을 제시하였다. Manríquez et al.(2023)은 쇼벨 배치와 품위 혼합 등을 고려한 다목적 단기 노천광산 생산계획 방법을 제안하였으며, Nelis et al.(2023)은 품위 불확실성을 고려하여 채굴구역과 단기 생산일정을 동시에 결정하는 확률론적 계획모형을 개발하였다.
최근에는 광산의 운반 및 생산계획에 인공지능과 지능형 최적화기법을 적용하는 연구도 확대되고 있다. Yao et al.(2023)은 동적 품위혼합 의사결정과 트럭 배차를 연계한 노천광산 배차시스템을 제안하였으며, Huo et al.(2024)은 심층강화학습을 이용한 광산 운반장비의 실시간 배차방법을 개발하였다. Noriega et al.(2025)은 심층강화학습 기반 실시간 노천광산 트럭 배차시스템을 제안하였다. 또한 Chen et al.(2025)은 품위, 비용 및 가격변동을 고려한 노천광산 생산계획 최적화 방법을 개발하였으며, Xiang et al.(2025)은 다금속 노천광산을 대상으로 생산량과 품위편차를 고려한 다목적 품위혼합 최적화 방법을 제안하였다. 이러한 연구들은 다양한 생산목표와 운영 제약조건을 반영하여 광산의 계획 및 운반 의사결정을 지원하기 위한 방법론의 발전을 보여준다.
한편 최근에는 대규모 언어모델(large language model, LLM)의 자연어 처리 및 추론능력을 활용하여 복잡한 업무를 지원하는 연구가 활발하게 이루어지고 있다(Wang et al., 2024). LLM은 주어진 목표와 환경정보를 바탕으로 필요한 정보를 검토하고, 외부 도구나 모듈에서 생성된 결과를 활용하여 의사결정을 지원할 수 있다(Huang et al., 2024). 이러한 접근은 전문적인 정량계산을 외부 모듈에서 수행하고, LLM은 계산결과와 운영정보를 검토하여 최종 후보를 선택하고 선정 근거를 제시하는 방식으로 광산 운영계획에 활용될 수 있다.
기존 배차 및 단기 생산계획 연구는 주로 생산량과 품위 등의 목표를 만족하는 계획을 도출하고 운영성과를 개선하는 데 초점을 두어 왔다. 그러나 본 연구에서 검토한 선행연구에서는 실제 광산의 일일 배차계획 수립과정에서 고려되는 운영정보와 계획조건을 구조화하고, 공학적 정량계산과 LLM 기반 후보 선택 및 선정 근거 생성 기능을 결합하여 하나의 계획지원 프레임워크로 구현한 사례는 제한적이다. 또한 이러한 프레임워크가 생성한 계획을 동일한 운영조건에서 작업자가 사전에 작성한 배차계획과 직접 비교하여 적용 가능성을 평가한 연구도 충분히 이루어지지 않았다.
본 연구에서는 노천광산의 일일 배차계획 수립을 지원하기 위한 AI 지원 하이브리드 계획 프레임워크를 개발하고 평가하였다. 이를 위해 실제 광산에서 계획 수립 시 고려하는 운영정보와 계획조건을 분석하고, 후보계획의 생성과 예상 운반량 및 혼합품위 계산에는 Python 기반 모듈을, 사전 선별된 후보 중 최종 계획의 선택과 선정 근거 생성에는 GPT-4.1을 활용하였다. 개발된 프레임워크의 평가를 위해 과거 운광일지와 현장자료를 이용하여 계획 수립 당시의 운영조건과 작업 가능한 전체 작업구역을 재구성하였다. 이러한 조건에서 프레임워크가 생성한 계획을 작업자가 사전에 작성한 배차계획과 비교하고, 총 운반량과 평균 SiO2 품위의 유사성 및 대표사례의 작업구역 선택과 운반량 배분 차이를 분석하여 프레임워크의 적용 가능성과 한계를 검토하였다.
연구 방법
연구대상 광산 및 자료 구성
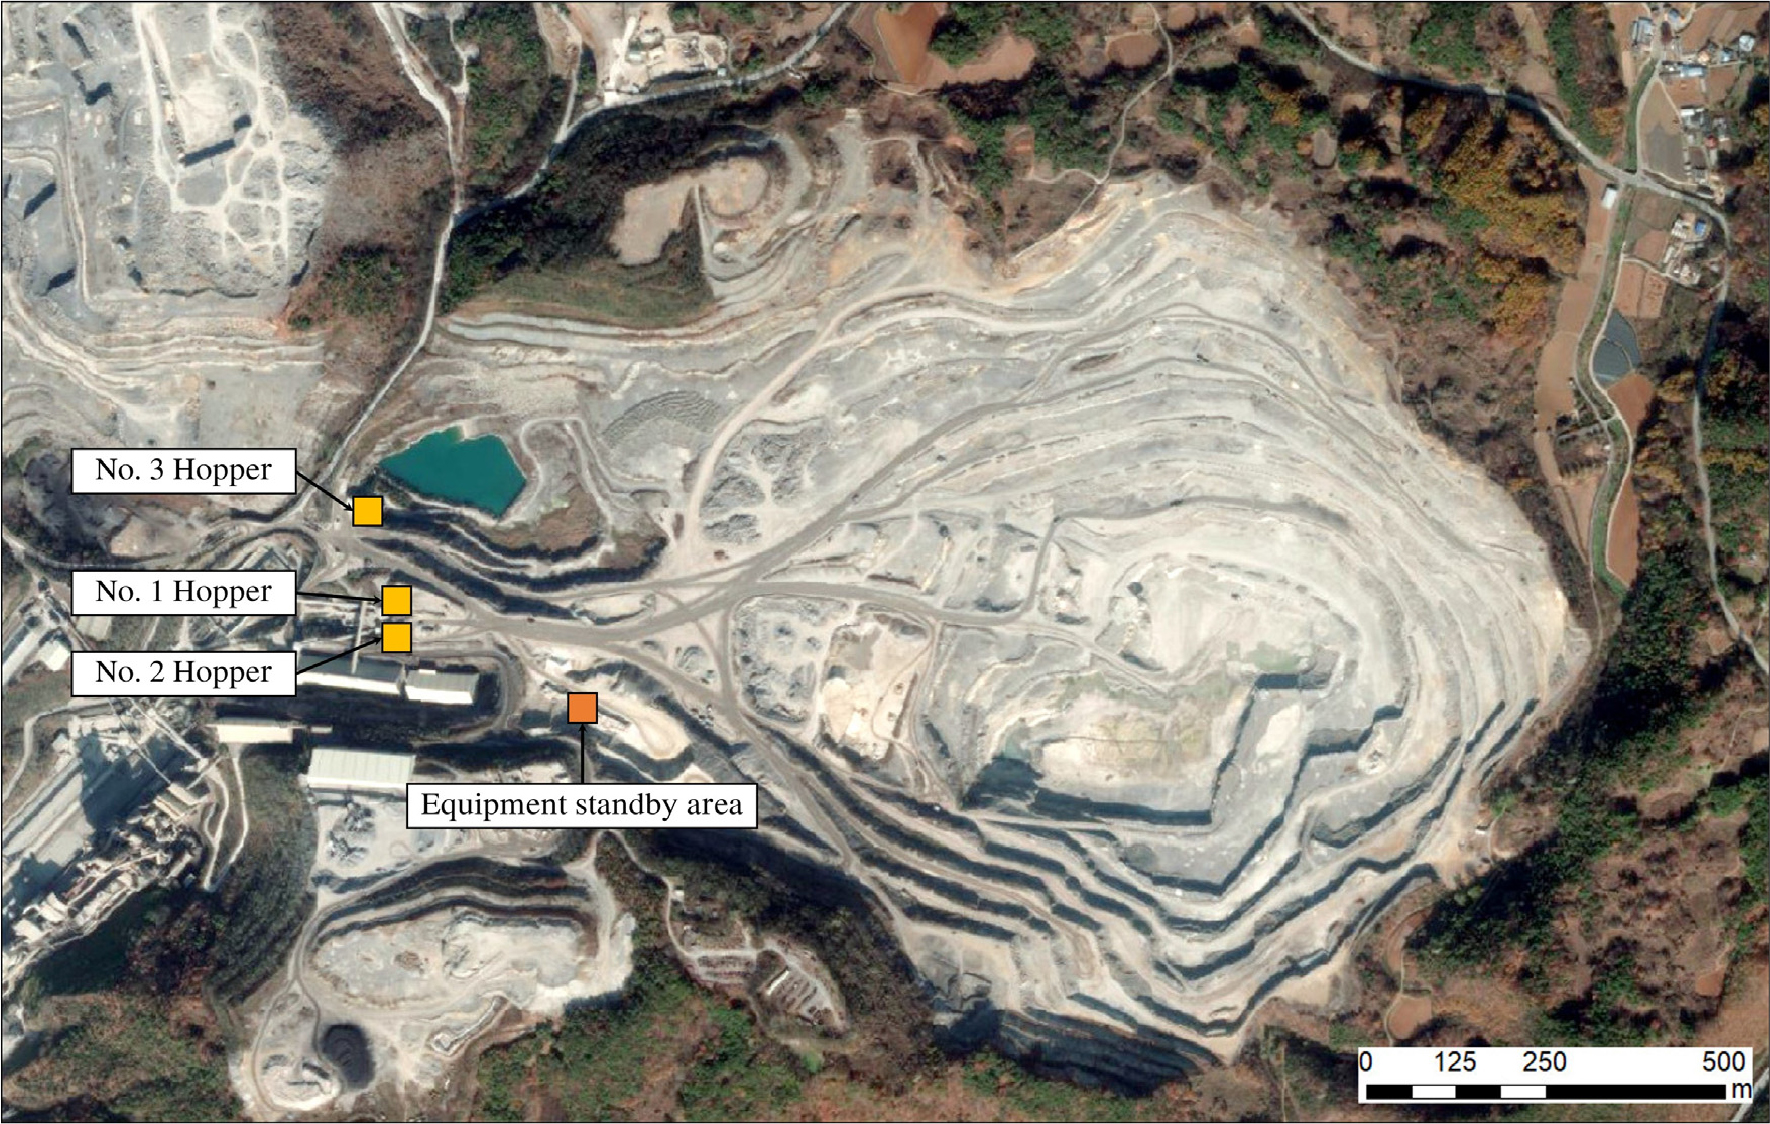
본 연구의 연구지역은 충청북도 단양군에 위치한 성신양회 성신광산으로, 시멘트용 석회석을 생산하는 노천광산이다. 석회석 생산공정은 천공, 발파, 운반 및 조쇄 등으로 구성되며, 본 연구에서는 이 중 원석 운반공정에서 이루어지는 일일 배차계획 수립을 연구대상으로 설정하였다. Fig. 1은 연구지역인 성신광산의 전경을 나타낸다.
성신광산에서는 2022년부터 ICT 기반 원석 생산 통합관리 시스템을 운영하고 있으며, 이를 통해 생산량, 품위, 장비위치, 재고량 및 운반실적과 관련된 정보를 수집·관리하고 있다. 실시간 원석 생산관리 시스템에서는 현재 송석현황, 송석 예외현황, 송석정보 및 일일 송석현황 등을 확인할 수 있으며, 석회석 생산량 모니터링 시스템에서는 통합 자료조회, 품위별 운광일지 및 작업지시서 등의 정보를 관리한다. Fig. 2는 성신광산에서 운영 중인 ICT 기반 원석 생산 통합관리 시스템의 주요 구성요소를 나타내며, Table 1은 시스템에서 관리되는 주요 데이터와 항목을 정리한 것이다.
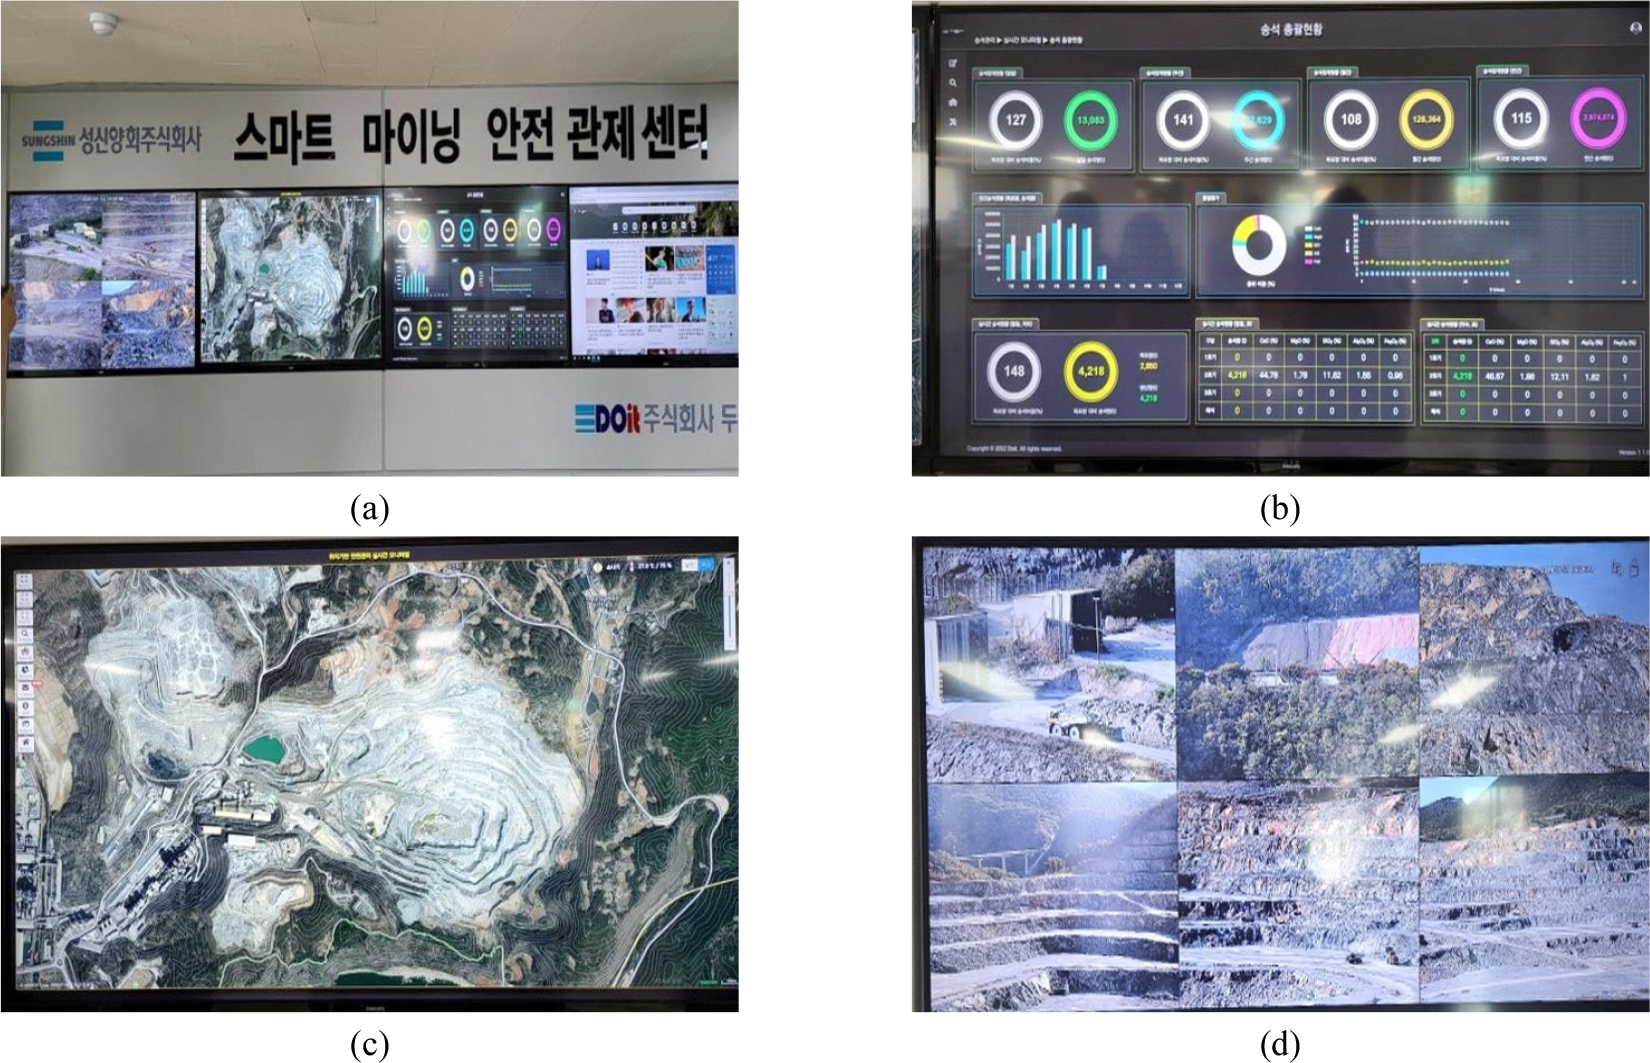
Table 1.
Major data available from the integrated raw-stone production management system
본 연구에서 배차계획은 작업구역의 선택, 작업구역별 목표 운반량 설정 및 로더–트럭 배치를 포함하는 일일 작업계획으로 정의하였다. 현장 작업자는 배차계획 수립 시 목표 운반량과 목표 SiO2 품위, 작업구역별 품위, 작업구역과 호퍼 간 운반거리 등을 고려하며, 본 연구에서는 이를 바탕으로 작업 가능한 구역, 작업구역별 품위와 가용 자원량, 운반거리, 호퍼 운영조건 및 가용 장비정보를 프레임워크의 입력자료와 계획조건으로 구성하였다. 목표 SiO2 품위는 성신광산의 현장 관리기준인 10±0.5%를 적용하였으며, 목표 운반량은 12,000–14,000 ton으로 설정하였다.
AI 지원 하이브리드 계획 프레임워크 설계
본 연구에서는 목표 운반량과 품위 등의 운영조건을 고려하여 일일 배차계획 수립을 지원하는 AI 지원 하이브리드 계획 프레임워크를 설계하였다. 본 연구의 하이브리드 계획 프레임워크는 후보계획 생성과 공학적 정량계산을 수행하는 Python 기반 모듈과, 사전 선별된 후보의 최종 선택 및 선정 근거 생성을 수행하는 GPT-4.1을 결합한 구조이다. Python 기반 모듈은 입력된 운영정보와 계획조건으로부터 후보계획을 생성하고 로더–트럭 배치, 예상 운반량, 작업구역별 운반량 및 혼합품위 등을 계산한다. GPT-4.1은 생성·계산·선별된 후보정보를 입력받아 최종 후보 하나를 선택하고 선정 근거를 생성한다. 따라서 GPT-4.1은 전체 탐색공간에서 후보계획을 직접 생성하거나 운반량 및 혼합품위를 계산하지 않으며, 로더와 트럭을 작업구역에 별도로 배치하지 않는다. Fig. 3은 개발된 프레임워크의 시스템 구성과 데이터 흐름을 나타낸다.
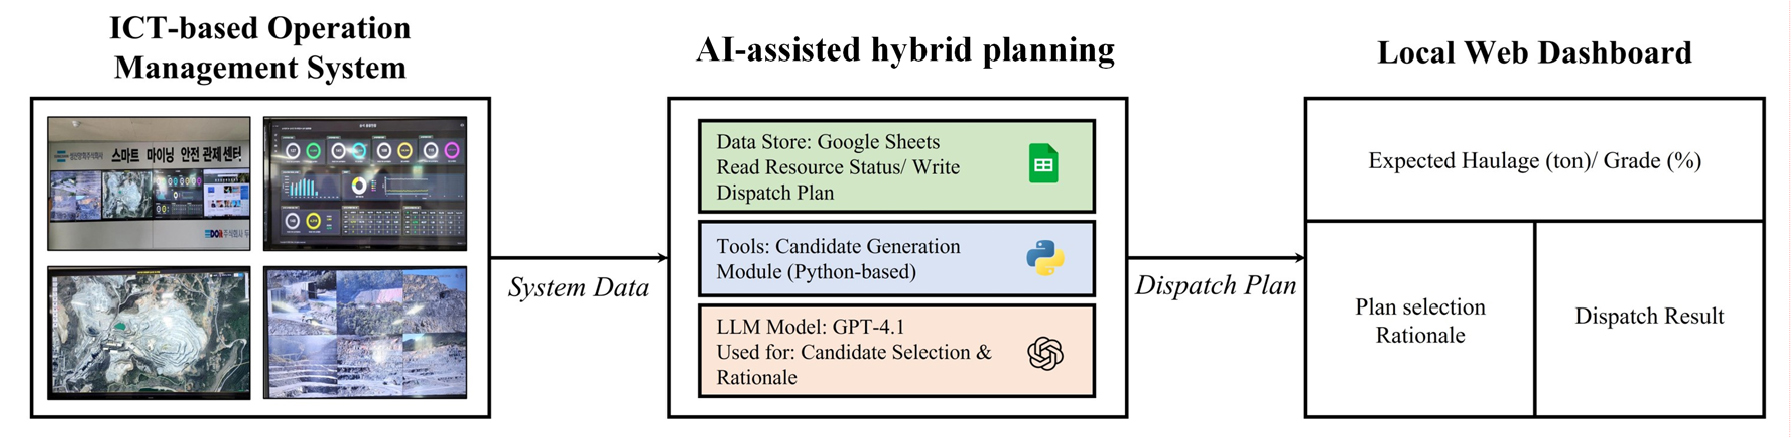
개발된 프레임워크는 광산 운영정보를 연구용 입력자료로 구성한 Google Sheets와 연계하였으며, Google Sheets API를 이용하여 입력자료를 조회하고 생성된 계획결과를 기록하도록 구현하였다. LLM은 OpenAI의 GPT-4.1(gpt-4.1-2025-04-14)을 API를 통해 사용하였으며, temperature는 0.1로 설정하였다. 17개 평가사례의 비교에는 사례별 1회 실행 결과를 사용하였다.
동일한 입력조건에서 최종 후보 선택결과의 일관성을 확인하기 위해 17개 평가사례를 각각 5회 반복 실행하였다. 각 반복에서는 해당 사례의 동일한 원 운영자료와 계획조건을 Python 기반 모듈에 다시 입력하여 후보생성, 정량계산, 후보순위 결정 및 상위 20개 후보 선별을 수행한 후, 동일한 프롬프트 구조와 GPT-4.1 설정으로 최종 후보 선택과 선정 근거 생성을 수행하였다. Fig. 4는 후보계획 생성부터 최종 후보 선택 및 선정 근거 생성까지의 전체 계획수립 절차를 나타낸다.
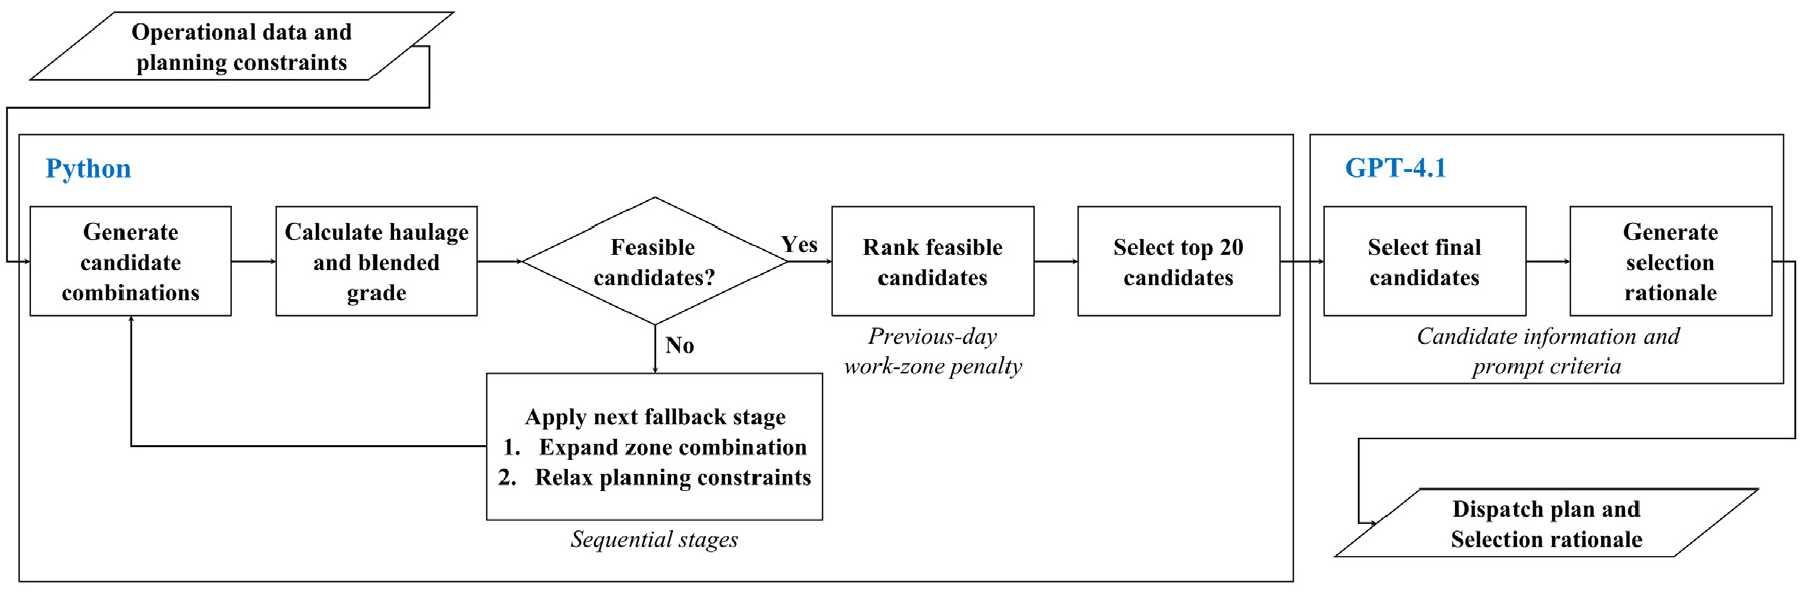
먼저 당일 작업 가능한 전체 작업구역과 각 구역의 운영정보를 입력받아 작업구역 후보조합을 생성하였다. 초기 후보생성에서는 로더별로 하나의 작업구역을 배정하고, 성신광산의 관리기준을 바탕으로 혼합 SiO2 품위가 9.5–10.5%이고 예상 총 운반량이 12,000–14,000 ton인 후보를 탐색하였다.
초기 조건을 만족하는 후보가 생성되지 않는 경우에는 단계적인 조건 완화 절차를 적용하였다. 먼저 로더당 작업구역을 1–2개까지 허용하여 후보조합을 확장하였다. 이 조건에서도 유효한 후보가 생성되지 않을 경우 운반량 허용범위를 ±1,500 ton 확대하고 SiO2 품위 상한을 11.0%까지 완화하였다. 이와 같이 후보가 생성되지 않는 경우에는 사전에 정의된 단계적 조건 완화 규칙에 따라 탐색범위를 확대하였다.
최근 사용한 작업구역에 계획이 연속적으로 집중되는 것을 완화하기 위해 작업구역별 미사용일수에 따른 감점값을 후보순위 산정에 반영하였다. 최근 사용 후 경과일수를 d라고 할 때 작업구역별 감점값 P(d)는 다음과 같이 산정하였다.
이에 따라 최근 사용 후 0일, 1일, 2일 및 3일 이상 경과한 작업구역의 감점값은 각각 100, 66, 32 및 0이 된다. 이 감점값은 특정 작업구역의 연속 사용을 완화하기 위한 경험적 휴리스틱으로, 최근 사용의 영향이 약 3일에 걸쳐 감소하도록 설정하였으며 별도의 현장자료 기반 보정은 수행하지 않았다.
각 후보계획에 포함된 작업구역의 감점값을 합산하여 후보별 총 감점값을 산정하고, 총 감점값이 작은 후보를 우선하였다. 총 감점값이 동일한 후보 간에는 예상 총 운반량이 목표 운반량 범위의 중앙값인 13,000 ton에 가까운 후보를 우선하였다. SiO2 품위는 적합 후보 여부를 판단하기 위한 조건으로 사용하였으며, 적합 후보 간 순위를 결정하는 기준에는 포함하지 않았다.
각 후보계획의 예상 운반량은 작업구역과 호퍼 간 이동거리, 트럭의 주행속도, 적재 및 하역시간, 호퍼 운영조건 등을 이용하여 산정하였다. 트럭의 적재용량은 57 ton을 적용하였으며, 작업구역별 예상 운반주기시간과 작업가능시간을 이용하여 예상 운반횟수와 운반량을 계산하였다. 또한 작업구역별 예상 운반량을 고려하여 각 후보계획의 혼합 SiO2 품위를 산정하였다. 모든 정량계산은 Python 기반 모듈에서 수행하였다.
운반량과 품위조건을 만족한 후보를 총 감점값과 예상 총 운반량의 13,000 ton 근접도 순으로 정렬한 후 상위 20개를 GPT-4.1에 제공하였다. 후보 수는 LLM 입력의 토큰 사용량을 고려하여 20개로 설정하였다. GPT-4.1에 제공되는 후보정보에는 각 후보의 작업구역 조합, 예상 운반량, 혼합품위, 작업구역별 운반량 배분 및 로더–트럭 배치 결과가 포함되었다. GPT-4.1에는 제공된 20개 후보 가운데 하나를 선택하고 선정 근거를 제시하도록 지시하였으며, 후보선택을 위한 별도의 수치적 우선순위는 프롬프트에 명시하지 않았다.
GPT-4.1의 출력은 선택된 후보의 인덱스(selected_idx)와 선정 근거(reason)를 포함하는 JSON 형식으로 구성하였다. Table 2는 GPT-4.1에 제공된 후보정보, 선택 지시 및 출력형식을 정리한 것이다.
Table 2.
Summary of GPT-4.1 input information, selection instruction, and output format
본 연구에서는 GPT-4.1에 후보별 가중치나 명시적인 목적함수와 같은 수치적 선택규칙을 별도로 부여하지 않았다. 따라서 최종 후보 선택은 Table 2의 후보정보와 선택 지시에 대한 모델의 추론 결과이며, 개별 정보가 어떠한 상대적 중요도나 가중치로 선택에 기여하였는지는 직접 측정하거나 규정하지 않았다. 이에 GPT-4.1이 생성한 자연어 선정 근거는 명시적인 의사결정 규칙이 아니라 사용자가 선택결과를 검토하기 위한 설명정보로 활용하였다.
과거 작업자료를 이용한 입력조건 재구성
개발된 프레임워크가 생성한 배차계획과 실제 작업자가 작성한 배차계획을 비교하기 위해 2023년 7월의 운광일지와 관련 현장자료를 이용하였다. 성신광산의 운광일지에는 작업 전에 작성되는 작업지시 내용과 작업 후 기록되는 실제 운광실적이 함께 관리된다. 본 연구에서는 작업 전 작성된 작업지시 내용을 프레임워크 생성계획의 비교대상으로 사용하였다. Fig. 5는 비교에 사용된 과거 작업자의 사전 배차계획 자료의 예를 나타낸다. Table 3은 Fig. 5에 제시된 2023년 7월 1일 3교대 작업에서 작업자가 사전에 작성한 작업구역, 배치장비, SiO2 품위 및 계획 운반량을 정리한 것이다.
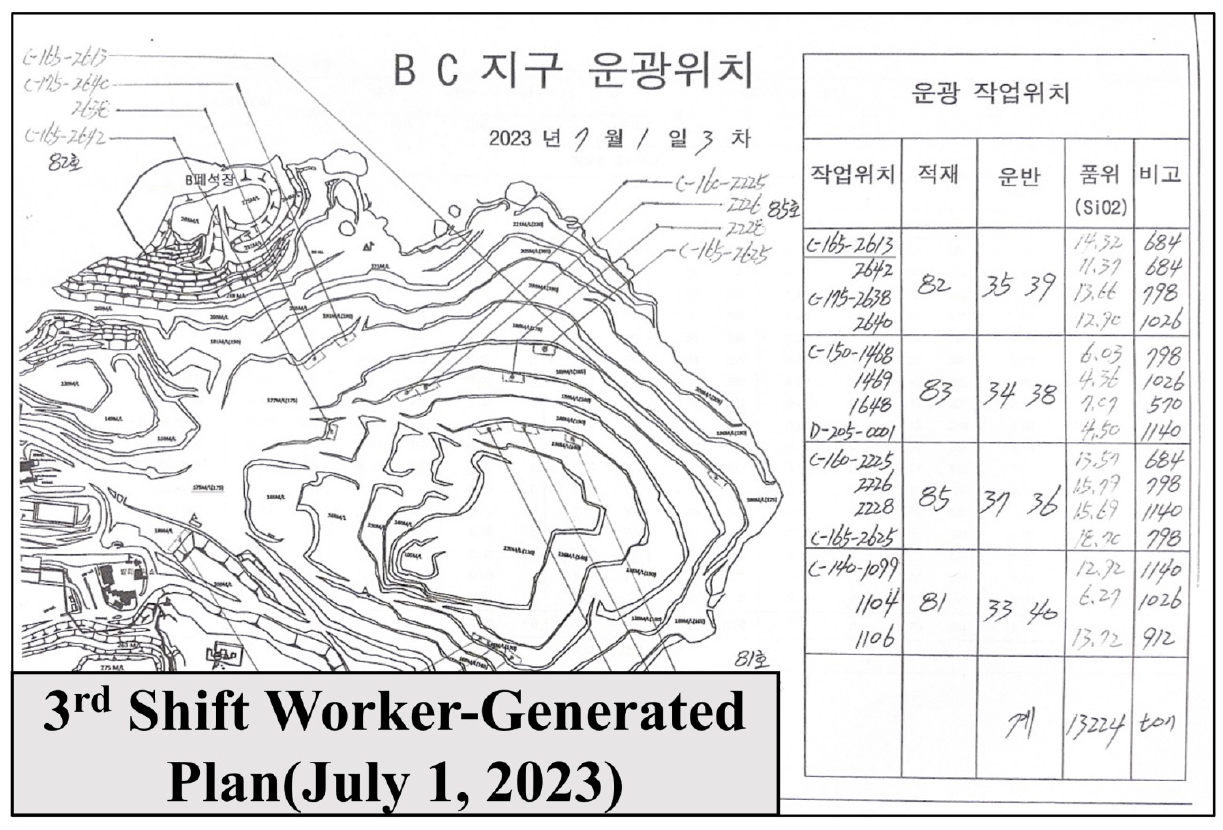
Table 3.
Worker-generated dispatch plan for July 1, 2023, Shift 3
과거 작업시점의 운영조건을 재구성하기 위해 각 사례에서 당시 작업 가능한 전체 작업구역을 프레임워크의 후보 작업구역으로 구성하였다. 즉, 작업자가 실제로 선택한 작업구역만을 제공한 것이 아니라 당시 작업 가능한 전체 작업구역에서 후보조합을 생성하도록 하였다. 또한 과거 자료의 작업구역 체계와 프레임워크의 입력구조를 일치시키기 위해 지도상에서 인접한 작업구역을 하나의 그룹으로 재구성하였다. 그룹화된 작업구역의 SiO2 품위는 포함된 작업구역의 품위 평균값을 사용하였다.
과거 작업시점의 정확한 잔여 자원량을 복원하기 어려운 경우에는 자원량 제약으로 인해 후보계획 생성이 제한되지 않도록 충분한 가용 자원량을 가정하여 입력하였다. 따라서 입력된 가용 자원량은 당시의 실제 잔여 자원량 추정치가 아니라 후보계획 생성을 위한 방법론적 입력조건이다.
이상의 방법으로 각 사례에서 작업 가능한 구역과 품위, 운반거리 및 장비정보 등 계획수립에 필요한 운영조건을 재구성하여 프레임워크의 입력자료로 사용하였다.
평가대상 선정 및 비교실험
개발된 프레임워크가 정상적인 생산조건에서 작업자의 사전 배차계획과 어느 정도 유사한 계획결과를 생성하는지 평가하기 위해 2023년 7월의 작업자료를 검토하였다. 해당 기간에는 총 60개의 교대별 작업사례가 확인되었다. 이 가운데 도로작업, 현장정리 및 일부 로더만 가동되는 등의 조건으로 목표 운반량에 미달한 42개 사례와 목표 운반량을 초과한 1개 사례를 제외하고, 성신광산의 목표 운반량 범위인 12,000–14,000 ton을 만족한 17개 사례를 최종 평가대상으로 선정하였다.
각 사례에 대해 당시 작업 가능한 전체 작업구역과 운영정보를 재구성하여 프레임워크에 입력하고, 생성된 계획을 동일 교대에서 작업자가 사전에 작성한 배차계획과 비교하였다. Fig. 6은 과거 운영조건의 재구성부터 프레임워크의 계획생성 및 작업자 계획과의 비교에 이르는 전체 평가절차를 나타낸다.
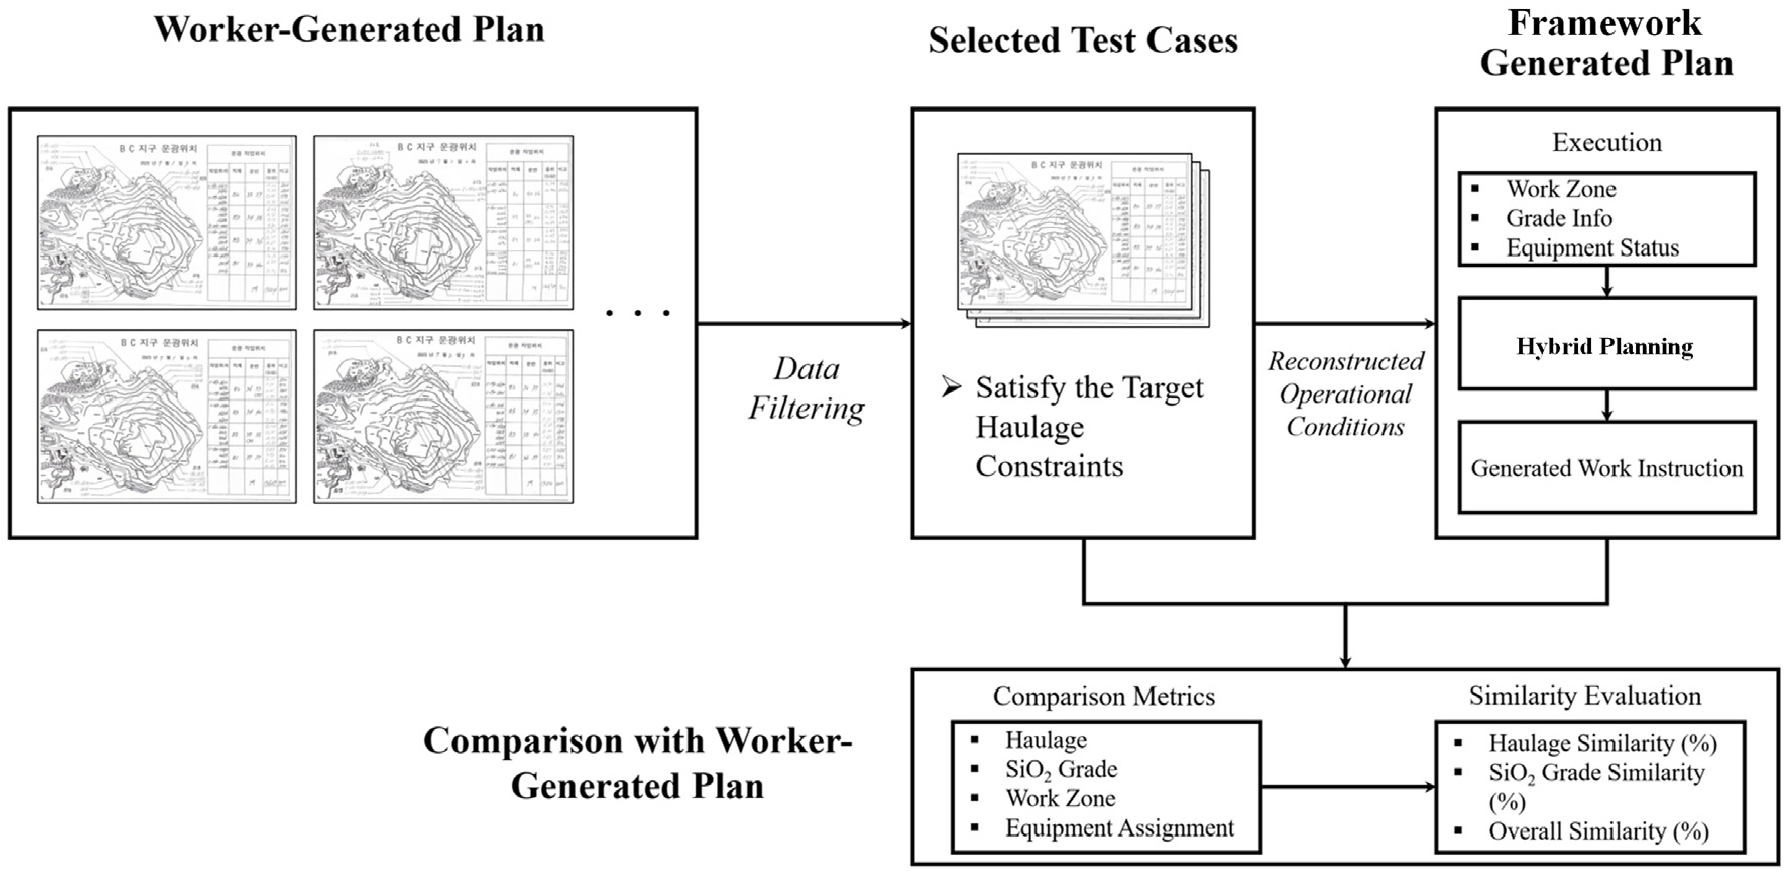
비교분석에서는 두 계획의 총 운반량과 평균 SiO2 품위를 이용하여 주요 계획결과의 유사성을 정량적으로 평가하였다. 또한 운반량 유사도가 높은 사례와 상대적으로 낮은 사례를 대표적으로 선정하여 작업구역 선택과 작업구역별 운반량 배분을 비교하였다.
계획 유사도 평가방법
작업자가 작성한 사전 배차계획과 프레임워크가 생성한 배차계획의 주요 계획결과를 정량적으로 비교하기 위해 운반량 유사도(Haulage Similarity, )와 품위 유사도(Grade Similarity, )를 산정하였다. 운반량 유사도는 작업자 계획의 총 운반량을 기준으로 두 계획 간 절대 차이의 상대적 비율을 이용하여 식 (2)와 같이 계산하였다.
여기서 와 는 각각 작업자의 사전 배차계획과 프레임워크 생성계획의 총 운반량을 의미한다.
품위 유사도는 작업자 계획의 평균 SiO2 품위를 기준으로 두 계획 간 절대 차이의 상대적 비율을 이용하여 식 (3)과 같이 계산하였다.
여기서 와 는 각각 작업자의 사전 배차계획과 프레임워크 생성계획의 평균 SiO2 품위를 의미한다.
운반량 유사도와 품위 유사도를 종합적으로 평가하기 위해 두 지표에 동일한 가중치를 적용한 산술평균을 종합 유사도(Overall Similarity, )로 정의하였다.
종합 유사도는 전체 계획 수립과정이나 작업구역 선택, 작업구역별 운반량 배분 및 장비배치의 일치율이 아니라, 총 운반량과 평균 SiO2 품위라는 두 가지 주요 계획결과의 유사성을 나타내는 지표로 정의하였다.
연구 결과
AI 지원 하이브리드 계획 프레임워크의 배차계획 생성 결과
개발된 AI 지원 하이브리드 계획 프레임워크를 이용하여 작업 가능한 작업구역, 목표 운반량과 품위 및 가용 장비 등의 운영정보로부터 일일 배차계획을 생성하였다. Fig. 7은 프레임워크의 계획결과 출력화면을 나타내며, 선택된 작업구역, 작업구역별 계획 운반량, 로더·트럭 배치, 예상 총 운반량, 평균 SiO2 품위 및 최종 후보의 선정 근거를 확인할 수 있다.
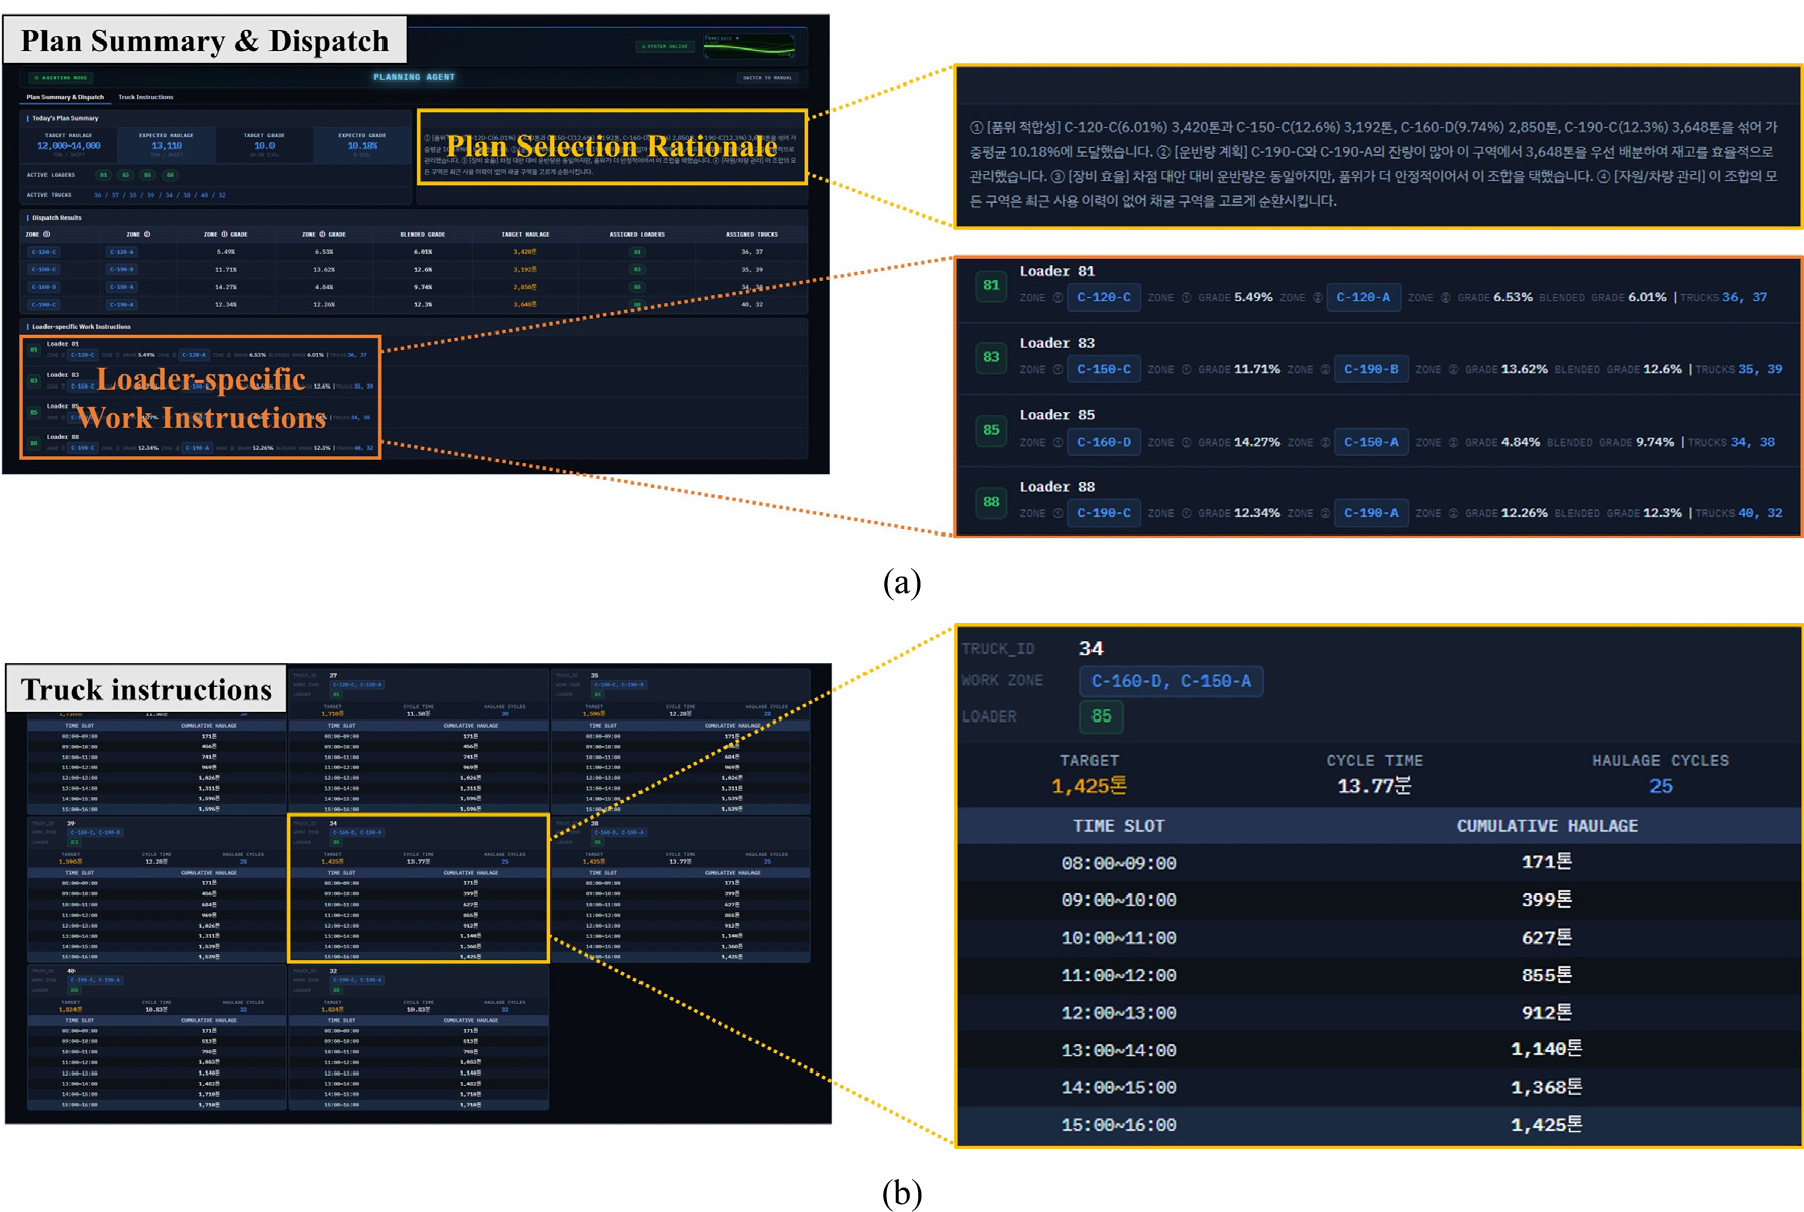
Table 4는 프레임워크에서 생성된 배차계획의 예를 나타낸다. 해당 계획의 예상 총 운반량은 13,110 ton, 평균 SiO2 품위는 10.18%였다. Table 4의 계획은 후술하는 2023년 7월 1일 3교대 평가사례와는 별도의 배차계획 생성 예시이다.
Table 4.
Example of a dispatch plan generated by the proposed framework
Table 5는 Table 4의 계획에 대해 GPT-4.1이 생성한 선정 근거의 실제 출력 예를 나타낸다. 선정 근거는 후보계획의 정량정보를 바탕으로 자연어 형태로 생성되었으며, 개별 항목의 독립적인 최적화 성능이나 사전에 정의된 정량적 선택규칙을 의미하지 않는다. 또한 최근 작업구역 사용이력에 관한 표현은 실제 GPT-4.1 출력에 포함되어 있으나, 해당 정보는 GPT-4.1에 별도의 입력자료로 제공되지 않았다.
Table 5.
Example of the plan selection rationale generated by GPT-4.1
프레임워크의 계획생성 과정을 구체적으로 확인하기 위해 2023년 7월 1일 3교대 사례를 살펴보았다. 해당 사례의 당시 운영자료와 계획조건을 이용하여 전체 계획수립 절차를 수행한 결과, 최종 선택된 계획의 총 운반량은 13,224 ton, 평균 SiO2 품위는 10.98%로 나타났다. 동일 입력에 대한 최종 후보 선택결과의 일관성을 확인하기 위해 17개 평가사례를 각각 5회 반복 실행한 결과, 각 사례에서 선택된 작업구역 조합, 총 운반량 및 평균 SiO2 품위는 5회 모두 동일하였으며, 선정 근거의 자연어 표현에서만 일부 차이가 나타났다.
작업자 사전 배차계획과 프레임워크 생성계획의 정량적 비교
2023년 7월의 작업자료에서 선정된 17개 평가사례를 대상으로 프레임워크가 생성한 배차계획과 실제 작업자가 작업 전에 작성한 배차계획을 비교하였다. Table 6은 각 사례에서 두 계획의 총 운반량, 평균 SiO2 품위 및 유사도를 나타낸다. Fig. 8은 17개 평가사례에서 작업자의 사전 배차계획과 프레임워크 생성계획의 총 운반량을 비교한 결과이다.
Table 6.
Haulage and SiO2 grade similarities between worker-generated and framework-generated dispatch plans
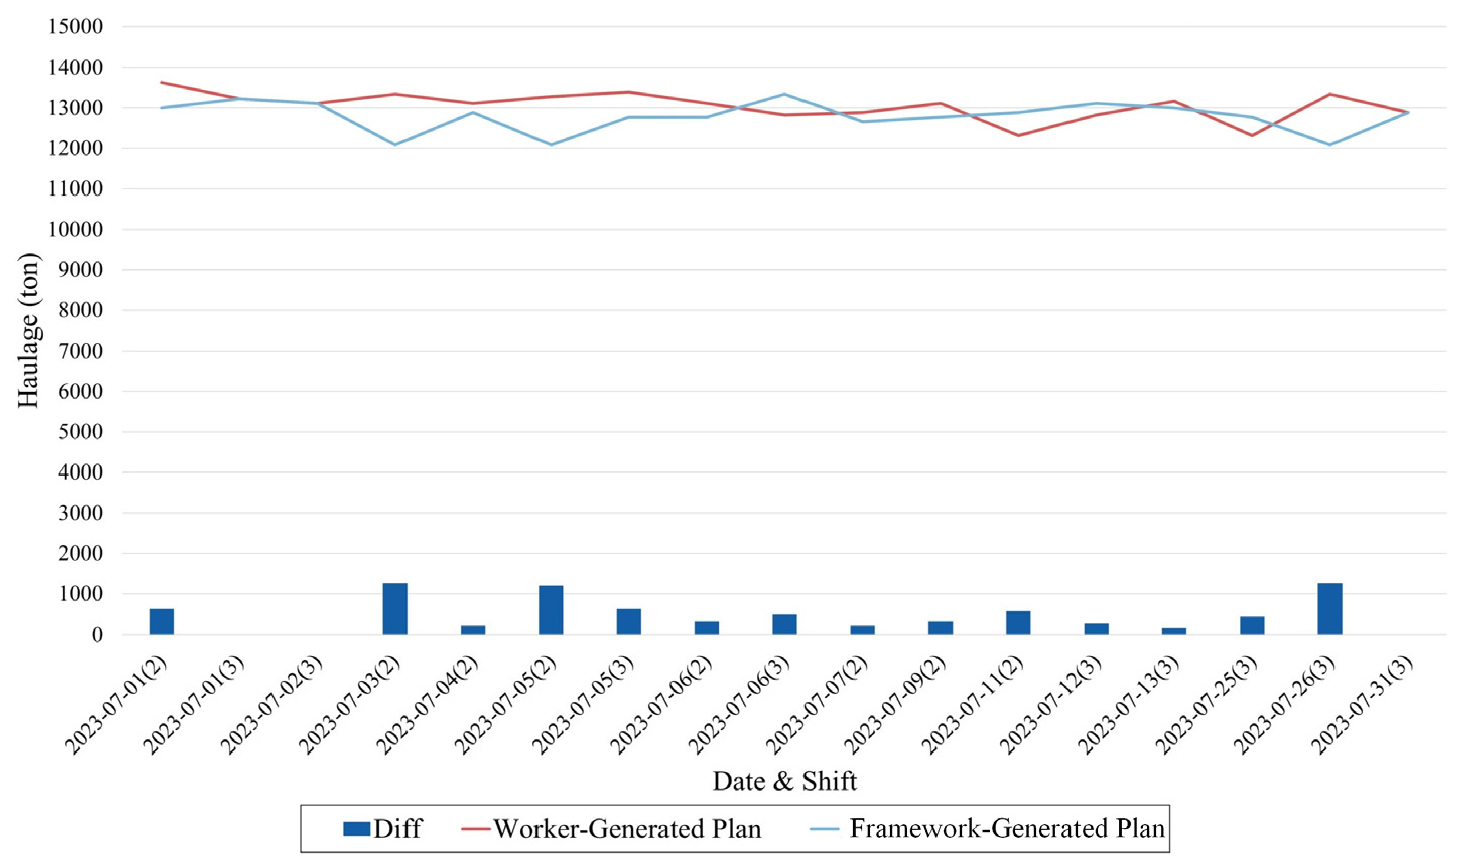
17개 사례에서 작업자 계획과 프레임워크 생성계획의 평균 총 운반량은 각각 13,050 ton과 12,788 ton이었으며, 평균 절대차이는 476.5 ton, 평균 운반량 유사도는 96.4%였다. 평균 SiO2 품위는 각각 11.0%와 10.6%였고, 평균 절대 품위차이는 0.5%p, 평균 품위 유사도는 95.8%였다. 두 유사도의 산술평균으로 계산한 종합 유사도는 96.1%였다(Table 7). 이 결과는 본 연구의 평가조건에서 두 계획의 총 운반량과 평균 SiO2 품위가 전반적으로 유사하였음을 보여준다.
Table 7.
Average similarity between worker-generated and framework-generated dispatch plans
| Metric | Average Similarity (%) |
| Haulage Similarity | 96.4 |
| Grade Similarity | 95.8 |
| Overall Similarity | 96.1 |
대표적인 고·저운반량 유사도 사례 비교
주요 계획결과의 유사성과 세부 계획구성의 관계를 확인하기 위해 운반량 유사도가 높은 사례와 상대적으로 낮은 사례를 대표적으로 선정하였다. Table 8은 두 사례의 총 운반량, 평균 SiO2 품위 및 작업구역 배정 특성을 비교한 것이다.
Table 8.
Comparison of representative high-and low-haulage-similarity cases
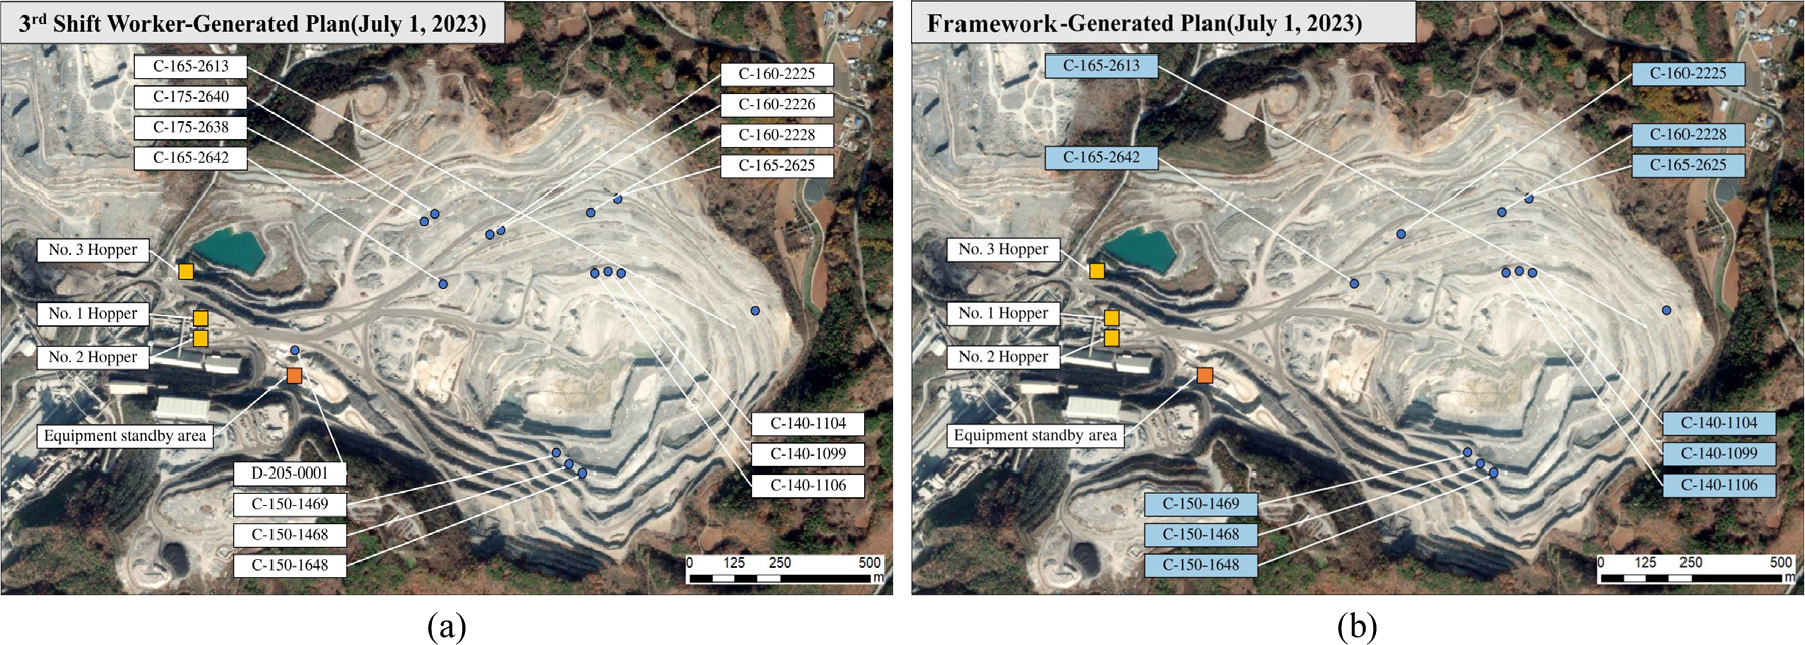
2023년 7월 1일 3교대 사례에서는 작업자의 사전 배차계획과 프레임워크 생성계획의 총 운반량이 모두 13,224 ton으로 동일하였으며, 운반량 유사도는 100.0%였다. 평균 SiO2 품위는 각각 11.23%와 10.98%로 나타나 0.25%p의 차이를 보였으며, 품위 유사도는 97.8%였다. Fig. 9는 해당 사례에서 두 계획의 작업구역 선택 및 운반량 배분을 비교한 결과이다. 해당 사례에서는 총 운반량과 평균 품위뿐만 아니라 작업구역 활용과 운반량 배분에서도 전반적으로 유사한 특성이 나타났으나, 일부 작업구역 선택과 세부 운반량 배분에는 차이가 확인되었다.
반면 2023년 7월 3일 2교대 사례에서는 작업자의 사전 배차계획과 프레임워크 생성계획의 총 운반량이 각각 13,338 ton과 12,084 ton으로 1,254 ton의 차이가 발생하였으며, 운반량 유사도는 90.6%였다. 평균 SiO2 품위는 각각 10.75%와 10.56%로 0.19%p의 차이를 보였고, 품위 유사도는 98.2%였다. Fig. 10은 해당 사례에서 두 계획의 작업구역 선택 및 운반량 배분을 비교한 결과이다.
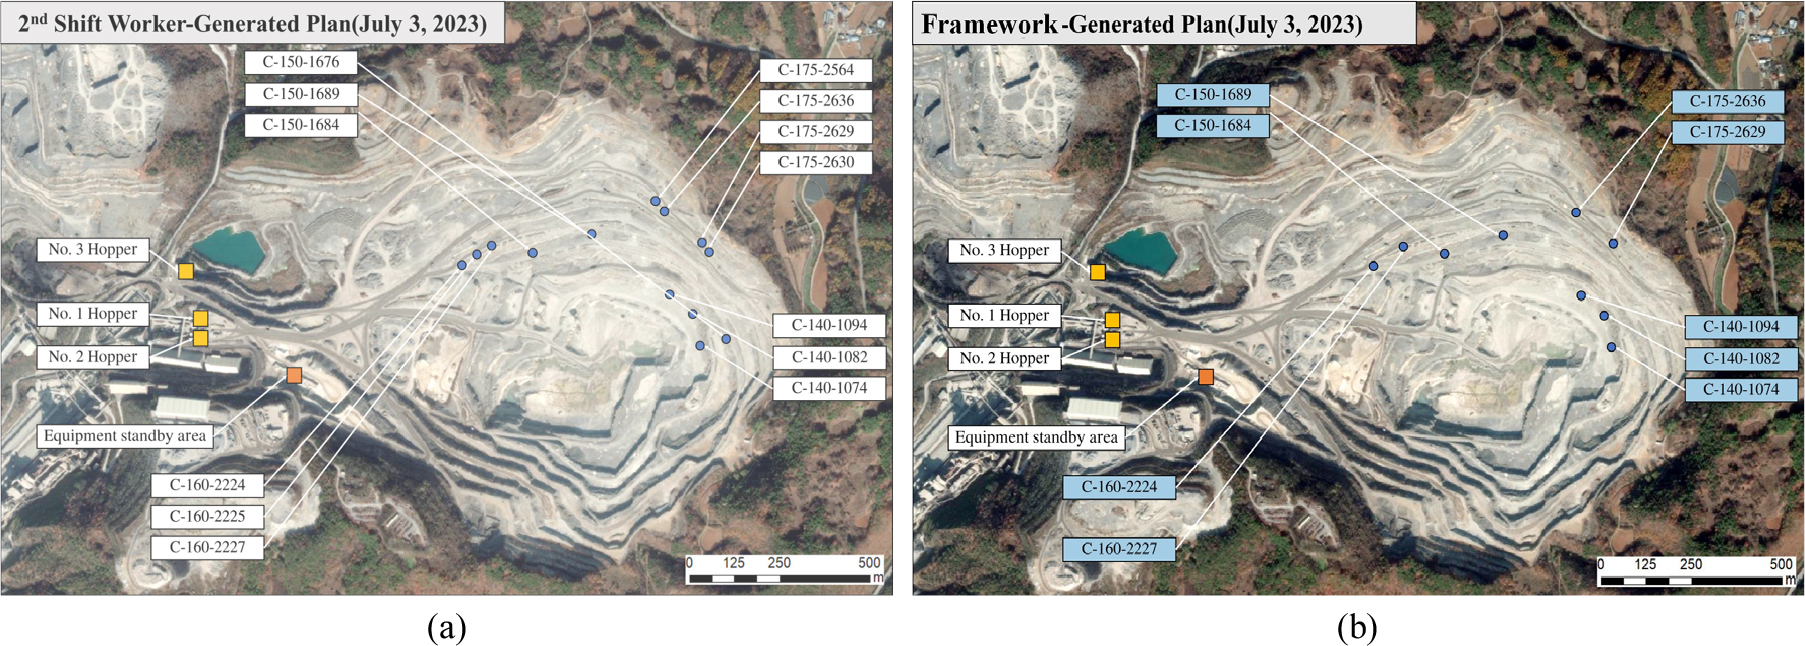
이 사례에서는 평균 SiO2 품위의 차이는 작았으나, 작업구역 선택과 작업구역별 운반량 배분 및 총 운반량에서 상대적으로 큰 차이가 나타났다. 두 대표사례에서 관찰된 차이와 가능한 영향요인은 다음 토의에서 검토하였다.
토 의
본 연구에서 프레임워크 생성계획과 작업자의 사전 배차계획을 비교한 결과, 총 운반량과 평균 SiO2 품위의 평균 유사도는 각각 96.4%와 95.8%였으며, 종합 유사도는 96.1%였다. 다만 이러한 높은 유사도에는 Python 기반 후보생성, 계획 제약조건 적용 및 사전 선별 과정의 구조적 영향이 포함될 수 있다. Python 기반 모듈이 목표 운반량과 품위조건을 반영하여 후보를 생성·선별하고, 비교대상인 작업자의 사전 배차계획도 동일한 광산의 생산 및 품위 관리조건 아래에서 작성되었기 때문이다. 따라서 본 연구에서 산정한 96.1%의 종합 유사도는 GPT-4.1의 독립적인 계획성능이나 규칙 기반 후보선택 방법에 대한 성능 우위를 의미하지 않는다. 본 연구의 평가단위는 GPT-4.1 단독이 아니라 후보생성, 정량계산, 사전 선별, 최종 후보 선택 및 선정 근거 생성을 포함하는 전체 계획 프레임워크이다.
GPT-4.1은 전체 탐색공간에서 후보계획을 생성하거나 수학적 최적화를 수행하지 않고, Python 기반 모듈에서 생성·계산·선별된 후보의 정량정보를 이용하여 최종 후보 하나를 선택하고 선정 근거를 생성한다. 또한 후보별 명시적인 선택가중치나 목적함수를 부여하지 않았으므로, 개별 후보정보가 최종 선택에 기여한 상대적 중요도를 정량적으로 설명할 수는 없다. 따라서 본 연구에서 GPT-4.1의 역할은 공학적으로 선별된 후보 중 최종 후보를 선택하고 사용자가 결과를 검토할 수 있도록 설명정보를 제공하는 의사결정 지원기능으로 한정하여 해석해야 한다. 상위 후보의 유사도 분포를 분석하거나 단순 규칙 기반 후보선택 방법과 GPT-4.1의 선택결과를 비교하면 각 구성요소의 기여를 보다 직접적으로 평가할 수 있다. 그러나 본 연구에서는 이러한 구성요소별 비교를 수행하지 않았으므로, 보고된 유사도를 특정 구성요소의 성능개선 효과로 해석하지 않았다.
대표사례 비교에서는 주요 계획결과의 유사성과 세부 계획구성의 유사성이 반드시 일치하지 않음을 확인하였다. 고운반량 유사도 사례에서는 작업구역 활용과 운반량 배분도 전반적으로 유사하였으나, 저운반량 유사도 사례에서는 평균 품위가 유사함에도 작업구역 선택, 작업구역별 운반량 배분 및 총 운반량에서 차이가 나타났다. 이러한 차이는 목표 운반량과 품위조건, 최근 작업구역 사용이력에 따른 감점, 단계적 조건 완화, 후보순위 결정 및 GPT-4.1의 최종 후보 선택 등 프레임워크의 여러 처리단계에 의해 영향을 받을 수 있다. 다만 본 연구에서는 각 단계의 영향을 분리하여 정량적으로 평가하지 않았으므로 특정 단계가 개별 사례의 차이를 유발했다고 단정할 수 없다. 또한 실제 작업자가 계획 당시 고려한 일부 현장정보나 경험적 판단은 후향적 자료만으로 완전히 복원하기 어려웠으므로 가능한 영향요인으로만 해석할 필요가 있다.
본 연구에는 몇 가지 한계가 있다. 첫째, 과거 작업자료를 이용한 후향적 평가이므로 계획 당시의 모든 운영조건을 완전하게 복원할 수 없었으며, 정확한 잔여 자원량을 확인하기 어려운 경우에는 후보생성이 제한되지 않도록 충분한 가용 자원량을 가정하였다. 둘째, 과거 작업구역을 프레임워크의 입력구조에 맞추는 과정에서 인접 작업구역을 그룹화하고 품위를 평균화하였다. 셋째, 평가대상은 2023년 7월의 정상적인 생산조건을 만족한 17개 사례로 한정되어 있어 다양한 비정상 운영조건이나 장기간의 운영상황으로 결과를 일반화하는 데 한계가 있다. 또한 본 연구에서는 후보생성·사전 선별과 GPT-4.1의 최종 선택이 전체 결과에 미치는 기여를 분리하여 평가하지 않았다. 향후에는 후보생성 단계와 최종 선택결과를 함께 분석하고 서로 다른 후보선택 방법을 비교함으로써 각 구성요소의 역할을 보다 체계적으로 평가할 필요가 있다.
마지막으로 본 연구는 프레임워크 생성계획과 작업자의 사전 배차계획을 비교한 것이며, 생성된 계획을 실제 현장에 적용했을 때 계획된 운반량과 품위가 실제 운광실적으로 어느 정도 달성되는지는 직접 평가하지 않았다. 따라서 본 연구의 결과는 일일 배차계획 지원 가능성을 보여주는 것으로, 실제 현장 운영성과로 해석해서는 안 된다.
결 론
본 연구에서는 노천광산의 일일 배차계획 수립을 지원하기 위해 실제 현장의 운영정보와 계획조건을 구조화하고, Python 기반 공학적 정량계산과 GPT-4.1 기반 최종 후보 선택 및 선정 근거 생성 기능을 결합한 AI 지원 하이브리드 계획 프레임워크를 개발하였다.
개발된 프레임워크는 2023년 7월의 정상 생산조건 17개 사례를 대상으로 작업자의 사전 배차계획과 비교하여 평가하였다. 그 결과 총 운반량과 평균 SiO2 품위의 평균 유사도는 각각 96.4%와 95.8%였으며, 종합 유사도는 96.1%로 나타났다. 이는 본 연구의 평가조건에서 프레임워크가 작업자의 사전 배차계획과 주요 계획결과 측면에서 유사한 결과를 생성하였음을 보여준다.
다만 이러한 유사도에는 Python 기반 후보생성, 계획 제약조건 적용 및 사전 선별의 영향이 포함될 수 있으므로, GPT-4.1의 독립적인 계획성능이나 다른 후보선택 방법에 대한 성능 우위로 해석할 수 없다. 또한 종합 유사도는 전체 계획 수립과정이나 세부 배차계획의 일치율이 아니라 총 운반량과 평균 SiO2 품위라는 주요 계획결과의 유사성을 나타내는 지표로 해석해야 한다.
본 연구의 의의는 실제 노천광산의 일일 배차계획에 사용되는 운영정보와 계획조건을 구조화하고, 공학적 정량계산과 LLM 기반 의사결정 지원기능을 하나의 계획 프레임워크로 구현하여 작업자의 사전 배차계획과 비교 평가하였다는 데 있다. 향후에는 다양한 운영조건과 실제 현장 운영실적을 대상으로 적용범위를 확대하고, 후보생성·선별 및 최종 선택 단계의 기여를 구분하여 평가함으로써 프레임워크의 적용성과 구성요소별 역할을 보다 체계적으로 검토할 필요가 있다.