

서 론
이론적 배경
대규모 언어 모델(LLM) 개요 및 특징
물리탐사 및 과학·공학분야 적용에서의 LLM의 한계
도구호출(tool calling) 및 AI Agent
Model Context Protocol(MCP)
MCP 기반 MT 2차원 역산 AI Agent 시스템 구현
MT 자료 처리 및 해석 워크플로우 개요
MT 탐사 2차원 역산 AI Agent 전체 시스템 개요
에이전트 기반 2차원 역산 워크플로우 및 협업 제어
에이전트 활용 역산 실험 및 검증
적용 탐사 자료 개요
에이전트 협업을 통한 구간별 측선 설정
역산 자료 준비(자료 Q/C, 자료 회전)
역산 블록모델 설계 및 미리보기
파라미터 체계적 설정 및 역산 수행
역산 결과 평가
결 론
서 론
자기지전류(Magnetotelluric, MT) 탐사는 자연적인 전자기장을 측정하여 지하 심부의 전기전도도 구조를 획득하는 방법으로, 광물 및 지열 자원 탐사, 광역 지질구조 규명, 화산지대 조사 등 다양한 분야에서 널리 활용되는 대표적인 전자탐사법이다. 이때 관측되는 전자기장은 광대역 주파수 특성을 지니며, 수십 kHz에 이르는 고주파수 성분(AMT 대역 포함)은 천부의 정밀한 분해능을, 수천 초의 장주기(long-period)를 갖는 저주파수 성분은 깊은 심도까지의 가탐심도를 제공한다. MT 탐사 자료 해석은 현장 측정 시계열 자료로부터 주파수 영역의 임피던스 텐서를 추출하고, 다양한 자료 처리 및 분석 과정을 거쳐 양질의 관측 자료를 선별한 뒤, 지구물리 역산(geophysical inversion)을 통해 지하의 전기비저항 구조 모델을 획득하는 과정을 거친다(Chave and Jones, 2012).
그러나 지구물리 역산은 본질적으로 부적정(ill-posed) 문제로서, 동일한 관측 자료를 만족하는 해가 무수히 존재하는 비유일성(non-uniqueness)과 수치해의 비안정성(instability)을 내재하고 있다(Zhdanov, 2002). 따라서 지질학적·지구물리학적으로 타당한 최적의 모델을 도출하기 위해서는 지형 기복이나 정적 효과(static shift)와 같은 전하 축적 및 전류 왜곡 현상의 고려, 정밀한 수치 격자 설계, 역산 제어 파라미터 최적화, 역산 수렴 안정성 평가(Chave and Jones, 2012) 등 해석자의 고도화된 전문 지식과 반복적인 시행착오가 요구된다. 지난 수십 년간 계산 과학 기술의 발전과 다양한 프로그래밍 언어(예: Fortran, Python, MATLAB) 기반의 상용 및 오픈소스 해석 패키지(예: WinGLink, GEOTOOLS MT; MTpy, Krieger and Peacock, 2014; ModEM, Kelbert et al., 2014; SimPEG, Cockett et al., 2015)가 다수 개발되었으나, 응용 소프트웨어 조작의 복잡성과 매개변수 설정의 난이도로 인해 비전문가나 초보 연구자에게는 여전히 높은 진입 장벽이 존재한다.
최근 인공지능(artificial intelligence, AI) 및 기계학습 기술의 급격한 발전으로 지구물리 탐사 자료의 처리와 패턴 인식 분야에서도 데이터 기반의 유용한 응용 연구들이 활발히 보고되고 있다(Bergen et al., 2019). 특히 트랜스포머(Transformer) 아키텍처에 기반한 대규모 언어 모델(Large Language Model, LLM)의 등장은 인간 중심의 자연어 인터페이스를 통해 질의응답, 문서 요약, 코드 생성 및 추론 보조 등의 작업을 수행할 수 있는 새로운 패러다임을 제시하였다. 지구과학 분야에서도 지구과학 지식에 특화된 언어 모델(K2; Deng et al., 2024)이 개발되었으며, LLM 기반 자료 분석 워크플로우(Zhang et al., 2025), 탄성파 자료처리 워크플로우에의 생성형 AI 적용(Kanfar et al., 2025), 수리지구물리 자료 해석(Chen, 2026), GPR 영상 해석(Zhang et al., 2026) 등에 LLM 에이전트를 적용한 사례가 보고되고 있다.
그러나 기본 LLM은 사전 학습 데이터에 내재된 지식(parametric knowledge)에 의존하는 폐쇄적 구조를 가지므로, 런타임 환경에서 로컬 파일 시스템의 탐사 데이터를 직접 조회하거나 독립적인 수치해석 바이너리를 자율적으로 구동하는 데 근본적인 한계가 있다. 이러한 제약을 극복하고 언어 모델과 외부 공학 도구 간의 상호운용성을 체계화하기 위해 개방형 표준 프로토콜인 Model Context Protocol(MCP)이 제안되었다(Anthropic, 2026). 지구물리 분야에서는 Ren et al.(2025)이 MCP를 이용하여 지진파 수치모델링 도구(SPECFEM)를 제어하는 에이전트를, Chen et al.(2026)은 MCP 기반 환경에서 사용자 개입(human-in-the-loop)을 포함한 다중 에이전트 물리검층 해석 체계를 제시하였다. 앞서 언급한 연구들은 탄성파, 검층, 수리지구물리, GPR 등을 대상으로 하였으나 MT 2차원 역산에서는 기존 역산 엔진을 수정없이 MCP로 연계하고 자료 처리부터 역산 결과 평가까지의 과정을 해석자와 대화형으로 수행한 사례는 아직 보고된 바 없다.
본 연구에서는 2차원 MT 역산 워크플로우에 MCP 표준 인터페이스를 도입하여, LLM이 탐사 자료의 전처리, 해석용 가상 측선 설정, 역산 블록모델 설계, 역산 제어 파라미터 최적화 및 연산 실행, 역산 결과 시각화 및 모델 평가에 이르는 전 과정을 유기적으로 제어하는 AI Agent(인공지능 에이전트) 시스템을 구축하였다. 이와 동시에 이러한 전 과정을 그래픽 사용자 인터페이스(graphical user interface, GUI) 환경과 실시간으로 연동하여 단일 MATLAB 작업공간(workspace) 세션 내에서 작동하게 함으로써, 전문가의 의사결정과 인공지능의 자율 실행이 결합된 “Human-in-the-Loop” 개념을 확장한 이른바 “지능형 역산 해석 루프(AI–Human–Inversion Loop)”를 구현하였다. 이를 통해 MT 역산 해석 과정의 진입 장벽을 완화하고, 전주기 워크플로우의 자동화 가능성을 실증하는 새로운 방법론을 제시하고자 한다.
이론적 배경
대규모 언어 모델(LLM) 개요 및 특징
최근 인공지능 기술의 발전에 따라 대규모 언어 모델(Large Language Model, LLM)은 학계와 산업계를 넘어 다양한 실무 분야에서 핵심적인 도구로 활용되고 있다. LLM은 방대한 양의 텍스트 데이터를 사전 학습(pre-training)하여 인간의 언어를 높은 수준으로 이해하고 생성할 수 있도록 설계된 트랜스포머(Transformer) 아키텍처 기반의 생성형 인공지능(generative AI) 모델이다(Vaswani et al., 2017). 대표적인 범용 LLM으로는 OpenAI의 GPT 계열, Anthropic의 Claude, Google의 Gemini 등이 있으며, 질의응답, 문서 작성 및 요약, 정보 검색, 코드 생성, 프로그램 디버깅 등 광범위한 작업을 수행할 수 있다.
이와 같이 LLM이 기존 소프트웨어 환경과 차별화되는 가장 큰 특징은 ‘자연어 인터페이스(natural language interface)’를 제공한다는 점이다. LLM을 이용하여 사용자는 기계 중심의 복잡한 명령어 구조나 특정 프로그래밍 언어를 직접 사용하지 않고도 일상적인 대화형 언어를 통해 모델에게 원하는 작업 목표를 명시할 수 있다. 또한 모델은 입력된 문맥(context)을 해석하여 의도에 부합하는 적절한 텍스트 응답이나 수행 명령을 동적으로 생성해낸다. 이러한 인간 중심적 인터페이스 특성은 그 자체만의 적절한 이용으로도 공학 및 과학 연구 영역에서 특정 전문 소프트웨어가 지닌 조작의 복잡성을 완화하고, 대규모 데이터 분석 및 처리 자동화의 진입 장벽을 낮춤으로써 사용자의 접근성과 생산성을 혁신적으로 향상시키는 데 기여하고 있다.
물리탐사 및 과학·공학분야 적용에서의 LLM의 한계
LLM은 학습 데이터에 내재된 지식을 기반으로 응답을 생성하기 때문에, 학습 시점 이후에 발생한 정보나 지식은 알 수 없다는 근본적 한계를 가진다. 또한, 연구실 내부의 고유 데이터나 비공개 연구 자산, 당일 측정된 탐사 데이터 등은 사전 학습 범위에 포함될 수 없으므로, LLM이 이러한 정보에 직접 접근하는 것은 원천적으로 불가능하다. 특히 역산 파라미터, 물성값, 물리 관계식과 같이 수치적 정확성이 요구되는 물리탐사 분야에서는 LLM이 실제 데이터에 근거하지 않은 수치나 물리적으로 타당하지 않은 결과를 생성하는 ‘환각(hallucination)’ 문제까지 발생할 수도 있다(Ji et al., 2023).
과학기술 및 공학 분야에서는 각 전문 영역별 데이터 처리 프로그램, 수치해석 소프트웨어, 대용량 파일 시스템 등 여러 도구들과의 유기적인 연계가 필수적으로 요구된다. 그러나, LLM은 외부 시스템과의 직접적인 연결성이 결여되어 있어 외부 하드웨어, 독립적인 전용 소프트웨어, 또는 정형 데이터베이스와 직접 상호작용하며 실시간 제어 명령을 내리는 데 근본적인 한계가 있다. 또한 공학 분야에서 사용되는 대다수 소프트웨어는 대개 특정 OS 환경의 실행 파일(executable binary) 형태로 실행되거나, GUI 기반, 또는 Fortran/C++ 등의 컴파일 언어로 작성되어 있으므로, 텍스트 입출력만 가능한 LLM은 이 소프트웨어의 실행 환경에 직접 명령을 내리거나 메모리 버퍼에 접근할 수 없어 공학 소프트웨어를 직접 제어하는 것이 불가능하다.
특히 물리탐사 분야의 자기지전류(MT) 탐사에서는 EDI(Electrical Data Interchange, Wight, 1988) 형식과 같이 오랜 기간 정착된 산업표준 형식의 측정 자료를 다루게 되는데, 이러한 형식은 해당 분야의 숙련자에게는 익숙하지만, 지구물리를 전공하였더라도 이 자료 형식을 처음 접하는 연구자에게는 그 구조와 처리 절차 자체가 진입장벽으로 작용할 수 있다. 이러한 전문 자료 형식의 처리, 대규모 탐사 자료 역산 실행, 역산 모델의 반복적 해석 및 갱신 등은 특정 실행 파일과 고유한 데이터 구조에 강하게 의존하는 고도로 전문화된 작업 절차이므로, LLM 단독으로는 이를 수행할 수 없다.
결과적으로 이러한 제약들을 극복하고 LLM의 자연어 인터페이스 가치를 공학 실무에 적용하기 위해서는, 모델 외부에 존재하는 전문 도구들을 자율적으로 호출하고 연동할 수 있는 아키텍처 기술이 필연적으로 요구된다.
도구호출(tool calling) 및 AI Agent
대규모 언어 모델(LLM)의 정보 접근성 제약과 외부 시스템과의 연계 한계를 극복하기 위해, 모델 외부에 존재하는 연산 자원 및 소프트웨어와 LLM을 유기적으로 결합하는 ‘도구 호출(tool calling)’ 기술이 제안되었다. 도구 호출은 LLM이 사용자의 지시문에서 의도(intent)를 분석하여, 단순한 텍스트 형태의 응답을 생성하는 대신 사전에 정의된 외부 API(Application Programming Interface) 함수의 이름 및 매개변수를 구조화된 함수 호출(structured function call) 형태로 출력하도록 하는 기술이다. 이를 통해 LLM은 독자적으로 수행할 수 없는 복잡한 수치 계산, 데이터베이스 쿼리, 외부 프로그램 실행 등의 작업을 외부 환경에 위임하고, 그 실행 결과값을 다시 입력받아 최종 응답을 반환할 수 있게 된다.
물리탐사를 비롯한 대부분의 과학 및 공학적 연구 환경에서는 데이터의 수집, 전처리, 수치 모델링, 결과 가시화에 이르는 일련의 복잡한 워크플로우의 자동화가 필수적이다. 이에 따라 도구 호출 메커니즘은 단순히 단발성 도구 실행에 그치지 않고, 복잡하고 유기적인 공학적 목표를 자율적으로 해결하는 인공지능 에이전트(AI Agent) 아키텍처로 진화하고 있다. AI Agent 시스템 내에서 LLM은 시스템의 ‘두뇌(brain)’ 역할을 수행하며, 주어진 공학적 문제를 해결하기 위해 필요한 단계를 스스로 계획(planning)하고, 적절한 도구를 선택하여 실행(action)한 뒤, 그 결과물을 관찰(observation)하여 다음 단계를 반복적으로 수행하는 자율적 제어 루프를 형성한다. 이러한 구조는 추론과 행동을 결합한 ReAct(Reasoning and Acting) 패러다임에 기반한 대표적인 AI Agent 구현 방식으로 널리 활용되고 있다(Yao et al., 2022). 이러한 패러다임 하에서 AI Agent는 Fortran이나 C++로 작성된 레거시 수치해석 바이너리 모듈, Python 기반의 데이터 분석 라이브러리, 파일 시스템 관리자 등 서로 다른 인터페이스를 가진 이기종 도구들을 연구 상황에 맞게 조합하고 제어할 수 있는 유연성을 제공한다. 이처럼 도구 호출과 AI Agent 기술은 정적인 언어 모델을 동적이고 자율적인 공학 연구 보조 시스템으로 확장시키는 핵심 패러다임으로 자리 잡고 있다.
그러나 이러한 개별 도구 호출 기반의 접근 방식은 각 도구마다 서로 다른 API 명세와 입력 포맷을 사용하기 때문에, 새로운 도구가 추가되거나 변경될 때마다 개별 연동 방식을 수동으로 구현해야 하므로 개발 및 유지보수 비용이 증가한다. 또한 이기종 소프트웨어 간의 데이터 형식, 통신 규약, 접근 권한 체계가 상이하여 시스템의 확장성과 상호운용성(interoperability) 확보에 어려움이 존재하며, 도구의 수가 증가할수록 전체 시스템의 통합 복잡성이 기하급수적으로 증가하는 파편화 문제가 발생한다. 따라서 다양한 외부 도구와 데이터 자원을 일관된 방식으로 유연하게 연결하기 위한 아키텍처 수준의 표준화된 인터페이스 필요성이 대두되었으며, 이러한 파편화 문제를 극복하고 통합 연결 체계를 제공하기 위해 개방형 표준 규약인 Model Context Protocol(MCP)이 제안되었다.
Model Context Protocol(MCP)
앞서 살펴본 바와 같이 도구 호출과 AI Agent 기술은 LLM의 한계를 극복할 수 있는 강력한 패러다임이지만, 기존의 개별적 도구 호출 방식은 활용하고자 하는 외부 도구나 인공지능 모델의 종류가 늘어날수록 통합 및 유지보수 비용이 기하급수적으로 증가하는 한계가 있다. 이러한 시스템적 파편화 문제를 해결하기 위해 제안된 새로운 개방형 표준 인터페이스가 바로 Model Context Protocol(MCP)이다(Anthropic, 2026). MCP는 인공지능 애플리케이션이 외부 데이터 소스 및 전문 도구와 안전하고 유기적으로 연결될 수 있도록 지원하는 오픈소스 표준 규약이다.
MCP는 기본적으로 클라이언트-서버(client-server) 아키텍처를 채택하여, 인공지능 애플리케이션 프레임워크인 클라이언트(client)와 실제 데이터 및 도구를 구동하는 서버(server) 레이어를 명확히 분리한다. 즉, 대규모 언어 모델을 탑재한 호스트(host) 시스템은 MCP 클라이언트를 통하여 다양한 MCP 서버에 외부 데이터 제공이나 특정 도구의 실행을 표준화된 방식으로 요청하게 된다. 이는 하드웨어 생태계에서 개별 기기마다 별도의 포트를 만들지 않고 ‘USB-C’라는 범용 인터페이스 표준을 통해 마우스, 모니터, 저장장치 등을 플러그앤플레이(plug-and-play) 방식으로 연결하는 것과 유사한 메커니즘이다.
이러한 MCP 구조 내에서 연구자는 보유한 공학 소프트웨어나 데이터 자원을 MCP 표준 규격에 맞춘 ‘MCP 서버’로 한 번만 구현하면, 향후 백엔드의 언어 모델이 변경되더라도 별도의 연동 코드를 재개발할 필요 없이 즉각적인 상호운용성을 확보할 수 있다. MCP 표준 사양은 외부의 문맥(context) 정보를 모델에 동적으로 제공하기 위해 다음과 같은 세 가지 핵심 아키텍처 요소를 정의하고 있다.
• 도구(tools): LLM이 분석 과정에서 자율적으로 호출하고 실행할 수 있는 실행 파일, 함수, 스크립트 등의 API 인터페이스를 의미한다. 본 연구의 맥락에서는 영속적 MATLAB 작업공간에 명령을 전달하여 EDI 관측 자료 처리, 자동 품질 관리(Auto-QC), 2차원 측선 정의 및 텐서 회전, 수치 역산(inversion) 알고리듬 구동 등을 원격 실행하는 MATLAB MCP 서버의 함수 호출 인터페이스가 이에 해당한다.
• 자원(resources): 파일 시스템, 정형·비정형 데이터베이스, 실시간 센서 데이터 등 LLM이 데이터 보안을 침해하지 않는 한계 내에서 읽어 들여 문맥 창(context window)에 포함할 수 있는 정적·동적 데이터 자원을 의미한다. 본 연구에서는 도메인 전문 지식 및 파이프라인 단계별 처리 규칙을 체계적으로 구조화한 마크다운(Markdown) 명세 문서를 비롯하여, 현장 EDI 관측 자료와 역산 제어 로그 파일 등을 파일 시스템 기반의 자원으로 공급하여 LLM의 맥락 이해를 지원한다.
• 프롬프트(prompts): 특정 공학적 작업이나 워크플로우에 최적화된 사전 정의 프롬프트 템플릿을 서버 측에서 클라이언트에 동적으로 공급하는 기능이다. 이는 사용자가 대화창에 직접 입력하는 일반적인 자연어 질의문과 구분되며, 서버가 제공하는 표준 질의 규격을 통해 모델이 복잡한 작업 문맥을 신속하게 구성하도록 돕는 역할을 한다.
MCP는 기존의 일회성, 종속적이었던 도구 호출 기술을 아키텍처 수준에서 표준화함으로써, 과학기술 및 공학 분야의 복잡하고 다양한 레거시 소프트웨어와 대용량 데이터 자원을 AI Agent 생태계에 유기적이고 안전하게 결합할 수 있는 상호운용성(interoperability)의 기반을 제공하는 것으로 요약할 수 있다. 다만 MCP의 적용에는 서버와 호스트 간 버전 의존성, 다수 서버 운용에 따른 시스템 구성의 복잡성, 파일 및 실행 도구에 대한 접근 권한과 보안 문제가 수반된다(Hou et al., 2026; Ray, 2025). 또한 MCP는 도구 연결의 표준화를 제공할 뿐 해석 결과의 정확성이나 과학적 타당성을 보장하지 않으므로, 최종 판단에는 해석자의 검증이 필요하다.
MCP 기반 MT 2차원 역산 AI Agent 시스템 구현
본 장에서는 MT 2차원 역산 해석을 위한 AI Agent 워크플로우의 구성을 서술한다. MT 자료 해석의 일반적 절차와 본 연구의 필요성을 개관하고, 다음에서는 시스템의 세부 구성 요소와 설계를 기술한다.
MT 자료 처리 및 해석 워크플로우 개요
일반적으로 MT 탐사 자료의 처리 및 해석은 현장에서 측정한 전기장과 자기장의 시계열(time-series) 데이터로부터 원거리 기준점(remote reference) 처리 및 로버스트(robust) 추정법 등을 적용하여 주파수 영역의 임피던스(impedance) 텐서를 추출하는 단계로 시작된다. 대다수의 상용 및 공개 소프트웨어에서는 임피던스 텐서(Z)의 각 성분(Zxx, Zxy, Zyx, Zyy)을 계산하기 위해 전기장 채널(Ex, Ey), 자기장 채널(Hx, Hy, Hz), 그리고 원거리 준점 채널(RHx, RHy) 간의 자기상관(auto-correlation) 및 상호상관(cross-correlation)에 대응하는 스펙트럼(auto-spectra 및 cross-spectra)을 연산한다. 이로부터 주파수별 임피던스, 겉보기비저항, 위상, 티퍼(tipper) 등의 주요 MT 파라미터가 산출될 수 있으며, 대체적인 경우 개별 측점 단위로 스펙트럼 자료를 산업 표준인 EDI(Electrical Data Interchange) 포맷으로 저장되어 배포되는데 이는 추후 임피던스 회전 등을 용이하게 하기 위함이다.
다음 단계에서는 각 측점의 임피던스 자료를 활용하여 위상 텐서(phase tensor) 분석을 통한 왜곡 분석(distortion analysis), 전기적 주향(strike) 및 차원성(dimensionality) 분석을 수행한다. 이를 통해 탐사 지역의 구조적·지질학적 특성을 파악하고, 전자기적 잡음에 의해 왜곡된 대역이나 이상치를 전문가의 지식과 경험에 기반하여 편집·제거하는 품질 관리(Quality Control, QC) 과정을 거쳐 신뢰성 있는 관측 자료를 선별한다.
정제된 관측 자료는 측점의 기하학적 배치, 차원성 분석 결과, 정적 효과(static effect)의 영향 등을 종합적으로 검토하여 2차원 또는 3차원 수치 역산을 통해 최종 지하 전기비저항 모델로 도출된다. 특히 2차원 역산 해석을 수행할 경우, 광역 지질 주향을 고려하여 최적의 2차원 투영 측선을 설정하고, 측선 방향에 부합하도록 임피던스 텐서를 회전하여 전자기장 성분을 TM(Transverse Magnetic) 모드와 TE(Transverse Electric) 모드로 분리하는 작업이 수반된다.
이후 2차원 수치 모델링 단계에서는 요구되는 분해능과 가탐심도 조건을 만족하도록 역산 블록모델을 설계하고, 정확한 순방향 모델링(forward modeling) 계산을 위해 각 블록을 더 세분화한 유한요소 격자(mesh)를 구성한다. 또한 탐사 지역의 지형 기복이나 천부 정적 효과의 유무에 따라 지형 효과를 고려하여 모델링을 계산하거나 또는 정적 효과를 역산 모델의 미지수(unknown parameter)로 포함시킨다. 실제 역산 수행 과정에서는 목표 자료 오차 수준(target RMS misfit), 모델 평활화 제약(smoothness constraint)에 대한 가중 계수 등을 조절하며 수많은 역산 시도와 모델 평가(appraisal)를 반복 수행하게 된다.
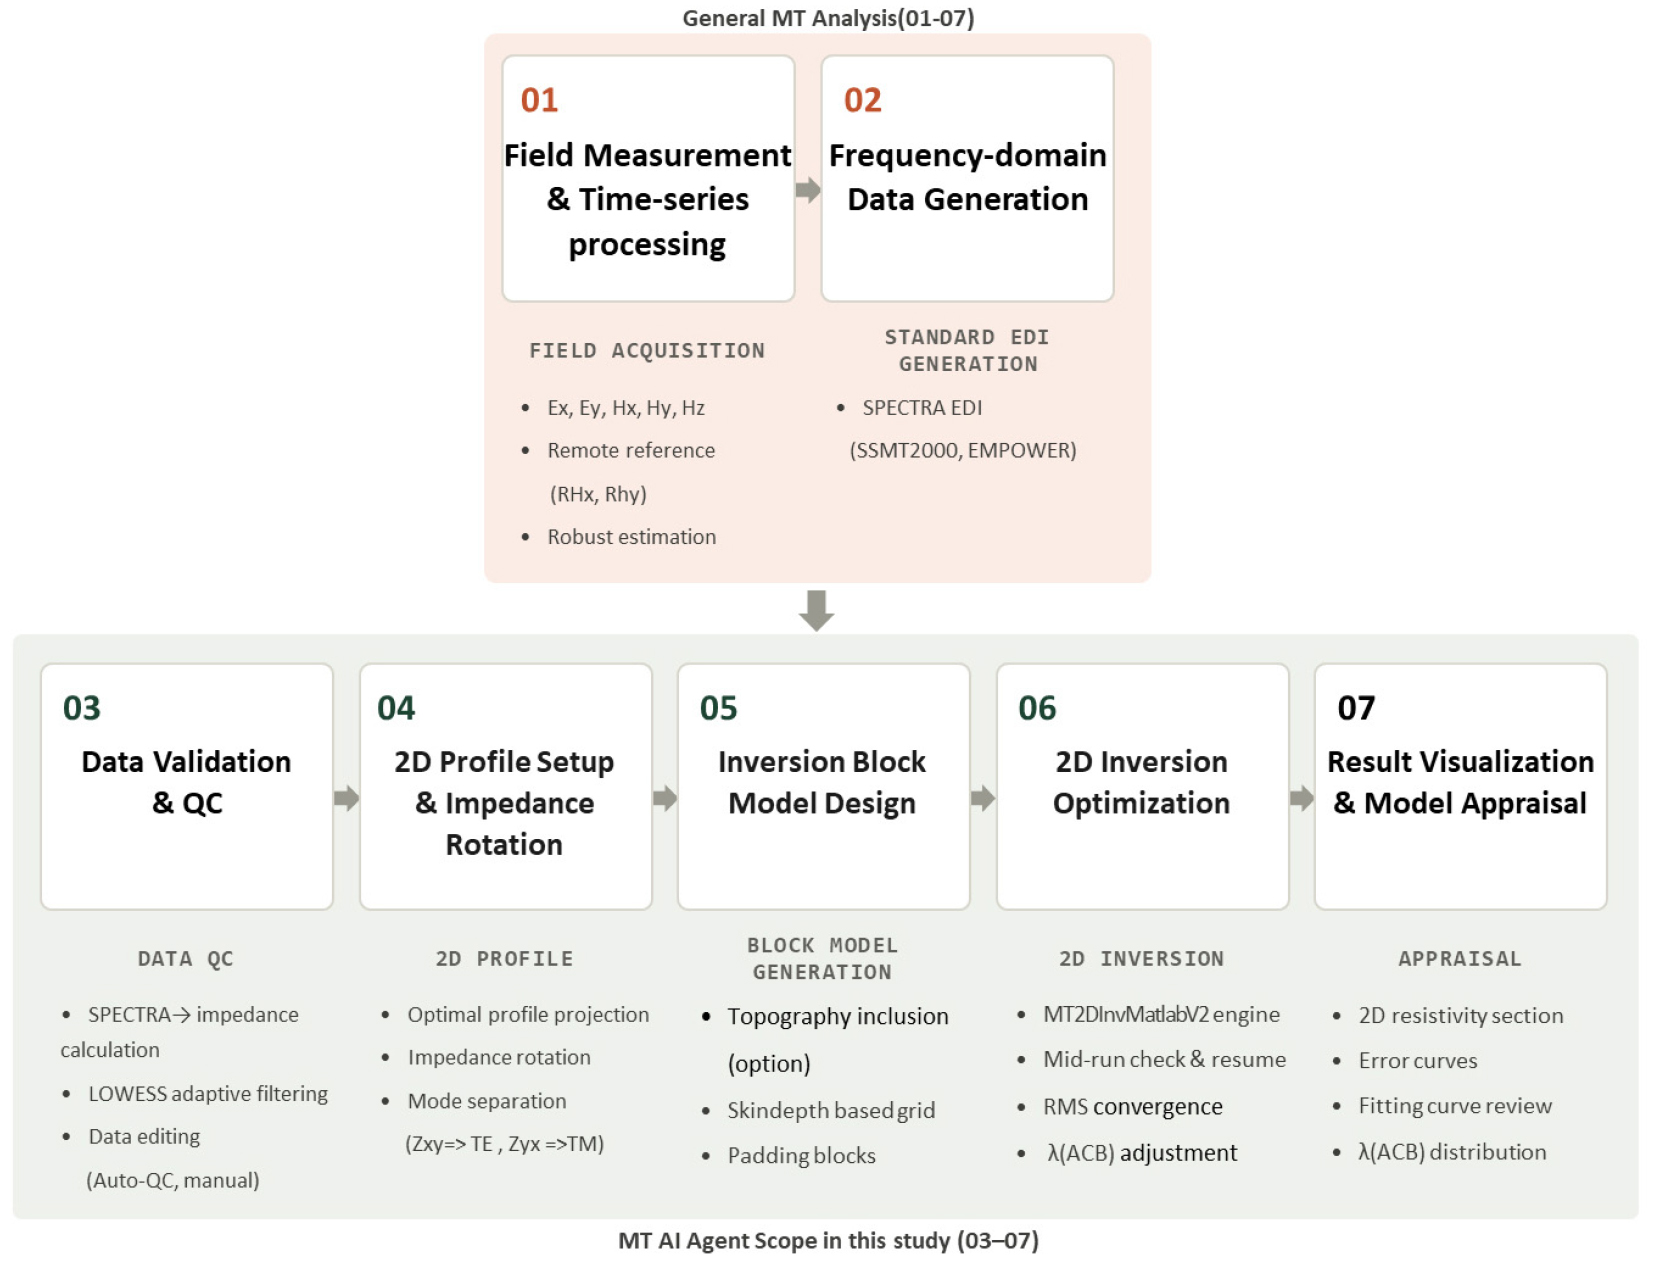
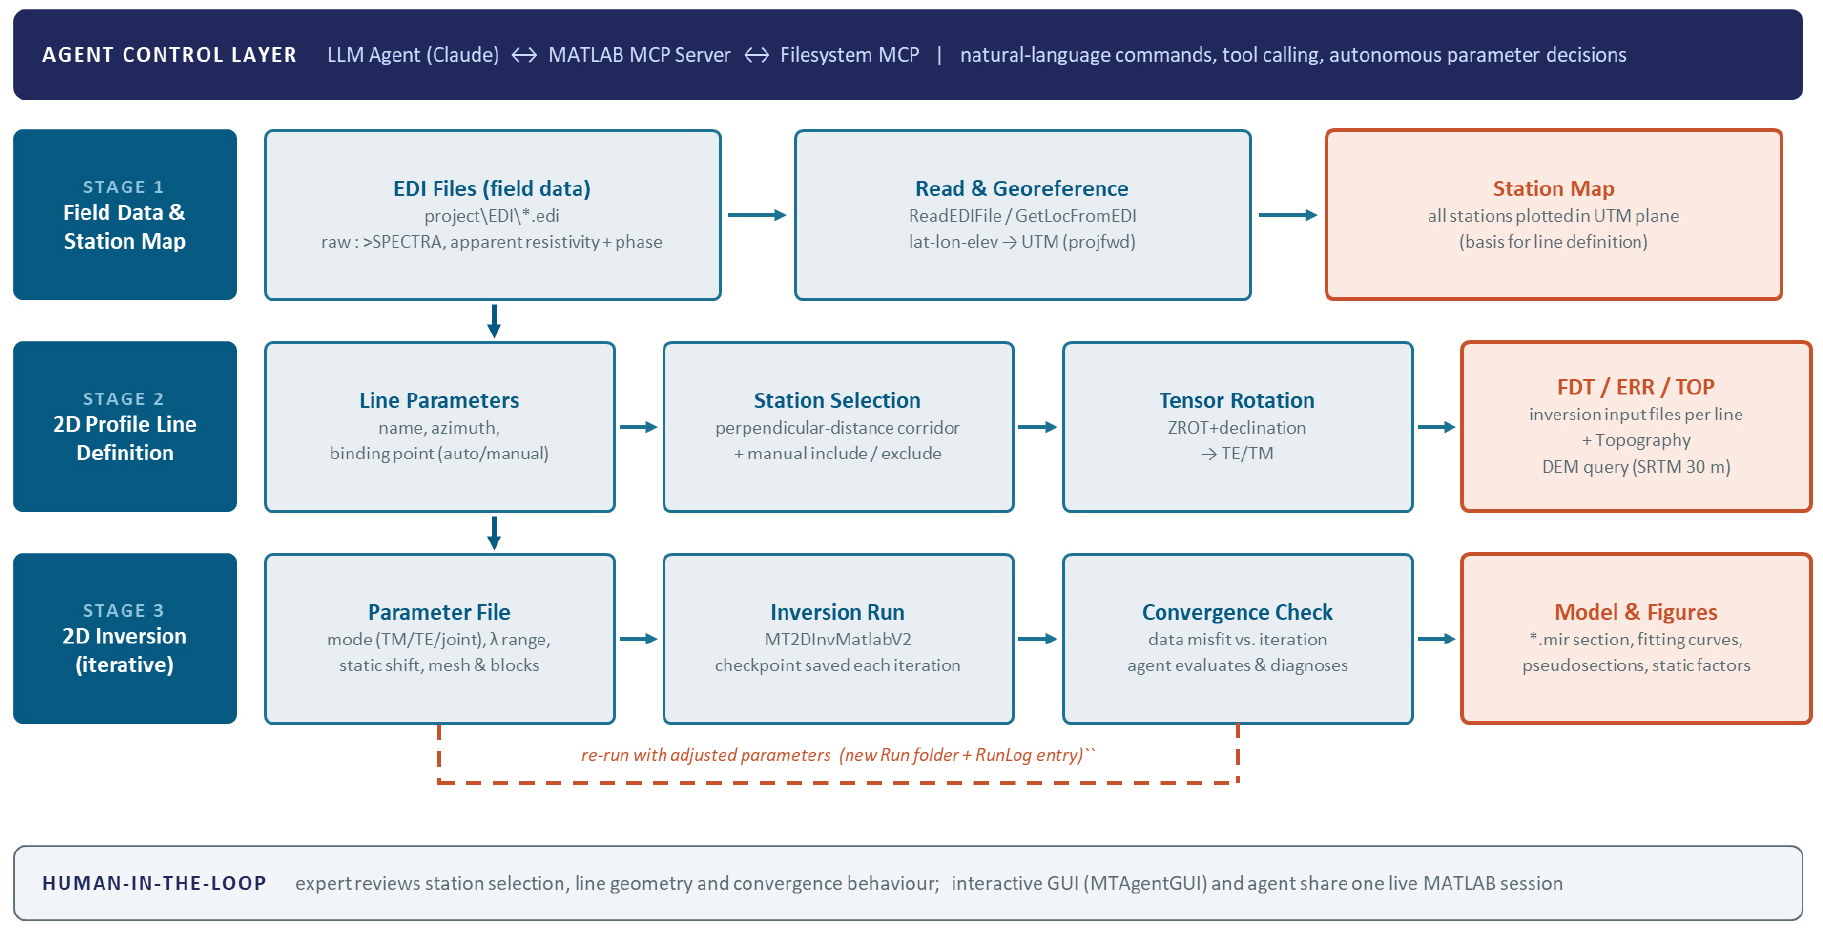
이와 같이 MT 탐사의 전주기 해석 워크플로우는 Fig. 1에 나타난 바와 같이 시계열 처리부터 최종 모델 평가에 이르기까지 매우 방대하고 복잡하다. 본 연구에서 제안하는 MT AI Agent 시스템은 이 중 시계열 처리 과정을 제외한 [표준 EDI(SPECTRA 혹은 임피던스) 입력 → 측점별 QC → 2차원 가상 측선 설정 및 임피던스 텐서 회전 → 지형 효과 고려 여부 결정 → 표피심도 기반 역산 블록 설계 → 다양한 역산 파라미터를 설정한 MT2DInvMatlabV2를 이용한 수치 역산 → 역산 결과 시각화 및 결과 평가]에 이르는 2차원 역산 해석을 위한 전·후처리 및 핵심 해석 워크플로우의 자율적 제어에 초점을 맞춘다. 이러한 과정을 개념적으로 Fig. 1에 순서도로 표시하였다.
MT 탐사 2차원 역산 AI Agent 전체 시스템 개요
시스템 설계 철학
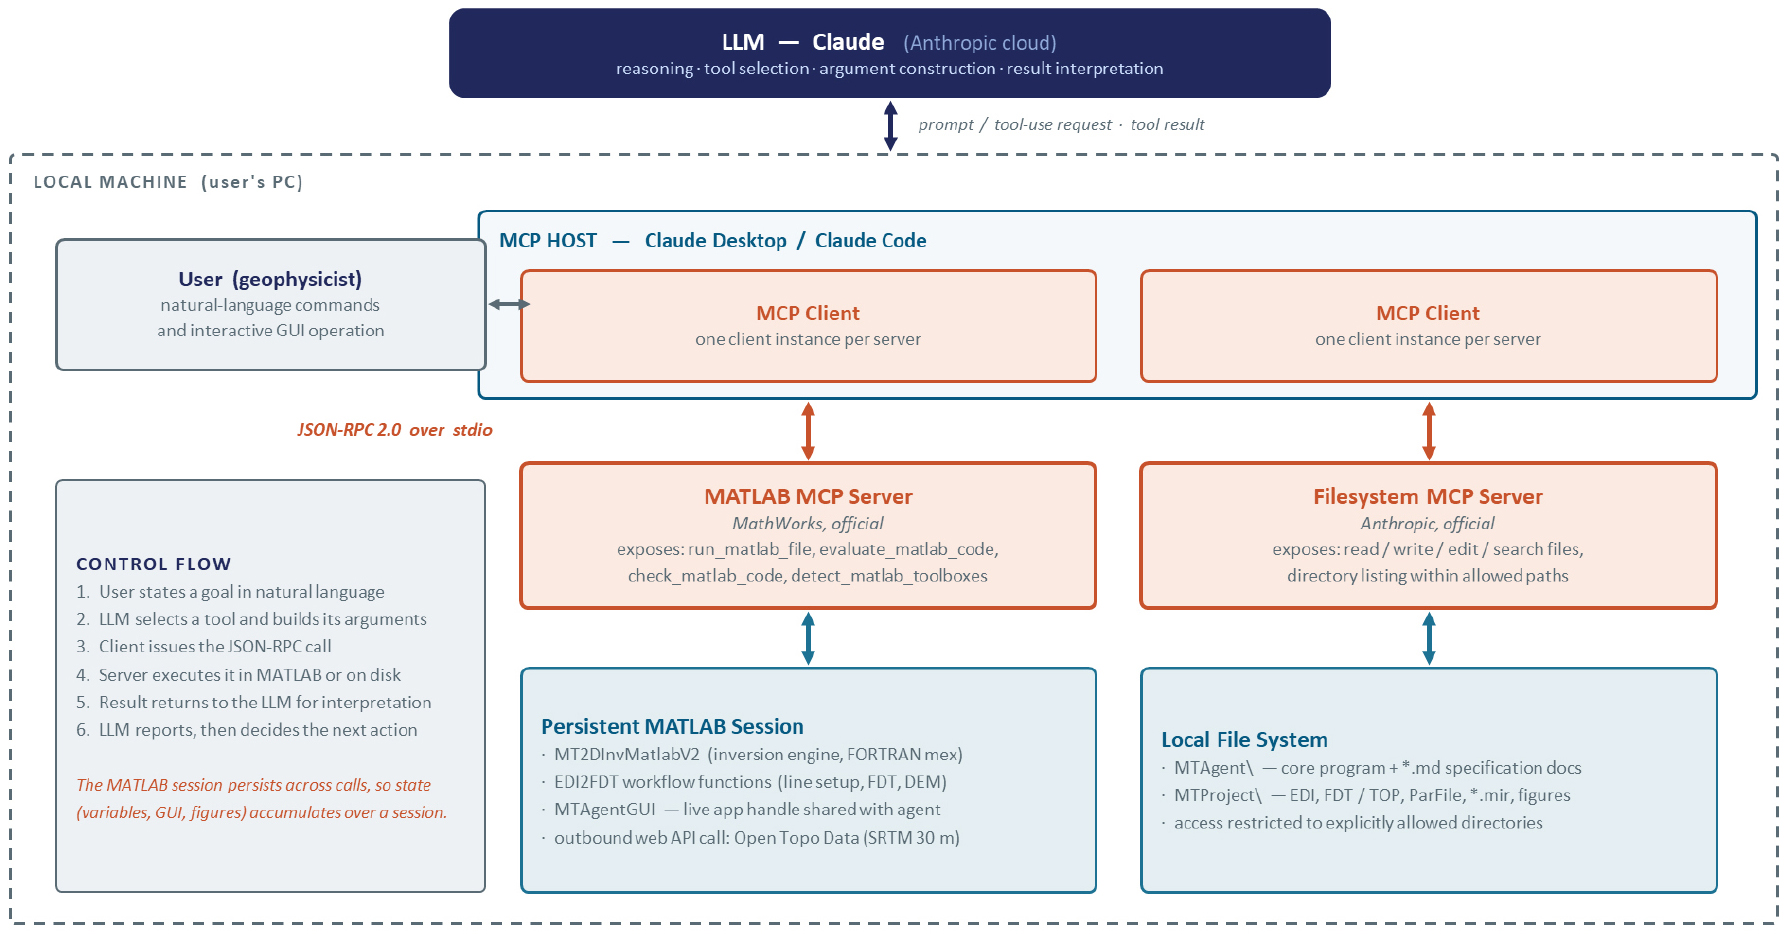
지구물리 역산은 부적정(ill-posed) 문제로서 해의 비유일성과 불안정성(Zhdanov, 2002)을 내재하므로, 타당한 지하 모델을 얻기 위해서는 역산 블록 모델 설정, 수치 격자(mesh) 설계, 평활화(smoothing) 계수 조절, 목표 오차(target RMS misfit) 제어 등 고도의 전문 파라미터 최적화 작업이 반복되어야 한다. 본 연구에서는 이러한 제약을 극복하고 해석 프로세스의 효율성을 극대화하기 위해, 거대언어모델(LLM)이 외부 수치해석 엔진을 자율적으로 제어하는 MT 2차원 역산 AI 에이전트(AI Agent) 환경을 설계하였다(Fig. 2).
본 시스템은 MathWorks의 공식 MATLAB MCP Server와 Anthropic의 공식 Filesystem MCP Server를 기반 통신 인프라로 채택하였다. 본 연구의 핵심 설계 전제는 기존 수치 계산 코드를 수정 없이 그대로 활용하는 데 있다. 기존에 발표된 2차원 역산 알고리듬인 MT2DInvMatlab(Lee et al., 2009) 기반의 수치 계산 엔진(MT2DInvMatlabV2)을 에이전트 전용으로 재작성하거나 변형하지 않고 가능한 한 원본 그대로 유지하며, 에이전트가 연구자가 사용하는 것과 동일한 경로(표준 API 및 스크립트 실행)로 프로그램에 접근하도록 구축하였다. 따라서 본 시스템이 산출하는 수치 결과는 에이전트의 개입 없이도 독립적으로 100% 동일하게 재현된다. 본 연구에서는 LLM이자 MCP 호스트(host)로 Anthropic의 Claude(주 모델: Sonnet 5)를 사용하였다. 구체적으로 Claude Desktop을 중심으로 구현·검증하였으며, Claude Code 등 동일한 표준 프로토콜을 지원하는 다른 MCP 호스트 환경에서도 상호운용이 가능하다.
시스템 계층 구조 및 이중 MCP 서버
본 시스템은 역할과 책임이 명확히 분리된 다음과 같은 4단계 계층 구조로 운용된다.
• 추론 계층(Inference Layer; Cloud LLM): 대규모 언어 모델은 대용량 수치 계산을 직접 수행하지 않고, 사용자의 자연어 지시와 데이터 상태를 종합적으로 해석하여 실행할 도구를 결정하고, 파라미터를 조립하며, 수치 연산 결과 및 수렴 로그를 진단하는 역할을 전담한다.
• 호스트 계층(Host & Client Layer): 사용자 인터페이스 환경인 Claude Desktop(Host) 내에서 개별 MCP 서버와 통신하는 전용 클라이언트(Client)가 각각 인스턴스화되며, 표준 입출력(stdio) 기반의 JSON-RPC 2.0 프로토콜을 통해 요청과 응답 메시지를 중계한다.
• 도구 계층(Tool Layer; Dual MCP Servers): 독립적인 두 개의 공식 MCP 서버를 통해 연산 제어와 데이터 입출력을 명확히 분리하여 수행한다.
- MATLAB MCP Server: MathWorks 공식 서버로서, 영속적 작업 공간 내 스크립트 실행(‘run_matlab_file’), 코드 평가(‘evaluate_matlab_code’), 문법 및 코드 유효성 검사(‘check_matlab_code’) 인터페이스를 에이전트에 제공한다.
- Filesystem MCP Server: Anthropic 공식 서버로서, 사전에 명시적으로 인가된 프로젝트 작업 경로에 한해서만 에이전트의 파일 읽기 및 쓰기 권한을 부여함으로써 파일 시스템 접근에 대한 안전 경계를 엄격히 확립한다.
• 실행 엔진 계층(Execution Layer): 로컬 환경에서 구동되는 MATLAB R2026a 및 MT2DInvMatlabV2 수치 역산 엔진으로 구성된다. 이 계층은 에이전트의 매 호출마다 새로 시작되는 일회성 프로세스가 아니라, 동일한 메모리 상태를 지속적으로 유지하는 단일 영속적 세션(persistent session)으로 운용된다.
영속적 세션(Persistent Session)과 작업 공간 분리
본 시스템의 가장 큰 특징은 지속성을 갖는 영속적 MATLAB 세션(persistent MATLAB session)을 공유한다는 점이다. 단발성 API 호출과 달리 세션이 프로세스 수준에서 계속 유지되므로, 선행 도구 호출에서 생성된 워크스페이스 변수, 그림 창(Figure) 핸들, UI 상태가 전체 해석 과정 동안 실시간으로 보존된다. 따라서 역산 도중 이상 거동이나 발산 징후가 발생할 경우, 에이전트가 해당 워크스페이스 내의 중간 변수를 직접 조회하여 물리적 원인을 능동적으로 진단할 수 있다. 또한 프로그램 모듈(역산 엔진, GUI, 명세 문서)과 사용자 프로젝트 데이터(현장 관측 자료, 역산 결과, 수치 모델링 결과물)를 독립된 디렉터리로 엄격히 분리하여 배포 단위의 독립성과 현장 자료 관리의 안전성을 동시에 확보하였다.
명세 문서를 통한 전문 지식의 문맥화
MCP의 자원(resources) 요소를 프로그램 디렉터리에 위치한 마크다운(Markdown) 형식의 구조화된 명세 문서(specification documents)들로 구현하였다. 이 문서들은 각 역산 파라미터의 물리적 의미, 경험적 수렴 판정 기준(RMS misfit 임계치), 단계별 의사결정 규칙, 디렉터리 및 파일 명명 규약 등을 체계적으로 기록한다. 새로운 대화 세션이 시작되면 에이전트가 파일 시스템 자원을 통해 이 명세 문서를 우선적으로 읽어들여 사전 지식(prior knowledge)으로 문맥 창에 탑재한다. 이를 통해 전문가의 도메인 지식 체계가 편집 가능한 외부 문서 형태로 분리 주입되므로, 역산 제어 규칙이나 최적화 전략이 갱신되더라도 핵심 수치해석 엔진의 소스 코드를 수정할 필요가 없다는 아키텍처적 유연성을 확보하였다.
에이전트 기반 2차원 역산 워크플로우 및 협업 제어
EDI 현장 자료 입력 및 품질 관리(Stage 1)
현장 관측 자료인 EDI 파일의 헤더 정보로부터 측점 좌표(위도·경도·표고)를 추출하고 UTM 투영 좌표계로 변환하여 측점의 공간적 분포를 가시화한다. 본 시스템은 겉보기비저항과 위상 등이 사전 계산된 EDI 파일뿐만 아니라, 크로스파워 원시 자료만 수록된 ‘>SPECTRA’ 블록 전용 EDI 파일을 자동으로 판별하여 읽어들인다. 이때 스펙트라 자료가 입력될 경우 주파수별 임피던스 텐서와 겉보기비저항, 위상, 티퍼(tipper) 등의 MT 탐사의 물리량을 자동으로 복원·계산한다.
관측 자료의 신뢰도를 확보하기 위해 주파수별 이상치와 잡음을 효과적으로 선별하는 자동 품질 관리(Auto-QC) 모듈을 지원한다. 이 모듈은 위상의 물리적 정상 범위 판별 및 상대 오차 임계치 검사를 우선적으로 수행한 후, 주파수 로그 축상에서 국소선형회귀(LOWESS; locally weighted scatterplot smoothing, tricube 가중치)를 적용하여 전체 곡선의 대표 추세선과 이상치를 견고하게 분리한다. 이를 통해 인접한 다중 이상치에 의한 왜곡 현상을 방지하며, 계산된 추세선과 잔차는 대화형 인터페이스를 통해 시각적으로 표출되어 연구자가 특정 자료점을 수동 편집(제거 혹은 복원)할 수 있는 상호보완적 검증 체계를 제공한다.
기하학적 2차원 측선 정의 및 텐서 회전(Stage 2)
2차원 수치 해석을 위해 가상 측선을 특정 기준점(binding point)과 방위각, 혹은 두 점을 잇는 직선으로 설정하고, 이에 포함될 측점들을 측선까지의 수직 허용 거리 등 기하학적 공간 조건으로 정의한다. 측점 명칭이나 번호 체계에 구애받지 않고 중심선과 허용 수직거리 폭만으로 대상 측점을 필터링하므로, 서로 다른 시기에 취득되어 복수의 라인을 가로지르는 측선이나 임의 방향의 측선도 자유롭게 설정할 수 있다.
설정된 2차원 측선에 따라 측선 방향과 수직인 지질 주향에 맞추어 임피던스 텐서를 회전하고 2차원 물리량을 재계산한다. 이때 진북 기준 측선의 방위각과 지역적 자기편각(magnetic declination), 그리고 원시 자료에 기록된 기존 회전각(ZROT)을 종합적으로 반영하여 새로운 임피던스 텐서(Z)를 계산하며, 180도 주기 불변성을 고려하여 회전각을 정규화한다. 회전된 좌표계에서는 대체로 xy는 TE 모드, yx는 TM 모드의 고정 규칙을 기본적으로 적용하나 연구자의 물리적 판단에 따라 TE/TM 모드를 수동으로 서로 바꿀 수 있는 유연성을 제공한다. 아울러 측점별 GPS 고도 및 수치표고모델(DEM)로부터 추출한 지형 데이터를 연계하여 역산 시 지형 기복의 반영 여부를 결정한다.
역산 매개변수 제어 및 중간 저장지점 기반 역산(Stage 3)
역산 영역은 겉보기비저항의 기하평균과 주파수 대역별 최대·최소 표피심도(δ), 목표 해석 심도(MaxDomain)를 연동하여 표층 셀 두께(SurfaceBlockThickness)를 결정하고, 이로부터 기하급수적으로 증가하는 수치 격자를 동적으로 설계한다. 이때 측점 중심 기반 격자 분할 방식을 적용하여 불필요하게 얇은 기둥 형태의 블록의 생성을 억제하고, 경계에서의 역산 왜곡을 최소화하기 위한 완충용 블록(padding)을 체계적으로 배치한다.
역산의 매 반복(iteration)마다 상태 파일(.mat)을 디스크에 저장하여 반복별 역산 상태를 중간저장지점(checkpoint)으로 보존한다. 만약 특정 반복 이후 자료 오차(RMS misfit)가 발산하거나 정체될 경우, 역산 블록모델 구조를 유지한다는 검증 하에 처음부터 다시 계산할 필요 없이 직전의 양호 시점 모델로부터 라그랑지안 평활화 계수(λ), 정적 효과 보정 여부, ACB(Active Constraint Balancing, Yi et al., 2003) 등의 제약 조건을 유연하게 수정하여 안전하게 역산을 재개할 수 있다.
에이전트는 개별 역산 시도마다 독립된 실행 폴더에서 파라미터 파일, 결과 모델(.mir), 반복별 중간저장지점 파일, 표준화된 가시화 도면(의사단면도, 자료 적합 곡선, 정적효과)을 별도로 보존하며, 역산 이력을 자동으로 누적한다.
해석자와 에이전트의 역할 분담(AI–Human–Inversion Loop)
에이전트는 반복 연산 실행, 파라미터 조정 및 설정, 오차 추이 모니터링 등의 정형화된 절차를 전담하며, 역산의 재실행 판단, 최종적인 지질학적 타당성 평가와 핵심 의사결정은 전문 해석자에게 귀속된다.
특히 본 시스템은 역산 제어용 그래픽 사용자 인터페이스(GUI, MTAgentGUI)와 AI 에이전트가 단일한 영속 MATLAB 세션을 실시간으로 공유하도록 설계되었다. 따라서 해석자가 GUI 화면에서 가상 측선이나 측점 포함 여부를 미세 조정하면 에이전트가 해당 세션의 변경 사항을 즉각 인지하고, 반대로 에이전트가 도출한 제어 명령이나 역산 결과가 GUI 화면에 실시간으로 동기화된다. 이러한 양방향 연동을 통해 해석자의 직관적 도메인 지식과 에이전트의 자율적 실행 역량이 긴밀히 결합된 유기적인 협업 환경인 소위 ‘AI–Human–Inversion Loop’를 구현하였다(Fig. 3).
에이전트 활용 역산 실험 및 검증
앞서 기술한 MT 탐사 자료 역산 AI 에이전트 시스템의 실제 적용성과 효율성을 평가하기 위해, 실제 광대역 현장 관측 자료를 대상으로 전주기 역산 실험을 수행하였다.
적용 탐사 자료 개요
본 연구에서 워크플로우 실증을 위해 채택한 현장 자료는 호주 빅토리아(Victoria)주 중부를 횡단하여 취득된 광역 MT 탐사 데이터이다. 해당 탐사는 2006년 GeoScience Victoria가 주관한 2차원 반사법 탄성파 탐사 측선(06GAV-02/03)과 거의 동일한 지질학적 측선을 따라 한국지질자원연구원(KIGAM), 호주, 일본의 국제 공동연구를 통해 수행되었으며, Phoenix Geophysics사의 MTU-5A 장비를 이용한 원거리 기준점(remote reference) 처리 방식으로 고품질의 전자기장 시계열을 획득하였다(Lee et al., 2013).
이 자료는 총 연장 약 169 km에 걸쳐 총 56개 측점으로 구성되며, 측점 간격은 중앙부 약 2 km, 양 끝단부는 약 4~6 km로 설계되었다. 관측 주파수 대역은 317 Hz부터 0.00034 Hz(주기 약 0.003~3,000 sec)에 이르는 광대역(broadband) 자료이다. 특히 본 연구에 사용된 56개 측점의 관측 데이터는 임피던스가 미리 계산된 결과가 아니라, 현장 시계열 상관 처리로부터 획득된 원시 크로스파워 스펙트럼(>SPECTRA 블록) 형태로 저장된 EDI 파일이다. 따라서 개별 측점 단위로 주파수별 임피던스 텐서 및 겉보기비저항, 위상 등의 MT 물리량을 산출하는 전처리 계산 과정이 필수적으로 수반되는 자료이다.
본 현장 자료는 2차원 MT 역산 엔진인 MT2DInvMatlab(Lee et al., 2009)의 초기 알고리즘 검증에 활용되었을 뿐만 아니라, 지질학적 구조 규명 및 현장 적용성 연구(Lee et al., 2013)의 핵심 대상 자료이기도 하다. 따라서 과거에 취득 및 해석되었던 레거시 현장 자료를 2026년 기준의 최신 생성형 AI 에이전트 기반 워크플로우를 통해 원시 스펙트럼 단계부터 자율적으로 재처리·역산한다는 점에서 공학적·방법론적 의의를 지닌다. 다만 본 연구의 핵심 목적은 Victoria 자료를 활용하여 AI 에이전트가 주도하는 전·후처리 및 수치 역산 통합 제어 파이프라인의 유효성을 입증하는 데 있으며, 선행 연구(Lee et al., 2009, 2013)에서 이미 확립된 심부 지질학적 해석을 변경하거나 역산 엔진 자체의 수치 알고리즘 성능을 비교·평가하고자 하는 것은 아니다.
에이전트 협업을 통한 구간별 측선 설정
앞에서 기술한 바와 같이, Lee et al.(2009, 2013)에서는 전체 측선의 시점과 종점을 잇는 직선(방위각 99°)에 직교하는 단일 대표 방향(N9°E)을 광역 지질 주향으로 설정하고, 56개 측점 전체를 하나의 단일 측선에 투영·회전하여 2차원 역산을 수행하였다. 그러나 광역 측점 분포 전체에 대해 획일적인 단일 주향을 적용하는 방식은 측선의 굴곡이 심하거나 국부 지질 구조선이 급격히 변화하는 구간에서 2차원 가정에 따른 근사 오차를 유발할 수 있다. 본 연구에서 구축한 워크플로우는 이러한 공간적 주향 차이를 정밀하게 반영하기 위해, 전체 탐사 구역을 복수의 소구간으로 분할하고 구간별로 독립된 방향각을 갖는 다중 가상 측선을 유연하게 구성할 수 있도록 지원한다.
가상 측선은 특정 기준점(binding point)과 방위각, 또는 두 점을 잇는 공간 직선으로 정의되며, 이 중심선으로부터 지정된 수직 허용 거리 폭 내에 위치하는 측점들을 기하학적 필터링을 통해 선별한다. 가상 측선의 방향각은 에이전트로부터 두 가지 알고리즘 방식으로 산출·제안된다. 첫째는 선택된 측점 집합 내에서 유클리드 거리가 가장 먼 두 종단점을 잇는 방법이며, 둘째는 측점 공간 좌표의 주성분분석(PCA)을 통해 측점 분포의 1차 분포축(first principal axis)을 통계적 대표 방향으로 도출하는 방법이다.
연구자는 특정 측점 번호 대역이나 공간 영역을 지정하여 에이전트에게 방향 추천을 요청함으로써, 관심 하위 구간에 대한 최적 2차원 투영 측선을 신속하게 시험 구성하고 그 타당성을 대화형으로 검증할 수 있다. 이러한 대화형 측선 분할 및 PCA 기반 파라미터 자동 도출 과정의 실제 상호작용 사례를 예시 4-1에 수록하였다. 에이전트는 단일 측선의 기하학적 한계(최대 수직 거리 이탈)를 사전에 감지하여 분할을 권장하며, 연구자의 자연어 질의에 맞추어 최적 방위각과 기준점을 즉각 재계산함으로써 2차원 투영의 물리적 신뢰도를 확보한다.
측선 설정은 Fig. 4와 같이 그래픽 사용자 인터페이스(GUI)를 통해 연구자가 방향각, 기준점, 허용 수직 거리를 입력창에 직접 설정하여 수행할 수도 있고, 자연어 대화를 통해 에이전트에게 지시하여 수행할 수도 있다. 두 경로는 어느 한쪽이 종속되거나 보조하는 관계가 아니라, 동일한 내부 수치 함수를 호출하는 상호 대등한 제어 인터페이스이다.
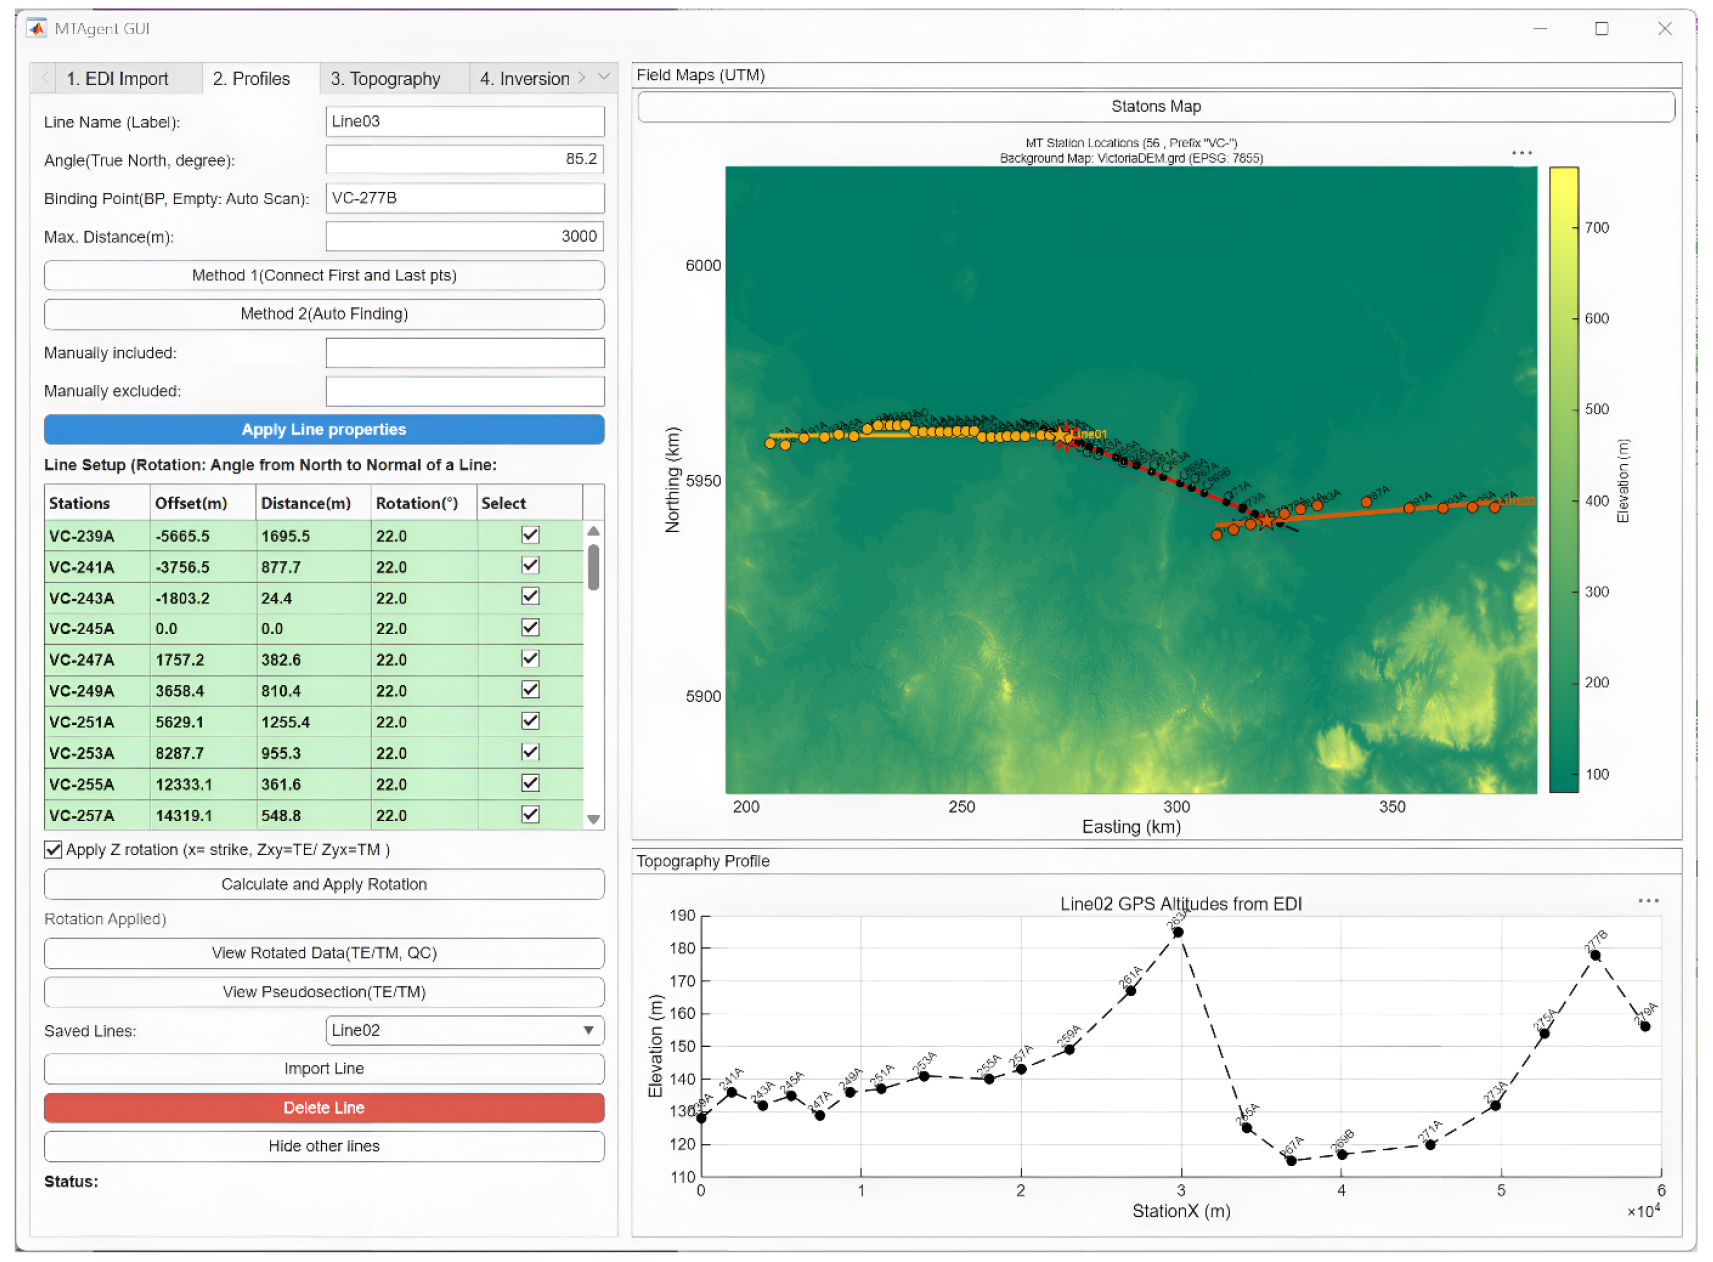
이러한 양방향 제어가 가능한 기술적 배경은 GUI와 에이전트가 단일한 영속 MATLAB 세션을 실시간으로 공유하기 때문이다. 예시 4-1의 대화형 실행 결과는 GUI 상에서 측선 명칭, 방향각, 대상 구간을 입력하고 적용 버튼을 실행하는 것과 내부적으로 동일한 결과를 산출하며, 실제로 명령 완료 즉시 GUI 화면의 측선 가시화 맵과 데이터 테이블에 세 개의 가상 측선(Line01, Line02, Line03)이 동시에 동기화되어 표출된다. 반대로 연구자가 GUI 화면의 측점 목록 테이블에서 개별 측점의 포함 여부를 체크박스로 직접 수정하거나 마우스로 미세 조정할 경우, 에이전트 역시 워크스페이스의 갱신된 메모리 상태를 즉각 인지하여 이후의 의사결정과 대화 맥락에 반영한다.
결과적으로 연구자는 복수의 후보 측선을 빠르게 생성하고 시험 분할하는 탐색적 단계에서는 대화형 지시를 활용하고, 최종 측선 배치와 이상 측점의 포함 여부를 정밀하게 시각적으로 검토할 때는 GUI 조작을 병행할 수 있다. 이처럼 작업의 성격과 해석 목적에 따라 두 인터페이스를 유연하게 상호 보완적으로 운용함으로써 단절 없는 유기적 해석 워크플로우를 유지할 수 있다. 선행 연구(Lee et al., 2009, 2013)에서 채택한 단일 대표 방향 측선과, 본 연구의 에이전트 협업 환경을 통해 도출된 3개 분할 측선의 구체적인 기하 파라미터 비교를 Table 1에 정리하였다. 단일 측선 적용 시 발생할 수 있는 굴곡 구간의 측점 이탈 오차를 줄이고, 공간적으로 상이한 지질 주향을 독립적으로 반영할 수 있도록 가상 측선을 체계적으로 재구성하였다.
Table 1.
Comparison of survey line configuration between the previous study and this study for the Victoria dataset
이렇게 구성된 세 측선의 공간 궤적을 측점 지도상에 중첩하여 도시한 결과, 서부(Line01) 및 동부(Line03) 구간은 약 85°~90°의 일관된 동서(E–W) 방향성을 유지하는 반면, 중앙 구간(Line02)은 112.0°로 뚜렷하게 회전된 방위각을 나타내었다(Fig. 4). 이는 전체 탐사 측선을 단일 대표 방향으로 일괄 근사했던 선행 연구의 방식이 특히 중앙 굴곡부에서 상당한 기하학적 투영 왜곡 및 주향 불일치 오차를 수반할 수 있음을 시사한다.
역산 자료 준비(자료 Q/C, 자료 회전)
앞절에서 구성한 측선에 대해 실제 역산 입력자료를 생성하기 위해서는, 크로스파워 스펙트럼으로부터 계산된 임피던스에 대해 이상치를 걸러내는 품질관리(QC)와 측선 방향에 정렬된 좌표계로의 회전이 필요하다. 두 작업 모두 최종 판단은 해석자가 내리되, 판단에 필요한 정보를 에이전트가 시각화하여 제시하는 협업방식으로 수행된다.
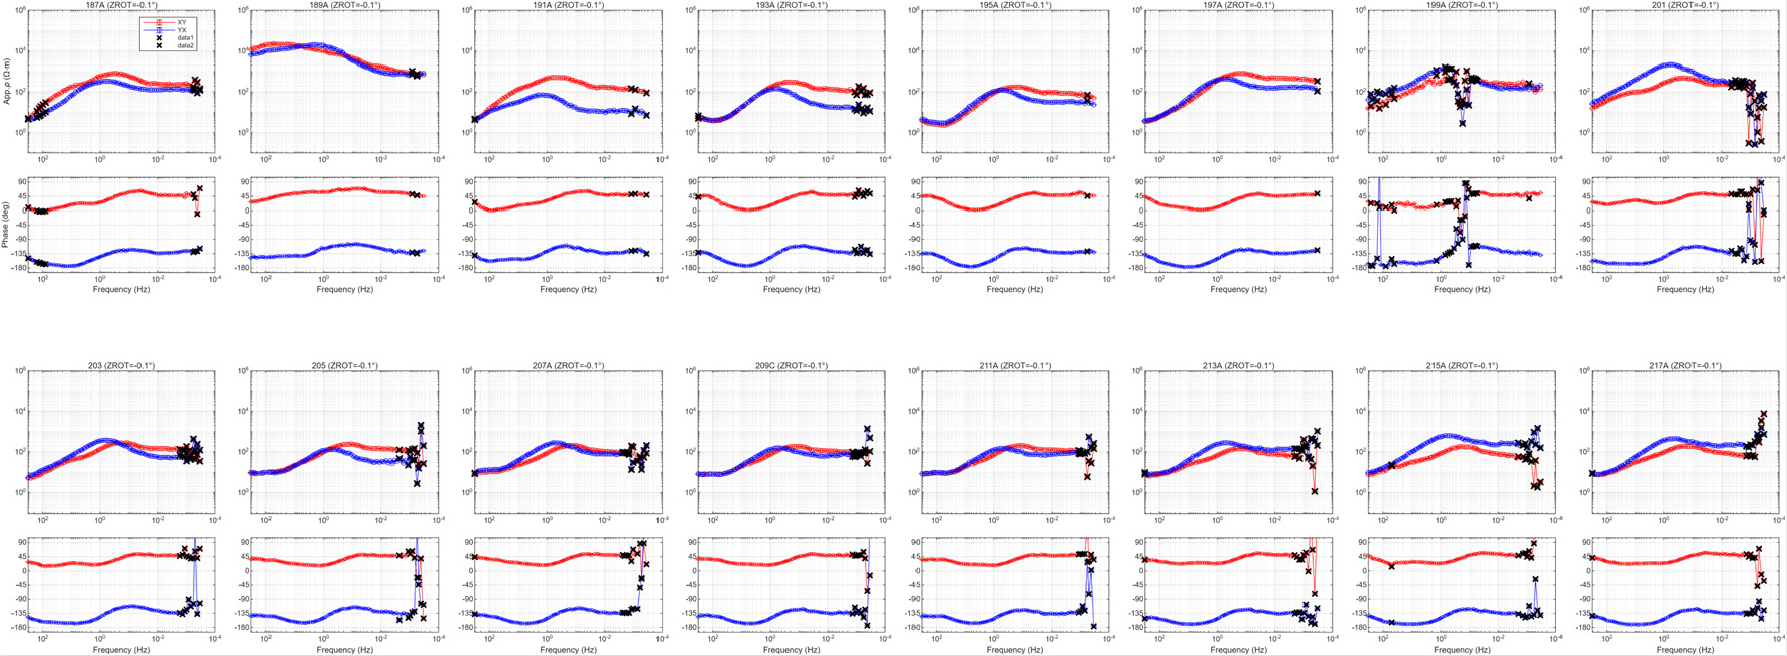
품질 관리 단계에서는 각 측점의 겉보기비저항 및 위상 주파수영역 수직탐사 곡선(sounding curve)에 대해 국소 선형회귀로 부드러운 추세선을 구하고, 개별 관측값이 이 추세선으로부터 벗어난 정도를 측점 전체의 전형적인 잡음 수준과 비교하여 이상치 여부를 판별한다. 위상이 2차원 전자기장의 물리적 정상 범위를 벗어나거나 관측 오차 한계를 초과하는 이상 자료점 역시 검토 대상에 자동으로 포함된다. 다만 이러한 자동 선별 알고리즘은 이상치 후보군을 시각적으로 표출하는 단계에 국한되며, 관측 자료의 실제 제거 여부를 시스템이 자의적으로 확정하지 않는다. 자동 판별 결과는 수직탐사 곡선에 표기되어 해석자가 직관적으로 검토할 수 있으며(Fig. 5), 자동 필터링이 누락했거나 과도하게 지정한 경계 영역의 자료점은 GUI 상에서 마우스 클릭을 통해 손쉽게 복원하거나 제외할 수 있다. 이러한 설계는 자동화 도구가 연구자의 전문적 판단을 대체하는 것이 아니라 의사결정에 필요한 객관적 근거를 제공해야 한다는 시스템 설계 철학을 구체화한 것이다.
임피던스 회전 단계에서는 취득 당시의 센서 측정 좌표계를 반영하고 있는 원시 임피던스 텐서를 측선 방위각 및 이에 직교하는 지질 주향 방향으로 좌표 변환한다. 이를 통해 2차원 수치 해석에 필수적인 분리 모드 성분을 정확히 도출한다. 회전 이후에는 xy, yx 모드를 2차원 TE와 TM모드로 대응시키며(전기장이 주향에 평행한 성분이 TE, 자기장이 주향에 평행한 성분이 TM) 연구자의 물리적 가설이나 측선 설정 목적에 따라 TE와 TM 모드 할당을 상호 전환할 수 있는 선택권을 제공한다.
본 시스템은 특정 방위각으로 회전했을 때의 물리량 변화를 수직탐사 곡선 상에서 사전에 검토할 수 있는 실시간 미리보기 기능을 지원한다. 이를 통해 해석자는 회전 후 위상이 2차원 수치 경계 조건의 물리적 타당 범위(통상 xy 성분은 0°~90°, yx 성분은 –180°~–90°) 내에 안정적으로 분포하는지를 사전에 면밀히 검증할 수 있다(예시 4-2). 품질 관리와 마찬가지로 임피던스 회전 및 모드 분리 작업 역시 대화형 에이전트 지시와 직관적인 GUI 조작 양방향을 통해 상호 동등하게 수행된다.
역산 블록모델 설계 및 미리보기
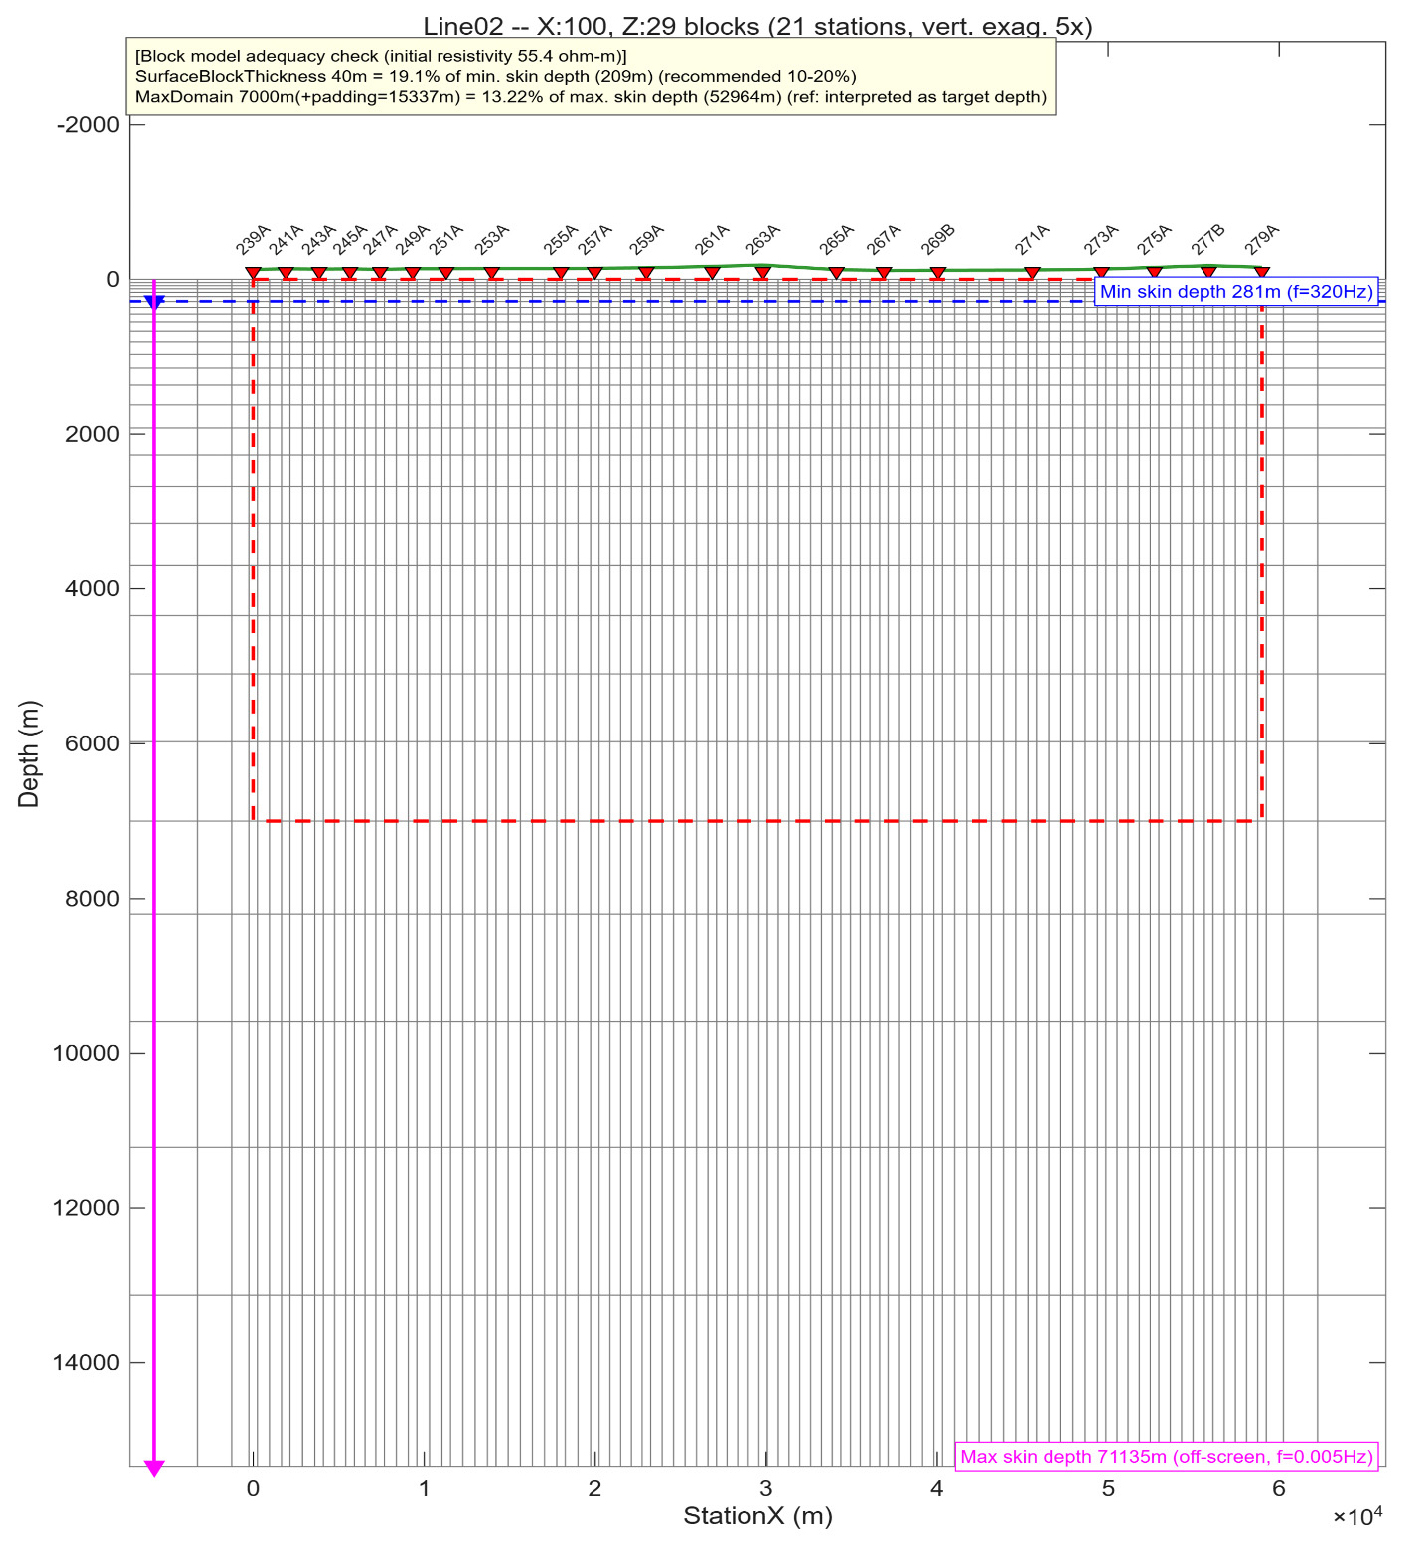
2차원 MT 역산을 안정적으로 수행하기 위해서는 측선을 따라 지하 해석 영역을 유한한 개수의 매개변수 블록으로 분할한 역산 블록 모델을 구축해야 한다. 각 블록의 크기와 개수는 관측 주파수 대역별 표피심도와 설정된 목표 해석 심도(MaxDomain)를 기반으로 1차 자동 설계된다. 이때 유한요소 격자를 통한 모델 반응 계산 시 측점 위치에 따른 특이점 왜곡을 최소화하기 위해 개별 측점이 블록의 중심선 부근에 위치하도록 분할하는 규칙(BlockDivMethod = 2)을 적용하며, 분해능이 요구되는 천부에서는 역산 블록을 조밀하게 구성하고 심부 및 모델 외곽으로 갈수록 기하급수적으로 확장하는 완충 설계 원칙을 동시에 반영한다.
그러나 이렇게 자동 설계된 블록모델이 항상 해당 측선과 목표 해석심도에 최적이라고 할 수는 없으므로, 실제 역산을 실행하기 전에 블록 경계를 시각적으로 확인하고 필요시 파라미터를 조정할 수 있는 절차가 필요하다. 이를 위해 실제 역산 엔진이 블록 좌표를 계산할 때 사용하는 함수를 그대로 재사용하여 블록 경계만을 미리 계산·시각화하는 기능을 제공하며, 이를 통해 미리보기로 확인한 블록모델이 실제 역산에 사용될 블록모델과 정확히 일치함이 보장된다(예시 4-3, Fig. 6). 해석자는 미리보기 결과를 보고 표층 블록 두께, 블록 개수, 최대 블록폭 등을 조정하며, 만족스러운 블록모델을 얻을 때까지 확인·조정 과정을 반복한 뒤 실제 역산을 실행한다. 이 작업 역시 GUI의 해당 입력창을 직접 조작하거나 자연어로 지시하는 두 방식 모두로 동등하게 수행할 수 있다.
파라미터 체계적 설정 및 역산 수행
측선 정의, 자료 QC, 임피던스 텐서 회전, 역산 블록모델 설계가 모두 완료되면, 수치 역산 단계는 해석자가 사전에 규정한 매개변수 명세에 따라 에이전트가 자율적으로 일괄 실행하는 방식으로 전개된다. 해석자가 역산 모드(TM, TE, 또는 Joint), 지표 정적효과(static shift) 보정 여부, 라그랑지안 평활화 계수 및 활성 제약 균형화(ACB) 등의 제어 매개변수를 지정하면, 에이전트는 이를 반영하여 표준 파라미터 제어 파일을 조립하고 지정된 반복(iteration) 횟수까지 계산 엔진을 자동으로 구동한다(예시 4-4).
모든 역산에서의 파라미터 구성이 항상 수렴을 보장하지는 않는다. Line01의 초기 실행(정적효과 TM·TE 모두 포함)은 iter6까지 안정적으로 수렴하였으나(DMisfit 0.34) 이후 재발산하였으며, 중간저장지점에서 평활화 계수 범위를 조정하여 재개하였음에도 오차가 오히려 증가하였다(iter10, DMisfit 1.09). 이는 단순한 계수 조정만으로는 해결되지 않는 경우가 있음을 보여주며, 이러한 경우 해석자는 파라미터 값의 미세 조정을 넘어 정적효과 처리 방식이나 지형 반영 여부와 같은 조합 자체를 재구성하는 판단을 내려야 한다. Line01의 경우 정적효과를 TE 모드로 한정하고 지형을 반영하는 조합으로 재구성한 결과 안정적인 수렴(DMisfit 0.265)을 얻었다. 이처럼 발산이 확인된 이후의 재구성 방향을 결정하는 것은 해석자의 판단 영역으로 남아 있으며, 에이전트는 각 시도의 신속한 실행과 결과 비교를 통해 이 판단 과정을 뒷받침한다. 이상의 과정을 거쳐 확정된 각 측선별 최적 조합에 따른 최종 역산 결과를 Table 2에 정리하였다.
Table 2.
Summary of final inversion results for the three survey lines
| Line | Static shift correction | Topography | Iterations | Final DMisfit |
| Line01 | TE only | Included | 11 | 0.265 |
| Line02 | Both TM and TE | Not included | 16 | 0.167 |
| Line03 | TE only | Not included | 10 | 0.27–0.28 (stagnant) |
정적효과나 역산 모드의 최적 조합은 지역·측선마다 상이하여 사전에 일반화하기 어려우며, 통상적으로 해석자는 여러 조합을 순차적으로 시도하며 결과를 비교하는 탐색적 과정을 거치게 된다. 이러한 반복적 탐색 자체는 별도의 전용 배치(batch) 스크립트 없이도, 에이전트가 조합마다 파라미터 파일을 동적으로 갱신하고 독립된 실행 폴더에서 순차 실행한 뒤 결과를 직접 취합함으로써 효율적으로 수행될 수 있다. Line02에 대해 정적효과 미포함, TE 모드만 포함, TM·TE 모두 포함의 세 조합을 실제로 순차 실행한 결과(Table 3), 최종 수렴 오차가 조합에 따라 0.31에서 0.167까지 유의미하게 달라짐을 확인하였으며, 이 세 차례의 실행과 결과 비교에 소요된 것은 해석자의 명령 세 문장으로 가능하다(예시 4-5).
Table 3.
Comparison of inversion results for Line02 under different static-shift correction schemes (joint mode, no topography)
| Case | Static shift correction | Lambda (ACB) | Iterations | Final DMisfit |
| ① | Not included | 2~10 | 11 | 0.27~0.31 |
| ② | TE only | 5~20 | 11 | 0.185 |
| ③ | Both TM and TE | 5~20 | 16 | 0.167 |
역산 결과 평가
역산이 완료되면 에이전트는 도출된 역산 모델에 대한 연구자의 종합적 사후 평가(appraisal)를 지원하기 위해 다음과 같은 4가지 표준 진단 도구를 생성·제공한다.
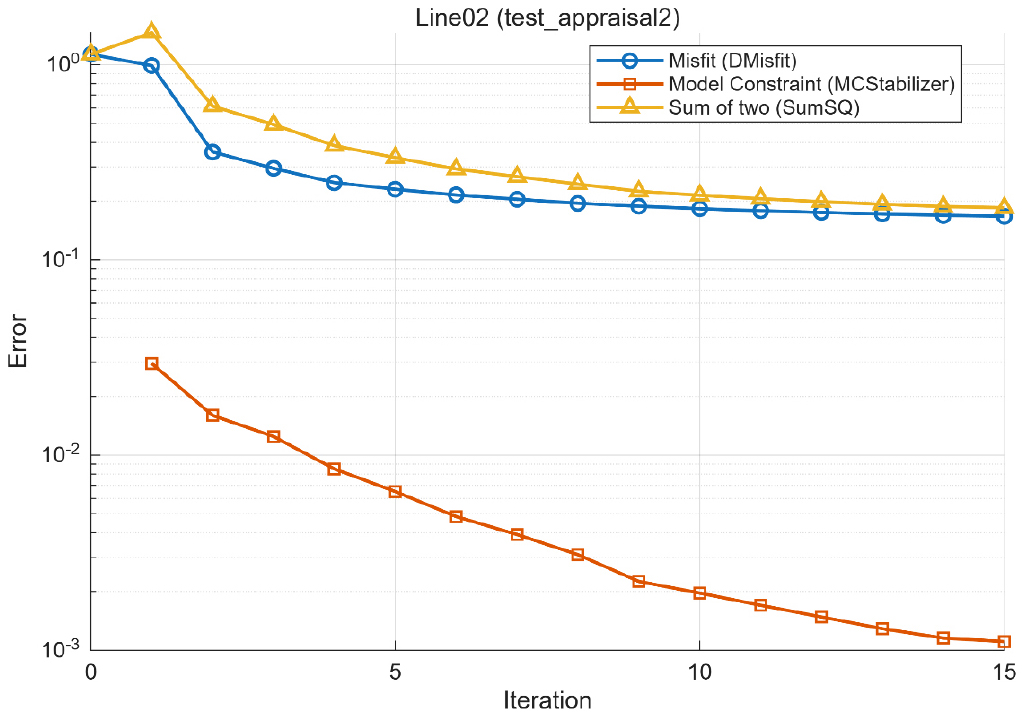
1. 역산 목적함수 수렴 곡선: 반복 횟수(iteration)별 자료 오차(data misfit)와 모델 제약 조건(model constraint) 항의 정량적 변화 추이를 추적한다(Fig. 7).
2. 전기비저항 2차원 단면도: 역산 격자 블록별로 수렴된 공간적 전기비저항 구조를 표시한다.
3. 측점별 자료 적합 곡선(fitting curve): 개별 측점 단위로 주파수에 따른 관측값과 모델 계산 반응값 간의 일치도를 상세 점검한다.
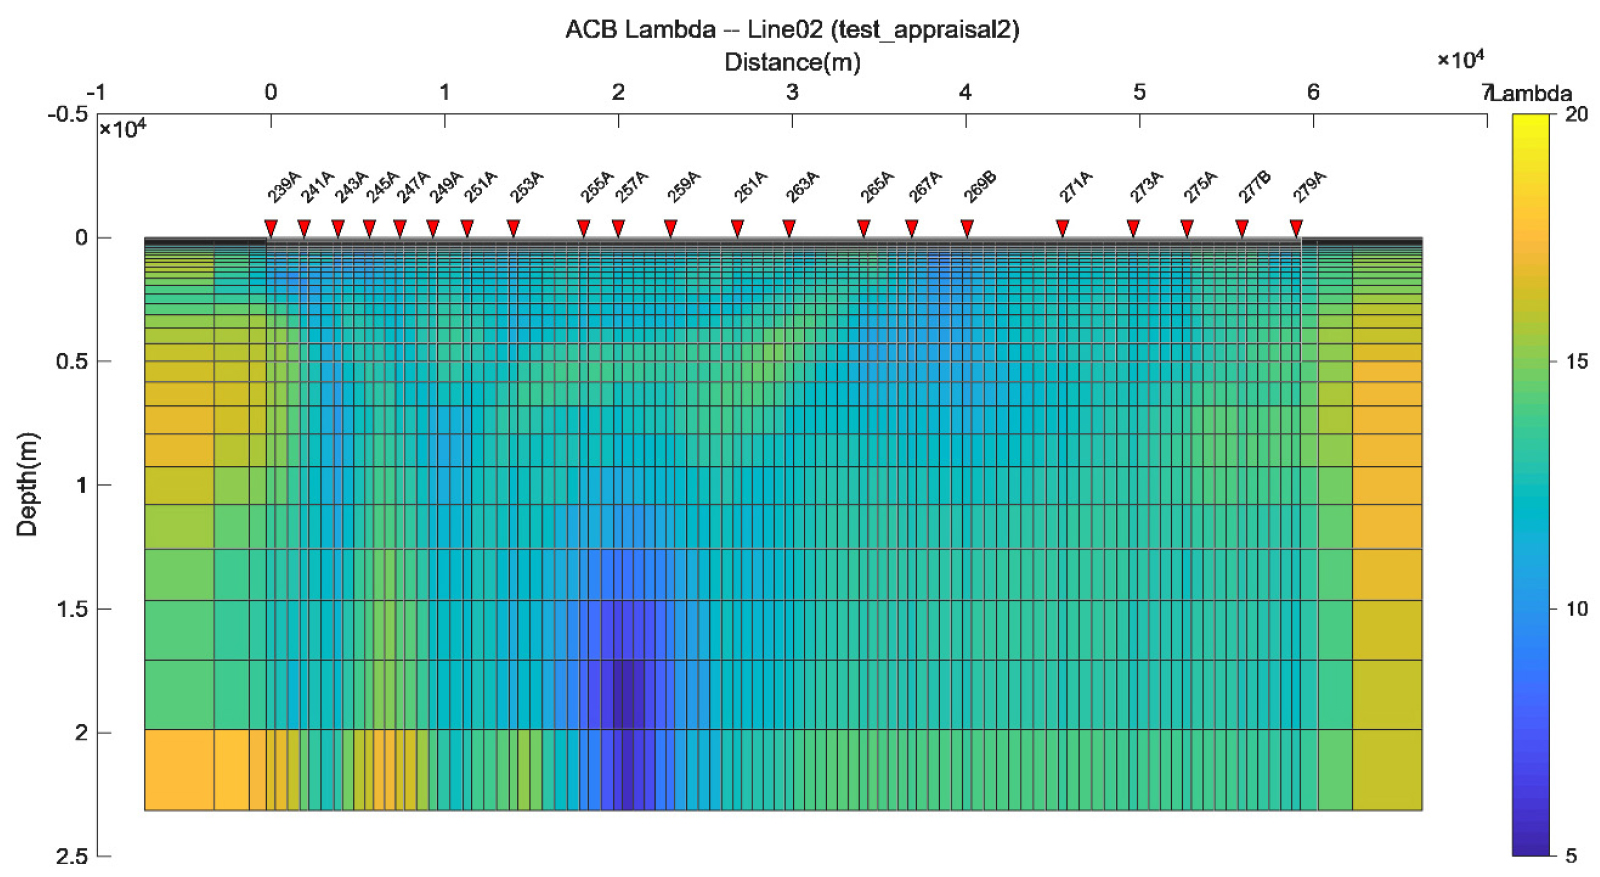
4. 공간 가변 평활화 계수 λ(ACB) 단면도: ACB법에 의하여 매개변수 분해능에 비례하여 공간적으로 적응 제어된 라그랑지안 평활화 계수 λ의 분포를 표시한다.
이 4가지 평가 도구는 전용 GUI 상의 뷰어 메뉴 조작이나 자연어 대화형 지시 모두를 통해 동일하게 실시간으로 호출할 수 있으며, 연구자는 이를 입체적으로 교차 분석하여 최종 역산 모델의 물리적 타당성과 신뢰도를 판정한다.
선행 실험에서 분석된 세 측선 중 Line02(TM/TE 모드 결합 및 정적 효과 보정 적용, 16회 반복)가 최종 자료 오차(data misfit) 0.167을 기록하며 가장 안정적인 수렴 거동을 나타내었으므로, 본 절에서는 Line02의 역산 결과를 대표 검증 사례로 선정하여 상기 4가지 도구를 통한 평가 결과를 상술한다.
먼저 목적함수 수렴 곡선(Fig. 7)을 살펴보면, 자료 오차와 모델 제약 항이 초기 반복 단계부터 급격히 감소한 후 점진적으로 안정화되며, 총 목적함수 값 역시 단조 감소(monotonic decrease)하는 전형적인 최적화 수렴 양상을 보인다. 이는 앞선 시험 역산에서 나타났던 조기 발산(iteration 7 이후 오차 급증)이나 정체(iteration 5 이후 0.27~0.28 대역에서 수렴 정체) 사례와 뚜렷하게 대비되는 안정적 수렴 패턴이다.
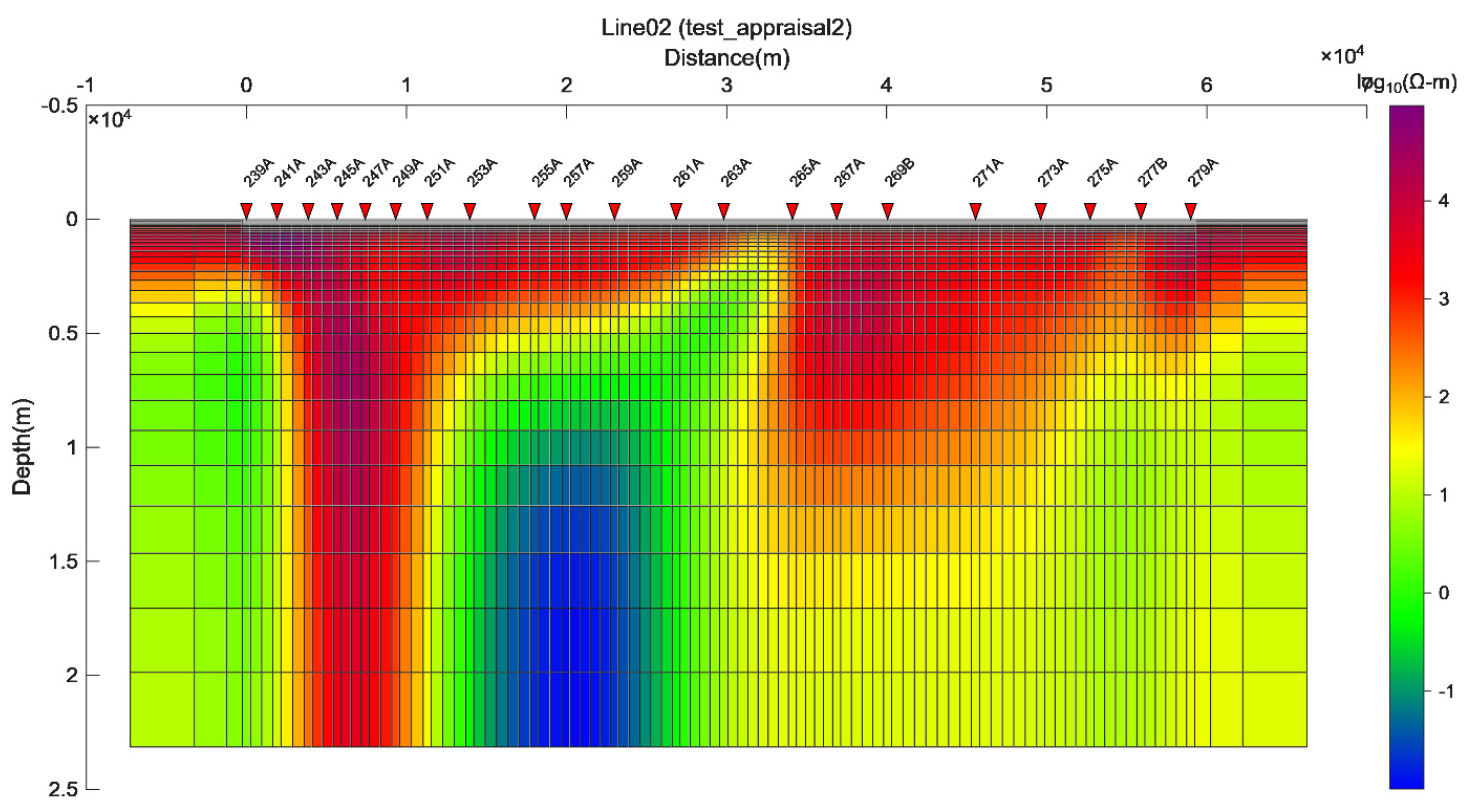
전기비저항 단면도(Fig. 8)에는 지표 측점 위치가 삼각형 기호로 도시되어 있으며, 서부(측점 239A~253A 부근)와 동부(측점 265A 이후)의 상대적 고비저항 영역과, 중앙부(측점 255A~263A)의 뚜렷한 저비저항 이상대가 선명한 공간적 대비를 이룬다. 앞서 기술한 바와 같이 본 연구의 목적은 이러한 이상대의 지질학적 기원을 재해석하는 데 있지 않으므로, 지체구조적 논의는 생략한다.
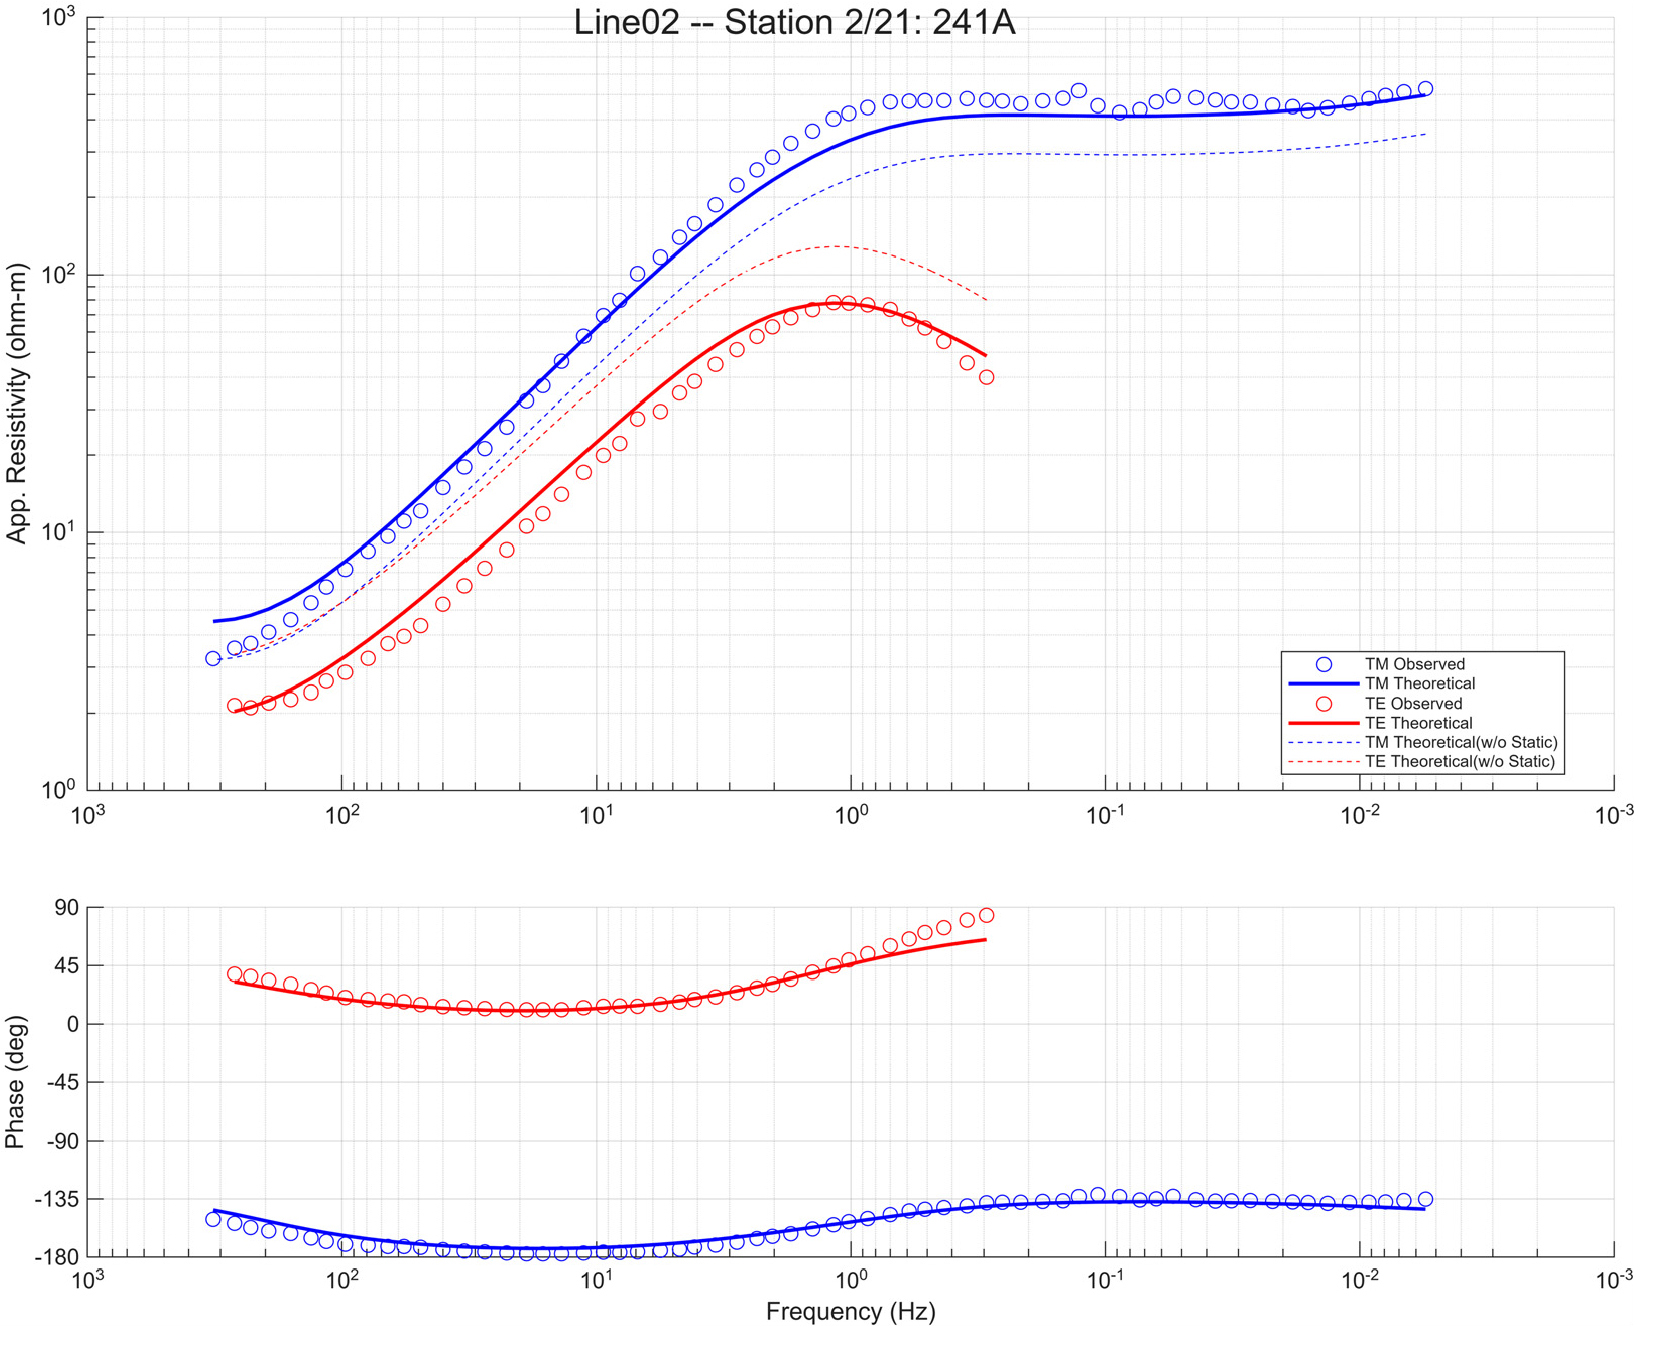
대표 측점(241A)의 자료 적합 곡선(Fig. 9)에서는 TM 및 TE 두 편파 모드 모두에서 관측값과 모델 계산 곡선이 전 주파수 대역에 걸쳐 높은 적합도를 나타낸다. 특히 정적 효과 보정 전(점선)과 보정 후(실선) 반응 곡선의 확연한 수평 편차를 통해, 천부 비균질체에 기인한 진폭 왜곡이 알고리즘에 의해 유효하게 보정되었음을 확인할 수 있다.
마지막으로 ACB 단면도(Fig. 10)는 모델 분해능 행렬의 대각합 분석에 기초하여 공간적으로 가변 할당된 평활화 계수(λ=5∼20)의 분포를 보여준다. 분해능 정보가 상대적으로 희소한 천부 측점 간 간극 및 심부 배경 영역에는 상대적으로 큰 λ 값이 적용되어 과도한 모델 진동을 억제하는 강한 평활화가 부여된 반면, 관측 감도가 집중되는 서부 고비저항 이상대 상단(측점 243A 부근)과 중앙 저비저항대 주변부에서는 작은 λ 값이 적용되어 공간적 분해능을 효과적으로 보존하였음을 확인할 수 있다.
이와 같이 제안된 AI 에이전트 시스템은 전체 역산 실행 파이프라인의 자율적 제어 뿐만 아니라, 연구자가 역산의 수치적 안정성과 물리적 신뢰성을 정밀하게 교차 검증하는 데 필수적인 다차원 진단 도구를 지연 없이 능동적으로 제공함으로써 고도화된 연구자-에이전트 협업 환경을 완성한다.
결 론
본 시스템은 기존 역산 엔진(MT2DInvMatlab)을 변형하지 않고 원본 그대로 유지하면서, MATLAB MCP Server와 Filesystem MCP Server를 통해 에이전트가 사람과 동일한 경로로 프로그램에 접근하도록 설계함으로써 수치 결과의 재현성을 확보하였다. 이러한 기존 코드의 수정 없이 사용하고자 하는 원칙은 향후 역산 엔진 자체의 개선이나 검증이 별도로 이루어지더라도, 에이전트 제어 계층을 다시 개발할 필요 없이 그대로 적용할 수 있다는 확장성의 근거이기도 하다. 또한 GUI와 에이전트가 하나의 영속적 MATLAB 세션을 실시간으로 공유하도록 하여, 해석자가 GUI로 직접 조작한 결과를 에이전트가 즉시 인지하고 반대로 에이전트의 처리 결과가 화면에 동기화되는 협업 구조(“AI–Human–Inversion Loop”)를 구현하였다. 이를 통해 MT 탐사에서의 가상 측선 설정, 자료 품질관리, 임피던스 회전, 역산 블록모델 설계와 같이 해석자의 전문적 판단이 요구되는 단계는 대화형으로, 파라미터가 확정된 이후의 반복적인 역산 실행과 결과 취합은 명세 기반으로 자동화하는 역할 분담을 실현하였다.
호주 Victoria 현장자료를 이용한 검증에서는, 기존 논문이 전체 측점을 단일 대표방향으로 근사하여 하나의 측선으로 처리하였던 것과 달리, 본 연구에서는 측점 분포를 여러 구간으로 나누어 구간별로 다른 방향의 측선을 구성함으로써 원논문의 근사가 내포할 수 있는 오차를 줄일 수 있는 가능성을 보였다. 3개 측선에 대한 역산 결과, 최종 자료오차는 0.167(Line02)에서 0.27~0.28(Line03) 사이의 분포를 보였으며, 정적효과 처리 방식이나 지형 반영 여부와 같은 최적 파라미터 조합은 측선마다 상이하여 일반화하기 어렵다는 점을 확인하였다. 실제로 Line01의 초기 실행은 안정적으로 수렴하다가 재발산하였으나, 단순한 계수 조정만으로는 해결되지 않았고 정적효과 처리 방식 자체를 재구성함으로써 비로소 안정적인 수렴을 얻을 수 있었다. 이는 역산 파라미터의 최적화가 순차적 시행착오를 요구하는 전문가적인 탐색적 과정임을 실증하는 사례로, 이러한 탐색적 재구성 과정에서 에이전트는 별도의 배치 자동화 도구 없이도 여러 파라미터 조합에 대한 반복 실행과 결과 취합을 신속하게 수행함으로써, 해석자가 매개변수 조정이라는 반복적인 지루한 작업 대신 최종 모델의 지구물리학적 판단과 평가에 집중할 수 있도록 하였다. 향후에는 3차원 역산 및 다른 물리탐사 기법으로 워크플로우를 확장하는 연구를 진행할 계획이다.