

서 론
연구방법
기반 데이터 및 객체 탐지 모델
정책 기반 AI 점검 에이전트 시스템 구성
예측 오류 위험 기반 클래스별 선택적 분기
VLM 기반 선택적 이차 시각 검증 및 최종 판단
평가 방법 및 비교 전략
독립 촬영 세션 데이터에 대한 분기 정책 평가
연구결과
추가 검증 대상 분기 전략 비교
VLM 기반 선택적 검증 및 최종 판단 결과
AI 점검 에이전트 시스템 구현 결과
독립 촬영 세션 데이터에 대한 평가 결과
토 의
선택적 분기에 따른 검증 부담과 오류 포착 성능의 상충관계
VLM 기반 선택적 검증의 역할과 한계
전문가 검토 연계형 점검 시스템으로서의 의미
연구의 한계 및 향후 연구
결 론
서 론
최근 무인항공기(Unmanned Aerial Vehicle, UAV)와 인공지능(Artificial Intelligence, AI)을 이용한 외관검사는 영상에서 구조물과 설비의 상태를 자동으로 탐지하고, 그 결과를 유지관리와 후속 점검에 활용하는 방향으로 발전하고 있다(Araya-Santelices et al., 2025; Tan et al., 2022). 특히 광산을 포함한 자원개발 현장에서는 작업자의 접근이 어렵거나 위험한 구역의 모니터링과 안전점검에 UAV가 활용되고 있으며, 이를 통해 작업자의 위험 노출을 줄이고 점검의 안전성과 효율성을 높일 수 있다(Dang and Nguyen, 2023; Nordström et al., 2025).
그러나 딥러닝 기반 객체 탐지는 제한적이고 불균형한 데이터, 작은 결함 영역, 복잡한 배경 및 촬영 환경의 변화 등으로 인해 실제 환경에서 일관된 성능을 확보하는 데 어려움이 있다(Shi et al., 2023; Li et al., 2021; Li et al., 2023; Zha et al., 2025; Panizza et al., 2020). 또한 객체 탐지 모델의 신뢰도(confidence)는 실제 예측 정확성과 항상 일치하지 않으며, 높은 신뢰도에서도 오예측이 발생할 수 있다(Pathiraja et al., 2023). 따라서 객체 탐지 결과를 모두 자동 수용할 경우 오예측이 최종 점검 판단에 포함될 수 있다. 반대로 모든 탐지 결과에 동일하게 추가 검증을 적용하면 비전-언어 모델(vision-language model, VLM) 기반 검증량과 전문가 검토 부담이 과도하게 증가할 수 있다. 이러한 이유로 자동화된 점검에서는 탐지 결과의 예측 특성을 고려하여 자동 수용 가능한 결과와 추가 검증이 필요한 결과를 선택적으로 구분하는 과정이 필요하다.
이와 관련하여 불확실한 예측을 추가적인 시각 정보로 재검증하거나, 필요한 경우에만 멀티모달 모델과 후속 도구를 활용하는 선택적 검증 연구가 제시되고 있다. Srinivasan et al.(2024)은 추가 시각 정보를 이용하여 VLM의 불확실한 예측을 재검증하였으며, Mokhtar et al.(2025)은 산업 이상 탐지 과정에서 멀티모달 언어 모델을 이용한 후속 분석을 수행하였다. 최근에는 기존 객체 탐지 모델의 출력을 VLM이 의미론적으로 평가하는 후속 품질관리 접근도 제시되고 있다(Abdelkader, 2026). 또한 Miao et al.(2025)은 분석 상태에 따라 후속 도구와 절차를 선택하는 에이전트 기반 접근을 제시하였다. 그러나 UAV 기반 산업 점검에서 객체 탐지기의 클래스별 오예측 특성과 높은 신뢰도에서 발생하는 오류를 함께 고려하여 추가 검증 대상을 선택하고, 그에 따른 검증 부담과 오류 포착 성능의 변화를 정량적으로 평가한 연구는 충분하지 않다.
이에 본 연구에서는 선행연구에서 개발한 UAV 기반 타워크레인 객체 탐지 모델(Yang et al., 2026)의 탐지 결과를 대상으로, 예측 오류 위험에 따라 후속 검증 자원을 선택적으로 배분하는 정책 기반 AI 점검 에이전트 시스템을 개발하였다. 검증 데이터에서 관찰된 구성요소 상태 클래스별 신뢰도와 오예측 특성을 이용하여 수용 임계값을 설정하고, 이를 기반으로 탐지 결과를 초기 자동 수용 또는 VLM 기반 추가 검증 대상으로 분기하는 예측 오류 위험 기반 분기(prediction-error-risk-aware routing; 이하 Risk-Aware Routing)를 구성하였다. 여기서 Risk-Aware Routing은 물리적 위험도를 추정하는 별도의 위험모델이 아니라, 클래스별로 관찰된 예측 오류 특성을 이용하여 후속 검증 자원을 선택적으로 배분하는 경험적 의사결정 정책으로 사용하였다. 추가 검증 대상으로 선정된 결과에 대해서만 VLM 기반 이차 시각 검증을 수행하고, 그 결과에 따라 자동 판단 또는 전문가 검토로 처리하였다.
제안한 시스템은 첫째, 클래스별 선택적 분기를 통해 추가 검증 대상을 얼마나 줄일 수 있는지, 둘째, 검증 대상 감소에 따라 자동 수용 오류와 탐지 오예측 포착 성능이 어떻게 변화하는지, 셋째, 선택적 VLM 검증을 통해 전문가 검토 대상을 추가로 줄일 수 있는지와 최종 자동 판단의 오류 특성이 어떻게 변화하는지를 평가하였다. 또한 수용 임계값의 민감도를 분석하고, 동일한 검증량 조건에서 전역 임계값 방식과 클래스별 분기 방식을 비교하였으며, 모든 탐지 결과에 VLM을 적용하는 Full-VLM 전략과의 비교를 통해 선택적 검증의 역할을 평가하였다. 아울러 기존 임계값을 재조정하지 않은 상태에서 독립된 촬영 세션 자료에 분기 정책을 적용하여 새로운 촬영 조건에서의 선택 특성을 추가로 확인하였다. 이를 통해 UAV 기반 점검에서 검증 부담, 자동화 수준 및 오류 포착 성능 사이의 상충관계를 정량적으로 분석하고, 객체 탐지 이후의 선택적 검증과 전문가 검토를 연계하는 의사결정 구조를 제시하였다. 본 연구의 기여는 특정 클래스별 임계값 자체를 일반적인 기준으로 제안하는 데 있기보다, 클래스별 선택적 분기, VLM 기반 이차 검증 및 전문가 검토를 하나의 의사결정 경로로 연계하고, 다양한 검증 조건에서 검증 부담과 오류 포착 성능의 상충관계를 실증적으로 평가한 데 있다.
연구방법
기반 데이터 및 객체 탐지 모델
본 연구에서는 Yang et al.(2026)의 선행연구에서 구축한 UAV 기반 타워크레인 영상 데이터와 YOLO11l 기반 객체 탐지 모델을 활용하였다. 해당 데이터는 타워크레인의 마스트 체결부, 턴테이블 모터부 및 메인붐 스토퍼 패킹에서 관찰되는 정상 및 결함 상태를 포함하며, 객체 탐지 모델은 총 7개의 구성요소 상태 클래스(component-condition class)를 대상으로 학습되었다. 본 연구에서는 선행연구에서 학습된 객체 탐지 모델의 가중치를 그대로 사용하였으며, 추가적인 학습이나 미세조정(fine-tuning)은 수행하지 않았다. 선행연구에서는 원본 데이터셋을 구성요소 상태 클래스별 표본 수가 각 데이터셋에서 가능한 한 균형을 이루도록 학습, 검증 및 시험 데이터로 분할하였다. 본 연구에서는 이 분할을 그대로 사용하였으며, 검증 데이터는 클래스별 수용 임계값을 설정하기 위한 자료로 사용하고, 시험 데이터는 임계값 설정에는 사용하지 않은 채 고정된 분기 정책과 후속 의사결정 절차의 성능을 평가하는 데 사용하였다.
최종 성능평가를 위한 시험 데이터에 대해서는 신뢰도 하한값(confidence cutoff) 0.25를 적용하여 객체 탐지를 수행하였다. 각 탐지 결과에서 예측 클래스, 경계상자(bounding box) 및 신뢰도(confidence score)를 추출하였으며, 이를 후속 의사결정을 수행하는 AI 점검 에이전트의 입력 정보로 사용하였다. UAV 영상 데이터의 획득 환경, 학습 데이터 구성, 객체 탐지 모델의 학습 및 기본 성능평가 방법에 관한 상세 내용은 Yang et al.(2026)에 제시되어 있다.
선행연구의 학습, 검증 및 시험 데이터는 촬영 세션 단위가 아니라 구성요소 상태 클래스별 표본 수의 균형을 고려한 영상 단위로 분할되었다. 따라서 동일한 타워크레인을 동일 촬영일에 획득한 영상이 서로 다른 데이터셋에 포함되어 있으며, 사후 데이터 점검 과정에서 학습–검증 간 1쌍과 학습–시험 간 3쌍의 동일 영상이 중복 포함된 사실을 확인하였다. 해당 중복 영상은 선행연구의 실제 모델 학습 및 평가 당시에도 각 데이터셋에 포함되어 있었음을 확인하였다. 이러한 이유로 본 연구의 내부 시험 데이터는 완전히 독립된 촬영 조건에 대한 외부 일반화 성능을 평가하는 자료로 해석하지 않았으며, 고정된 분기 정책의 새로운 촬영 조건에 대한 적용 특성을 추가로 확인하기 위해 별도의 촬영 세션에서 획득한 2026년 데이터를 사용하였다.
정책 기반 AI 점검 에이전트 시스템 구성
본 연구에서 개발한 정책 기반 AI 점검 에이전트 시스템은 UAV 영상 입력, YOLO 기반 구성요소 상태 탐지, 예측 오류 위험 기반 선택적 분기, VLM 기반 선택적 이차 시각 검증 및 최종 점검 판단 단계로 구성하였다(Fig. 1). 본 연구에서 정책 기반 AI 점검 에이전트는 객체 탐지 결과의 예측 클래스와 신뢰도를 상태 정보로 해석하고, 사전에 정의된 의사결정 정책에 따라 후속 처리 경로와 추가 도구의 사용 여부를 선택하는 의사결정 계층으로 정의하였다.
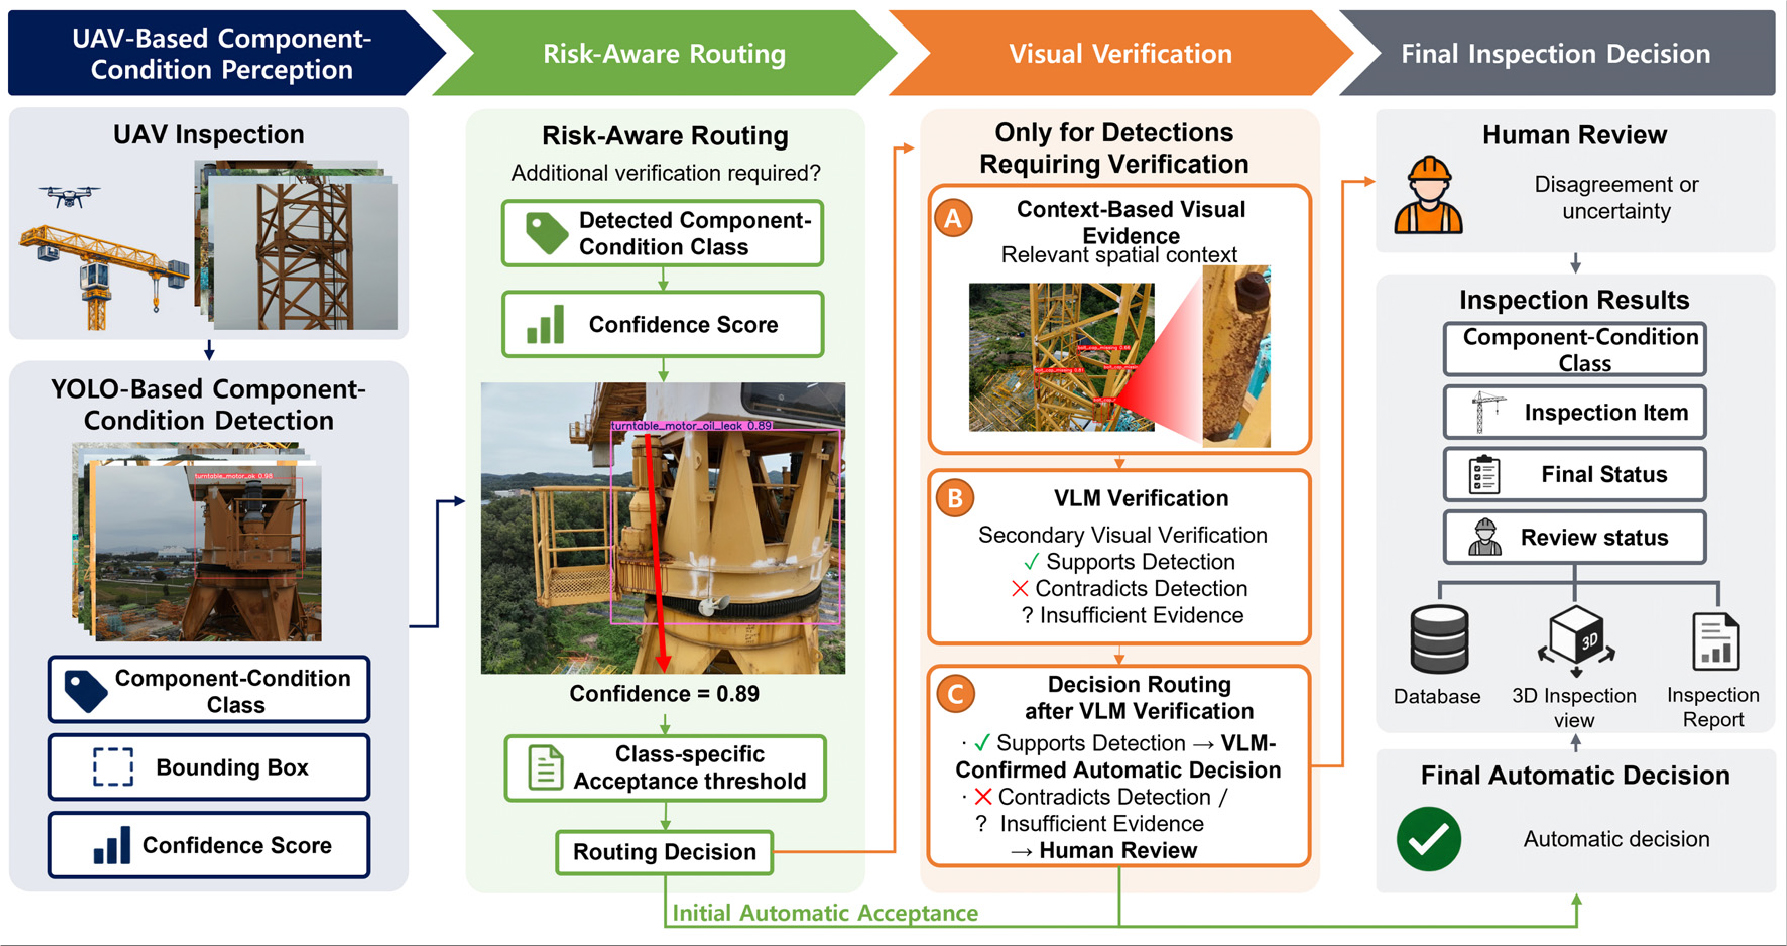
먼저 UAV 영상으로부터 구성요소 상태 클래스, 경계상자 및 신뢰도를 추출한 후, 에이전트는 클래스별 수용 임계값을 기준으로 각 탐지 결과를 초기 자동 수용(Initial Automatic Acceptance)하거나 VLM 기반 추가 검증 대상으로 분기한다. 추가 검증 대상으로 선정된 탐지에 대해서만 VLM 기반 이차 시각 검증을 수행한다. VLM이 기존 탐지 결과를 지지하는 경우에는 VLM 확인 자동 판단(VLM-Confirmed Automatic Decision)으로 처리하고, 탐지 결과와 상충하거나 충분한 시각적 근거를 확보하지 못한 경우에는 전문가 검토(Human Review)로 이관한다. 초기 자동 수용 결과와 VLM 확인 자동 판단 결과를 합한 결과를 최종 자동 판단(Final Automatic Decision)으로 정의하였다.
각 탐지 결과의 구성요소 상태 클래스, 신뢰도, 선택적 분기 결과, VLM 검증 결과 및 최종 처리 상태는 데이터베이스에 기록하도록 구성하였다. 또한 최종 결과를 점검 항목 및 전문가 검토 정보와 연계하여 점검 시스템과 보고서에서 활용할 수 있도록 하였다.
예측 오류 위험 기반 클래스별 선택적 분기
본 연구에서는 객체 탐지 결과의 예측 클래스와 신뢰도를 이용하여 추가 검증 필요 여부를 결정하였다. 타워크레인의 구성요소 상태 클래스별로 데이터 특성, 탐지 난이도 및 오예측의 신뢰도 분포가 서로 다를 수 있으므로, 모든 클래스에 동일한 수용 기준을 적용하는 대신 검증 데이터에서 관찰된 클래스별 예측 특성을 이용하여 클래스별 수용 임계값을 설정하였다.
본 연구에서는 이러한 분기 방식을 Risk-Aware Routing으로 정의하였다. 여기서 risk는 타워크레인 결함의 물리적 위험도나 안전사고의 발생 가능성을 의미하지 않으며, 객체 탐지 결과가 오예측일 가능성과 관련된 예측 오류 위험을 의미한다. 본 연구에서는 별도의 확률적 위험 예측 모델을 구축하지 않고, 검증 데이터에서 관찰된 클래스별 신뢰도와 오예측 특성을 반영한 수용 임계값을 이용하여 예측 오류 위험을 간접적으로 관리하였다. 따라서 본 연구의 Risk-Aware Routing은 새로운 확률적 위험모델이 아니라, 클래스별로 관찰된 예측 오류 특성을 이용하여 후속 검증 자원을 선택적으로 배분하는 경험적 의사결정 정책으로 정의하였다.
클래스별 수용 임계값 설정에는 49장의 검증 영상에서 YOLO가 생성한 총 155건의 탐지 결과를 사용하였다. 클래스별 수용 임계값을 결정하기 위한 후보값은 신뢰도 0.25 이상인 검증 데이터의 실제 탐지 결과에서 관찰된 신뢰도 값과 사전에 설정한 0.50, 0.55, 0.60, 0.65, 0.70, 0.75, 0.80, 0.85, 0.90, 0.91, 0.92, 0.95, 0.97 및 0.99로 구성하였다. 탐지 결과 의 신뢰도를 , 해당 탐지 결과의 구성요소 상태 클래스를 , 클래스 에 대해 설정된 수용 임계값을 라고 할 때, 탐지 결과의 후속 처리 경로 는 다음과 같이 결정하였다.
즉, 탐지 신뢰도가 해당 클래스의 수용 임계값 이상이면 추가 검증 없이 초기 자동 수용하고, 임계값보다 낮으면 VLM 기반 추가 검증 대상으로 분류하였다.
클래스별 임계값은 검증 데이터에서 초기 자동 수용되는 탐지 결과에 오예측이 포함되지 않는 조건을 우선적으로 만족하도록 설정하였다. 또한 지나치게 적은 표본만을 근거로 수용 임계값이 결정되는 것을 방지하기 위해 최소 자동 수용 표본수를 5건으로 설정하고, 초기 자동 수용 건수가 1–4건인 후보는 제외하였다. 이 최소 표본수 조건은 통계적으로 보장된 안전 기준을 의미하는 것이 아니라, 극소수의 자동 수용 사례만으로 임계값이 결정되는 것을 방지하기 위한 최소 지지 표본 조건(minimum-support condition)으로 설정하였다. 허용된 후보 중 검증 데이터에서 오예측을 자동 수용하지 않으면서 전체 초기 자동 수용 건수를 최대화하는 임계값을 선택하였다. 즉, 각 클래스에서는 오예측 없는 자동 수용 조건을 만족하는 후보 중 자동 수용 범위가 가장 넓은 임계값을 선택하였다. 해당 조건을 만족하면서 자동 수용할 수 있는 탐지가 없는 경우에는 해당 클래스의 모든 탐지를 추가 검증 대상으로 처리하도록 하였다.
클래스별 검증 탐지 수, 검증 데이터에서 관찰된 오예측 중 최대 신뢰도 및 최종 수용 임계값은 Table 1에 제시하였다. 이후 시험 데이터 평가에서는 Table 1의 임계값을 변경하지 않고 적용하였다.
Table 1.
Class-specific validation statistics and acceptance thresholds used for Risk-Aware Routing
비교를 위한 전역 임계값 분기(Global Threshold Routing)에서는 클래스별로 임계값을 따로 설정하지 않고, 7개 클래스의 검증 탐지 결과를 하나의 집합으로 통합하였다. 즉, 앞서 설명한 것과 동일한 후보 임계값과 선정 기준을 적용하여, 자동 수용 결과에 오예측이 포함되지 않으면서 최소 5건 이상을 자동 수용하고, 그중 자동 수용 건수가 가장 많은 하나의 공통 임계값을 선정하였다. 한편 최소 자동 수용 표본수와 검증 데이터 구성에 따른 임계값의 민감도를 확인하기 위해, 최소 지지 표본수를 3, 5 및 10건으로 변화시킨 분석을 수행하였다. 또한 한정된 검증 데이터에서 표본 구성 변화에 따른 임계값의 민감도를 확인하기 위해, 검증 영상을 영상 단위로 복원추출하여 원래 검증 영상 수와 동일한 크기의 재구성 자료 1,000개를 생성하였다. 각 재구성 자료에 동일한 임계값 선정 절차를 적용하여 클래스별 수용 임계값의 변동성을 평가하였으며, 특정 클래스에서 유효한 자동 수용 임계값을 설정할 수 없는 경우에는 해당 클래스의 탐지를 모두 추가 검증 대상으로 처리하였다.
VLM 기반 선택적 이차 시각 검증 및 최종 판단
Risk-Aware Routing에서 추가 검증 대상으로 분류된 탐지 결과에 한하여 VLM 기반 선택적 이차 시각 검증을 수행하였다. 본 연구에서 VLM은 전체 UAV 영상에서 결함을 독립적으로 탐색하는 객체 탐지기로 사용한 것이 아니라, YOLO가 생성한 기존 탐지 결과의 시각적 타당성을 주변 맥락 정보와 함께 이차적으로 평가하는 검증 도구로 사용하였다.
각 탐지에 대한 맥락 영상(context image)은 YOLO가 생성한 경계상자의 중심을 기준으로 가로와 세로 범위를 각각 3.0배 확장한 후 원본 영상의 경계에 맞추어 잘라 생성하였다. 모든 추가 검증 대상에는 동일한 맥락 영상 생성 규칙을 적용하였다. VLM에는 각 탐지에 대해 해당 맥락 영상 1장만 입력하였으며, 원본 전체 영상이나 경계상자가 표시된 영상은 함께 제공하지 않았다.
검증 프롬프트에는 YOLO의 예측 클래스, 신뢰도 및 클래스별 시각 판별 기준을 제공하였으며, 사전에 정의된 경우에는 대응 가능한 대안 클래스도 함께 제시하였다. 클래스별 판별 기준은 볼트 캡과 스토퍼 패킹의 존재 또는 부재, 볼트 몸체의 부재, 턴테이블 모터 주변의 국소적인 유체성 흔적 존재 여부 등 입력 영상에서 직접 확인할 수 있는 시각적 상태 특성을 기준으로 설정하였다.
기본 선택적 VLM 검증은 2026년 8월 25일 Codex CLI 0.149.1 환경에서 gpt-5.6-sol을 요청 모델로 지정하여 수행하였다. 이후 추가한 경계상자 표시 재검증, 예측 클래스 변경 분석 및 Full-VLM 비교를 위한 추가 추론은 2026년 9월 15일 Codex CLI 0.152.1 환경에서 동일한 요청 모델을 사용하여 수행하였다. 각 탐지 결과에 대해서는 1회의 추론만 수행하였으며 반복 추론이나 다수결 방식은 적용하지 않았다. 또한 사용자가 별도로 지정하는 temperature, top-p 및 random seed 설정은 적용하지 않았다. 동일한 검증 프롬프트와 맥락 영상 생성 규칙을 모든 검증 대상에 일관되게 적용하였다.
VLM의 출력 상태는 Supports Detection, Contradicts Detection 및 Insufficient Evidence의 세 가지로 제한하였다. Supports Detection은 입력된 시각적 근거가 YOLO의 탐지 결과를 지지하는 경우로 정의하고 VLM 확인 자동 판단으로 처리하였다. Contradicts Detection은 시각적 근거가 YOLO의 탐지 결과와 상충하는 경우로 정의하고 전문가 검토로 이관하였다. Insufficient Evidence는 제공된 영상만으로 YOLO의 탐지 결과를 충분히 확인하기 어려운 판단 보류(abstention) 상태로 정의하고 전문가 검토로 이관하였다. 따라서 VLM이 충분한 근거를 확보하지 못한 경우에는 강제적인 자동 판단을 수행하지 않도록 하였다.
VLM의 판단 보류 원인과 객체 탐지 정보의 영향을 추가로 확인하기 위해 두 가지 보조 분석을 수행하였다. 첫째, 기존 검증에서 Insufficient Evidence로 분류된 사례에 대해 동일한 3배 맥락 영상의 내용과 범위를 유지하면서 검증 대상 경계상자만 표시하여 재검증하였다. 경계상자 표시 영상은 기존 맥락 영상에 검증 대상의 위치를 시각적으로 표시하는 방식으로 생성하였다. 둘째, VLM 판단의 예측 클래스 정보에 대한 민감도를 평가하기 위해 영상, 맥락 영역 및 신뢰도는 유지한 상태에서 의미적으로 대응되는 정상·결함 상태 클래스 쌍의 예측 클래스만 변경하는 예측 클래스 변경 분석을 수행하였다. 전체 75건의 추가 검증 대상 중 의미적으로 대응되는 정상–결함 상태 클래스 쌍을 정의할 수 있는 60건을 대상으로 분석하였으며, 대응 상태 클래스가 정의되지 않는 bolt_missing 관련 15건은 제외하였다. 두 보조 분석에서도 탐지 결과당 1회의 추론만 수행하였다.
평가 방법 및 비교 전략
최종 성능평가에는 59장의 시험 영상을 사용하였다. 객체 탐지 결과와 정답 객체 간의 대응은 탐지 신뢰도가 높은 순서대로 수행하였다. 각 탐지는 IoU(Intersection over Union)가 0.5 이상인 아직 대응되지 않은 정답 객체 중 대응 가능한 객체와 일대일로 연결하였으며, 이를 탐욕적 매칭(greedy matching) 방식으로 수행하였다. 정답 객체와 대응되지 않은 탐지는 오탐(false positive, FP)으로 분류하였고, 정답 객체와 대응되었으나 예측 클래스가 정답 클래스와 다른 경우에는 오분류(misclassification)로 분류하였다. 객체 탐지 단계에서 탐지 결과 자체가 생성되지 않은 미탐(false negative, FN)은 후속 선택적 분기나 VLM 검증의 입력이 될 수 없으므로 별도로 집계하였다.
평가는 크게 분기 전략 평가(routing strategy evaluation)와 전체 의사결정 경로 평가(end-to-end decision-routing evaluation)의 두 단계로 수행하였다.
분기 전략 평가에서는 YOLO Only, Global Threshold Routing 및 Risk-Aware Routing을 비교하였다. YOLO Only는 모든 탐지 결과를 추가 검증 없이 초기 자동 수용하는 방법으로 설정하였다. Global Threshold Routing에서는 이 155건의 검증 탐지 결과를 클래스 구분 없이 통합한 후 2.3절과 동일한 임계값 선정 원칙을 적용하여 산출한 단일 수용 임계값을 사용하였다. 검증 데이터에서 산출된 전역 수용 임계값은 0.90322였다. Risk-Aware Routing에는 Table 1의 클래스별 수용 임계값을 적용하였다.
분기 전략의 공정한 비교를 위해, Risk-Aware Routing과 동일한 수의 탐지 결과가 추가 검증 대상으로 분류되도록 전역 임계값을 조정한 비교도 추가로 수행하였다. 이 임계값은 동일한 검증량에서 두 분기 방식의 선택 특성을 비교하기 위해 사후적으로 설정하였다.
분기 전략의 성능은 추가 검증률(Verification Rate), 자동 수용 오류율(Automatic Acceptance Error Rate, AAER), 오류 포착률(Error Capture Rate, ECR) 및 VLM 검증 대상 감소율을 이용하여 평가하였다. 여기서 는 전체 객체 탐지 결과 수, 는 추가 검증 대상으로 분류된 탐지 수, 는 초기 자동 수용된 탐지 수, 는 객체 탐지 결과에 확인된 전체 오탐 및 오분류 수를 의미한다. 또한 와 는 각각 초기 자동 수용 결과와 추가 검증 대상에 포함된 오예측 수를 의미한다.
AAER과 ECR은 일반적인 객체 탐지 성능지표가 아니라 본 연구의 선택적 검증 과정에서 자동 수용 결과의 오류와 탐지 오예측의 포착 정도를 평가하기 위해 정의한 지표이다. 이러한 선택적 분기 구조는 일부 예측을 자동 수용하고 나머지를 보류하는 selective prediction의 risk–coverage 개념과 관련된다(Geifman and El-Yaniv, 2017). 본 연구에서 추가 검증률의 보완값은 YOLO가 생성한 탐지 결과 중 초기 자동 수용되는 비율이라는 점에서 coverage와 유사하며, AAER은 자동 수용된 결과에서 관찰되는 오류 비율이라는 점에서 selective risk와 유사한 의미를 가진다.
다만 본 연구는 객체 탐지 모델 자체의 전체 검출 성능이 아니라 객체 탐지 이후의 선택적 의사결정 경로를 평가하는 것을 목적으로 한다. 따라서 ECR의 분모 에는 YOLO가 생성한 탐지 결과에서 발생한 오탐과 오분류만 포함하였으며, 탐지 결과 자체가 생성되지 않은 FN은 후속 분기 대상이 아니므로 포함하지 않았다. VLM 검증 대상 감소율은 Global Threshold Routing에서 추가 검증 대상으로 분류된 탐지 수를 기준으로 Risk-Aware Routing에서 감소한 탐지 수의 비율로 산출하였다.
전체 의사결정 경로 평가에서는 Risk-Aware Routing 이후의 선택적 VLM 검증과 전문가 검토 이관까지 포함한 최종 처리 결과를 평가하였다. 최종 자동 판단률(Final Automation Rate)은 전체 탐지 결과 중 초기 자동 수용 결과와 VLM 확인 자동 판단 결과를 합한 최종 자동 판단 결과의 비율로 정의하였다. 전문가 검토율(Human Review Rate)은 전체 탐지 결과 중 전문가 검토 대상으로 이관된 결과의 비율로 정의하였다.
또한 최종 자동 판단 오류율(Final Automatic Decision Error Rate)은 최종 자동 판단 결과 중 오예측이 차지하는 비율로 정의하였으며, 최종 오류 포착률(Final Error Capture Rate)은 전체 탐지 오예측 중 최종적으로 전문가 검토 대상으로 이관된 오예측의 비율로 산출하였다. Human Review Rate는 전문가에게 전달되는 검토 대상의 규모를 나타내는 지표이며, 본 연구에서는 전문가가 실제로 수행한 최종 판정의 정확도나 검토 소요시간은 별도로 평가하지 않았다.
선택적 분기의 역할을 추가로 비교하기 위해 시험 데이터에서 생성된 모든 탐지 결과에 2.4절과 동일한 VLM 검증 절차를 적용하는 Full-VLM 전략을 추가로 평가하였다. Full-VLM과 선택적 VLM 전략은 VLM 호출 수, 최종 자동 판단 수, 전문가 검토 수, 최종 자동 판단 오류율 및 최종 오류 포착률을 기준으로 비교하였다.
독립 촬영 세션 데이터에 대한 분기 정책 평가
클래스별 수용 임계값의 새로운 촬영 조건에 대한 이전 가능성을 평가하기 위해, 기존 2025년 데이터와 별도로 획득된 2026년 UAV 촬영 자료를 독립 촬영 세션 추가 평가 자료로 사용하였다. 2026년 8월 13일 원주 타워크레인 교육장에서 총 195장의 영상을 촬영하였으며, 2025년 자료와 다른 UAV 기종인 DJI Matrice 4TD를 사용하였다. 이 가운데 본 연구의 평가 대상 구성요소가 영상에 포함된 36장을 객체 탐지 결과를 확인하기 전에 선정하였다.
선정된 36개 영상에는 최초 112개의 정답 객체가 포함되어 있었으며, 이 중 본 연구의 7개 평가 클래스에 포함되지 않는 마스트 스토퍼 4개를 제외하여 최종 108개의 정답 객체를 평가에 사용하였다. 최종 평가 객체는 bolt_cap_ok 85개와 turntable_motor_ok 23개로 구성되었으며, 결함 상태의 정답 객체는 포함되지 않았다.
독립 촬영 세션 평가에서는 기존 객체 탐지 모델의 가중치를 그대로 사용하였으며, 해당 추가 촬영 자료에 대한 추가 학습이나 미세조정은 수행하지 않았다. 또한 2025년 검증 데이터에서 결정된 클래스별 수용 임계값과 Global Threshold Routing의 임계값도 추가 촬영 자료에 맞추어 재설정하지 않고 그대로 적용하였다. 객체 탐지 결과와 정답 객체의 대응 및 FP, misclassification, FN의 정의에는 내부 시험평가와 동일한 기준을 적용하였다.
본 평가는 객체 탐지 또는 결함 검출 성능의 외부 일반화를 검증하기 위한 것이 아니라, 기존 검증 데이터에서 결정된 분기 정책을 재조정하지 않고 새로운 촬영 조건에서 생성된 탐지 결과에 적용했을 때의 선택 특성을 평가하기 위한 것이다. 특히 결함 상태의 정답 객체가 포함되지 않았으므로, 본 평가는 결함 상태에 대한 분기 정책의 일반화 성능을 검증하는 자료로 해석하지 않았다.
연구결과
추가 검증 대상 분기 전략 비교
시험 데이터 59장에는 총 178개의 정답 객체가 포함되었으며, YOLO는 총 170건의 탐지 결과를 생성하였다. 이 중 140건은 정답 클래스와 일치하였고, 17건은 오탐, 13건은 오분류로 확인되어 탐지 결과에서 총 30건의 오예측이 발생하였다. 또한 객체 탐지 단계에서 검출되지 않은 미탐 25건은 후속 분기 및 VLM 검증의 입력이 될 수 없으므로 별도로 집계하였다. 따라서 이후 분기 전략의 자동 수용 오류율과 오류 포착률은 YOLO가 생성한 170건의 탐지 결과와 그중 확인된 30건의 오예측을 기준으로 평가하였다.
170건의 탐지 결과를 대상으로 YOLO Only, Global Threshold Routing, Risk-Aware Routing을 비교하였으며, 동일한 검증량에서의 비교를 위해 Risk-Aware Routing과 추가 검증 대상 수를 맞춘 전역 임계값 조건도 함께 평가하였다(Table 2). YOLO Only는 모든 탐지 결과를 추가 검증 없이 초기 자동 수용하므로 30건의 오예측도 모두 자동 수용되어 자동 수용 오류율(AAER)은 17.65%, 오류 포착률(ECR)은 0%로 나타났다. 반면 검증 데이터에서 산출한 고정 전역 임계값을 적용한 Global Threshold Routing은 170건 중 154건(90.59%)을 추가 검증 대상으로 분류하고 16건만 초기 자동 수용하였다. 이 과정에서 30건의 오예측이 모두 추가 검증 대상으로 분류되어 AAER은 0%, ECR은 100%로 나타났다.
Table 2.
Performance comparison of routing strategies for selective VLM verification
Risk-Aware Routing은 170건 중 95건을 초기 자동 수용하고 75건(44.12%)을 추가 검증 대상으로 분류하였다. 이는 Global Threshold Routing의 154건과 비교하여 추가 검증 대상이 79건, 즉 51.30% 감소한 결과이다. 반면 검증 데이터에서 산출된 클래스별 수용 임계값을 시험 데이터에 적용한 결과, 7건의 오예측이 임계값 이상으로 분류되어 초기 자동 수용되었으며, 이에 따라 AAER은 7.37%로 나타났다. 전체 30건의 탐지 오예측 중 23건이 추가 검증 대상으로 분류되어 ECR은 76.67%였다. 따라서 Global Threshold Routing과 비교할 때 Risk-Aware Routing은 추가 검증 대상을 51.30% 감소시켰으나, ECR은 100%에서 76.67%로 감소하고 AAER은 0%에서 7.37%로 증가하였다. 이는 추가 검증 대상의 감소와 탐지 오예측 포착 성능 사이에 상충관계가 있음을 보여준다.
추가로 동일한 검증량에서 두 분기 방식의 선택 특성을 비교하기 위해, Risk-Aware Routing과 동일하게 75건이 추가 검증 대상으로 분류되도록 시험 데이터에서 전역 임계값을 사후적으로 조정하였다. 이때 전역 임계값은 0.80802였으며, 자동 수용 오류율은 7.37%, 오류 포착률은 76.67%로 Risk-Aware Routing과 동일하게 나타났다. 따라서 내부 시험 데이터에서는 동일한 검증량을 적용할 경우 두 방식의 전체적인 AAER과 ECR 차이는 나타나지 않았다.
또한 최소 자동 수용 표본수에 대한 민감도 분석에서는 3건과 5건을 적용한 경우 동일한 분기 결과가 나타났으며, 10건으로 증가시킨 경우 추가 검증 대상은 109건(64.12%)으로 증가하였다. 이 경우 AAER은 0%, ECR은 100%로 나타나 최소 지지 표본수를 10건으로 증가시킨 경우보다 보수적인 분기 결과가 나타났다. 또한 검증 영상을 복원추출하여 구성한 1,000개의 재구성 자료에서는 표본 수가 적은 일부 클래스에서 해당 클래스의 탐지를 모두 추가 검증 대상으로 처리하는 경우가 상대적으로 자주 나타났다. 그 비율은 stopper_packing_missing 7.5%, stopper_packing_ok 14.4%, turntable_motor_oil_leak 29.0%, turntable_motor_ok 26.4%였다. 이는 표본 수가 적은 클래스의 수용 임계값이 검증 데이터의 구성에 상대적으로 민감할 수 있음을 보여준다.
VLM 기반 선택적 검증 및 최종 판단 결과
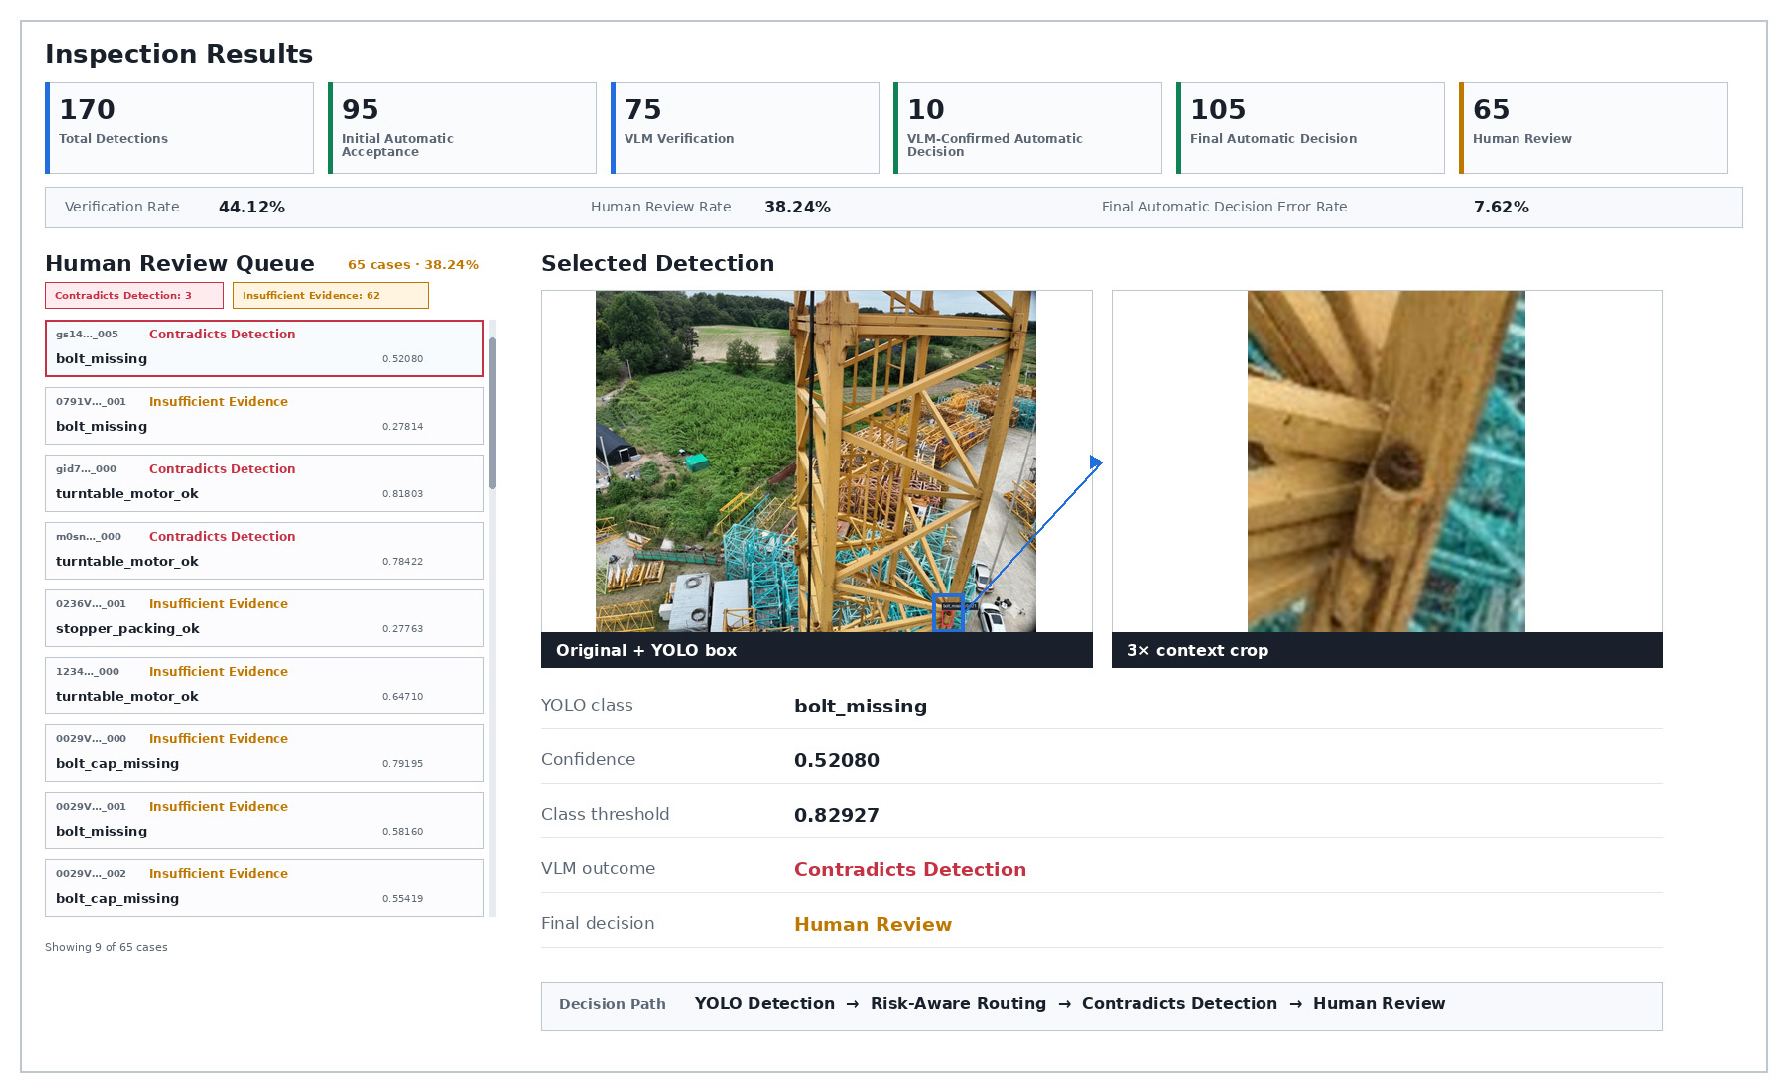
Risk-Aware Routing에서 추가 검증 대상으로 분류된 75건에 대해 VLM 기반 선택적 이차 시각 검증을 수행하였다. 그 결과 10건은 Supports Detection, 3건은 Contradicts Detection, 62건은 Insufficient Evidence로 분류되었다. 사전에 정의한 판단 정책에 따라 Supports Detection으로 분류된 10건은 VLM 확인 자동 판단으로 처리하였으며, Contradicts Detection과 Insufficient Evidence에 해당하는 65건은 전문가 검토 대상으로 이관하였다. 초기 자동 수용된 95건과 VLM 확인 자동 판단 10건을 합하면 전체 170건 중 105건(61.76%)이 최종 자동 판단되고 65건(38.24%)이 전문가 검토 대상으로 분류되었다. VLM 검증을 적용하지 않고 추가 검증 대상 75건을 모두 전문가 검토로 이관하는 경우와 비교하면, 선택적 VLM 검증을 통해 전문가 검토 대상은 75건에서 65건으로 10건(13.33%) 감소하였다. 대표적인 VLM 판단 사례는 Fig. 2에 제시하였다.
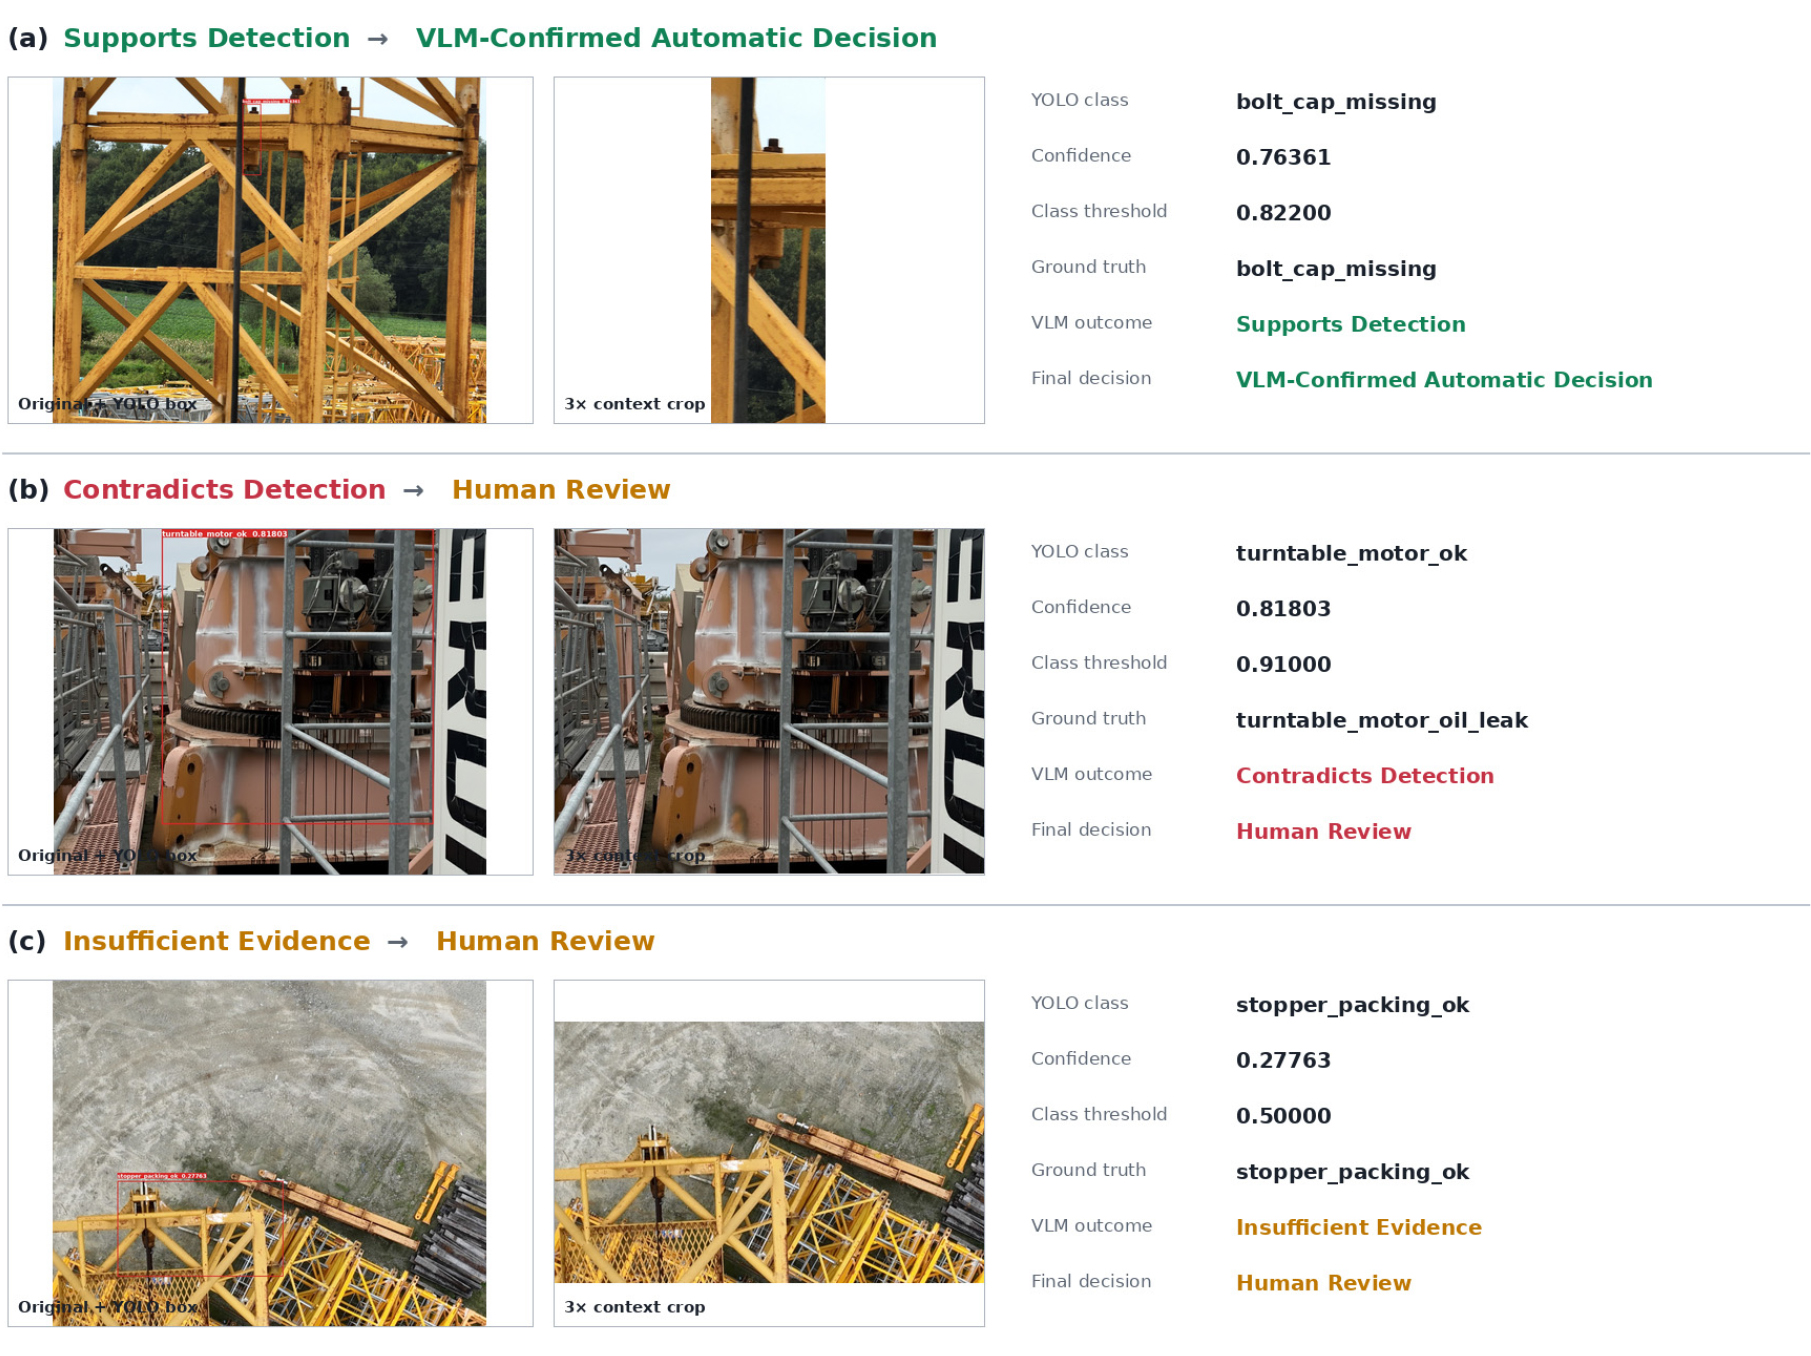
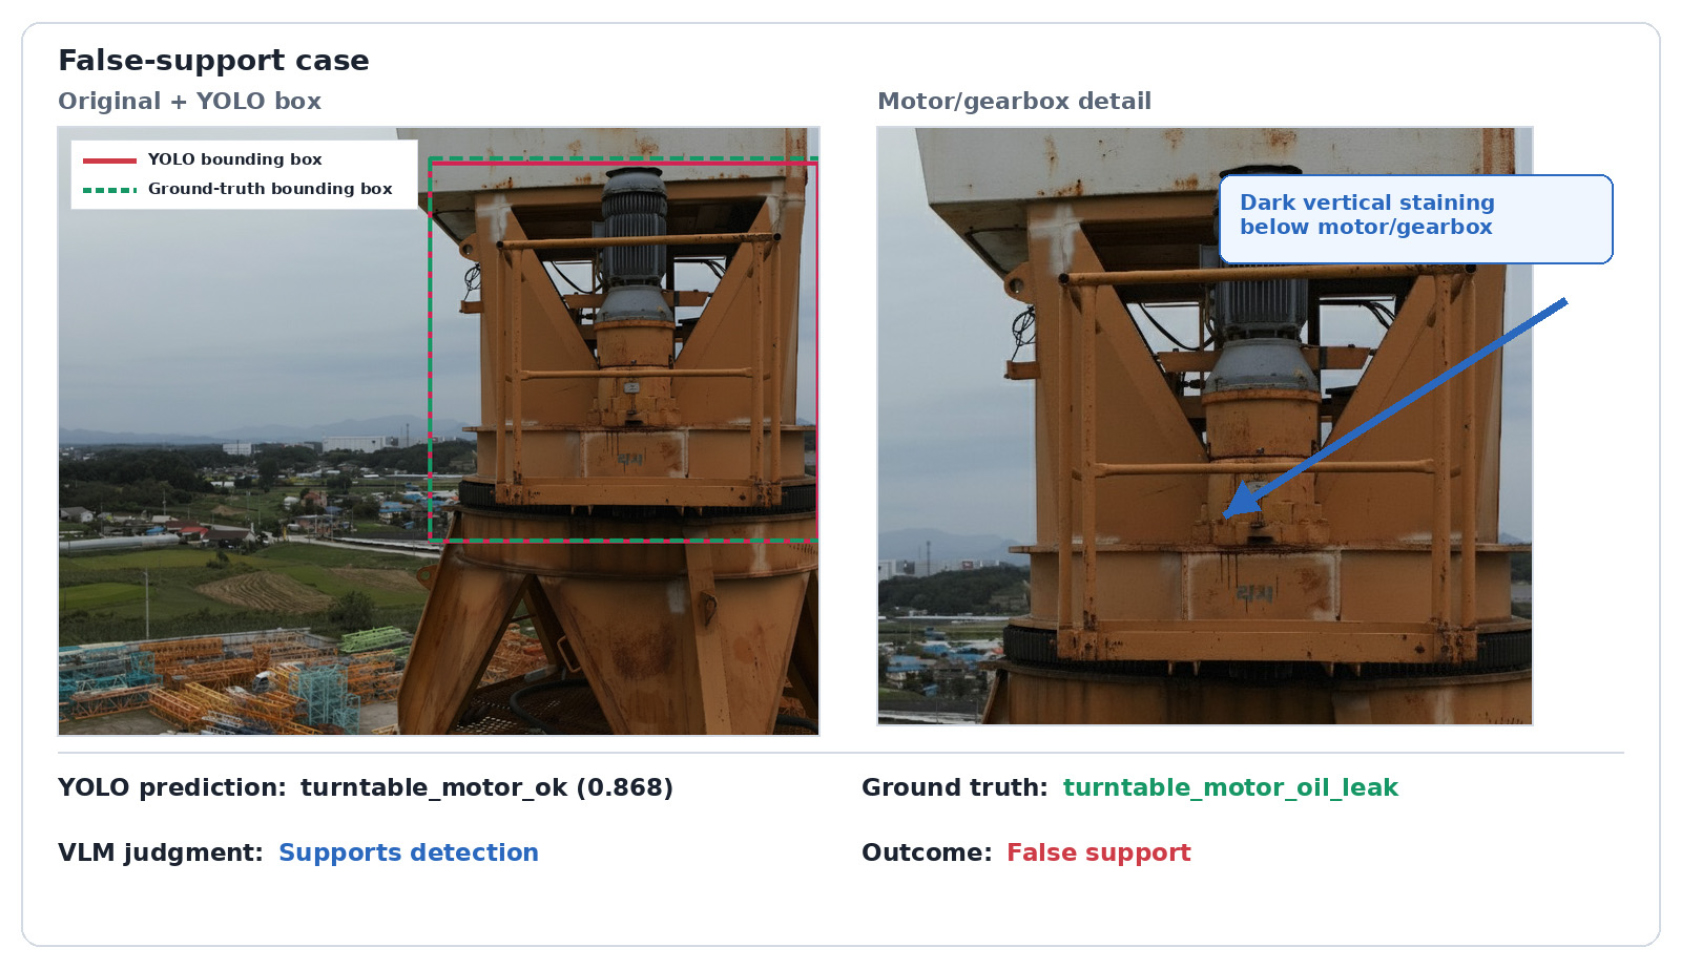
VLM이 탐지 결과를 지지한 10건 중 9건은 올바른 탐지였으며, 1건은 YOLO의 오예측을 VLM이 잘못 지지한 false-support 사례였다. 따라서 최종 자동 판단된 105건에는 Risk-Aware Routing 단계에서 초기 자동 수용된 오예측 7건과 VLM 검증 단계에서 잘못 지지된 오예측 1건을 포함하여 총 8건의 오예측이 포함되었으며, 최종 자동 판단 오류율(Final Automatic Decision Error Rate)은 7.62%로 나타났다. 한편 전체 30건의 탐지 오예측 중 22건이 최종적으로 전문가 검토 대상으로 이관되어 최종 오류 포착률(Final Error Capture Rate)은 73.33%였다.
Risk-Aware Routing 단계만을 기준으로 하면 전체 30건의 탐지 오예측 중 23건이 추가 검증 대상으로 분류되어 ECR은 76.67%였다. 선택적 VLM 검증을 거친 후에는 이 중 1건이 false support를 통해 최종 자동 판단으로 전환되어 최종 오류 포착률은 73.33%로 감소하였다. 따라서 VLM 기반 선택적 검증은 전문가 검토 대상을 10건 감소시켰으나, 이 과정에서 1건의 탐지 오예측이 추가로 최종 자동 판단에 포함되었다.
Insufficient Evidence가 많이 발생한 원인을 확인하기 위해, 기존에 Insufficient Evidence로 판단된 62건에 대해 예측 클래스, 신뢰도 및 검증 프롬프트는 동일하게 유지하고, 기존 3배 맥락 영상에 검증 대상 경계상자만 추가로 표시하여 다시 평가하였다. 그 결과 60건(96.77%)은 여전히 Insufficient Evidence로 판단되었고, 1건은 Supports Detection, 1건은 Contradicts Detection으로 변경되었다. 따라서 검증 대상의 위치를 명시하는 것만으로는 대부분의 판단 보류가 해소되지 않았다.
또한 VLM에 제공되는 객체 탐지 예측 클래스의 영향을 확인하기 위해 예측 클래스 변경 분석을 수행하였다. 전체 75건의 추가 검증 대상 중 대응 가능한 정상–결함 상태 클래스 쌍을 정의할 수 있는 60건을 대상으로, 영상과 신뢰도 등 나머지 입력 조건은 동일하게 유지한 상태에서 예측 클래스만 반대 상태로 변경하였다. 대응 상태 클래스가 정의되지 않는 bolt_missing 관련 15건은 분석에서 제외하였다. 그 결과 60건 중 16건(26.67%)에서 VLM 판단 결과가 변경되었다. 판단 변화는 Supports Detection, Contradicts Detection 및 Insufficient Evidence 사이의 여러 방향에서 관찰되었다. 이는 VLM의 판단이 입력 영상뿐 아니라 함께 제공된 예측 클래스 정보에도 일정 수준 영향을 받을 수 있음을 보여준다. 다만 이 결과만으로 예측 클래스 정보가 개별 판단의 직접적인 원인이라고 단정할 수는 없다.
선택적 분기의 역할을 확인하기 위해 모든 170건의 탐지 결과에 동일한 VLM 검증 절차를 적용한 Full-VLM 전략과 추가로 비교하였다. Full-VLM 비교에서는 기존 선택적 검증 75건의 결과를 그대로 사용하고, 나머지 95건에 동일한 검증 절차를 추가로 적용하였다. Full-VLM에서는 170건 중 55건이 Supports Detection, 3건이 Contradicts Detection, 112건이 Insufficient Evidence로 분류되었다. 그 결과 55건이 최종 자동 판단되고 115건이 전문가 검토 대상으로 분류되었으며, 최종 자동 판단 오류율은 1.82%, 최종 오류 포착률은 96.67%였다(Table 3). 이에 비해 선택적 VLM 전략은 VLM 호출 수를 170건에서 75건으로 줄이고 전문가 검토 대상을 115건에서 65건으로 감소시켰으나, 최종 자동 판단 오류율은 증가하고 최종 오류 포착률은 감소하였다. 따라서 두 방식은 검증 부담과 오류 포착 성능 사이에서 서로 다른 선택 특성을 보였다.
Table 3.
Comparison between selective VLM verification and VLM verification of all detections
AI 점검 에이전트 시스템 구현 결과
제안한 정책 기반 AI 점검 에이전트의 의사결정 절차를 실제 점검 시스템에 구현한 결과를 Fig. 3에 나타내었다. 시스템은 각 탐지 결과에 대해 구성요소 상태 클래스, 신뢰도, 선택적 분기 결과, VLM 검증 결과 및 최종 처리 상태를 데이터베이스에 기록하도록 구성하였다. 또한 전문가 검토 대상으로 이관된 결과는 별도의 검토 대기열에 등록하여 원본 영상, 탐지 영역, 객체 탐지 결과 및 VLM 검증 정보를 함께 확인할 수 있도록 하였다. 이러한 구성을 통해 객체 탐지 결과 생성부터 Risk-Aware Routing, 선택적 VLM 검증, 최종 자동 판단 및 전문가 검토 대상 관리까지의 의사결정 절차를 하나의 점검 시스템에서 연계하여 수행할 수 있도록 구현하였다.
독립 촬영 세션 데이터에 대한 평가 결과
2026년에 별도의 촬영 세션에서 획득한 36장의 UAV 영상을 이용하여 고정된 객체 탐지 모델과 분기 정책을 추가 평가하였다(Table 4). 평가 영상은 2026년 8월 13일 촬영된 총 195장의 영상 중 본 연구의 평가 대상 구성요소가 포함된 프레임을 객체 탐지 결과를 확인하기 전에 선정한 것이다. 최초 구축된 112개의 정답 객체 중 본 연구의 7개 평가 클래스에 포함되지 않는 마스트 스토퍼 4개를 제외하여 총 108개의 정답 객체를 평가에 사용하였다. 이들은 bolt_cap_ok 85개와 turntable_motor_ok 23개로 구성되었으며, 결함 상태의 정답 객체는 포함되지 않았다.
Table 4.
Performance comparison of routing strategies on data from an independent UAV acquisition session
YOLO는 55건의 탐지 결과를 생성하였으며, 이 중 30건은 정답 클래스와 일치하였고, 23건은 오탐, 2건은 오분류로 확인되어 총 25건의 오예측이 발생하였다. 객체 탐지 단계의 미탐은 76건으로 별도 집계하였다.
2025년 검증 데이터에서 결정된 임계값을 재조정하지 않고 적용한 결과, Risk-Aware Routing은 55건 중 38건(69.09%)을 추가 검증 대상으로 분류하였으며, 생성된 25건의 오예측을 모두 추가 검증 대상으로 분류하여 AAER은 0%, ECR은 100%로 나타났다. 동일하게 38건을 추가 검증하도록 전역 임계값을 조정한 비교에서는 AAER이 23.53%, ECR이 84.00%로 나타났다. 이때 동일 검증량 비교를 위한 전역 임계값은 0.82539였다. 이는 새로운 촬영 데이터에서 클래스별 임계값과 단일 전역 임계값의 분기 특성이 서로 다르게 나타날 수 있음을 보여준다.
다만 본 추가 촬영 자료에는 결함 상태의 정답 객체가 포함되지 않았으므로, 이 결과는 결함 상태에 대한 분기 정책의 일반화 성능을 검증한 것으로 해석하지 않았다. 본 평가는 기존 임계값을 재조정하지 않은 상태에서 새로운 촬영 조건으로 생성된 탐지 결과에 분기 정책을 적용했을 때의 선택 특성을 확인한 결과로 제한하여 해석하였다.
토 의
선택적 분기에 따른 검증 부담과 오류 포착 성능의 상충관계
본 연구에서 Risk-Aware Routing은 Global Threshold Routing과 비교하여 VLM 기반 추가 검증 대상을 154건에서 75건으로 줄여 검증 대상을 51.30% 감소시켰다. 이는 모든 구성요소 상태 클래스에 동일한 수용 임계값을 적용하는 대신, 검증 데이터에서 관찰된 클래스별 신뢰도와 오예측 특성을 이용하여 서로 다른 수용 기준을 적용함으로써 추가 검증 대상을 선택적으로 조정할 수 있음을 보여준다.
그러나 추가 검증 대상의 감소는 오류 포착 성능의 저하를 동반하였다. Global Threshold Routing에서는 시험 데이터에서 확인된 30건의 탐지 오예측이 모두 추가 검증 대상으로 분류되어 ECR이 100%였으나, Risk-Aware Routing에서는 7건의 오예측이 초기 자동 수용되면서 ECR이 76.67%로 감소하고 AAER은 7.37%로 증가하였다. 따라서 Risk-Aware Routing을 Global Threshold Routing보다 모든 측면에서 우수한 방법으로 해석하기보다는, 추가 검증 부담을 줄이는 대신 일부 오예측의 자동 수용 가능성을 허용하는 선택적 의사결정 방식으로 해석하는 것이 적절하다.
다만 동일한 수의 탐지 결과가 추가 검증 대상으로 분류되도록 전역 임계값을 조정한 경우에는 내부 시험 데이터에서 Risk-Aware Routing과 동일한 AAER 및 ECR이 나타났다. 따라서 본 결과만으로 클래스별 임계값이 단일 전역 임계값보다 항상 우수하다고 해석하기는 어렵다. 반면 별도의 촬영 세션에서 획득한 추가 데이터에서는 동일한 검증량 조건에서도 두 방식의 오류 포착 특성이 다르게 나타나, 촬영 조건이나 데이터 분포가 변화할 경우 클래스별 신뢰도–오예측 특성을 반영한 분기가 단일 전역 임계값과 다른 선택 특성을 보일 수 있음을 확인하였다. 다만 해당 추가 촬영 자료에는 결함 상태의 정답 객체가 포함되지 않았으므로, 이 결과를 결함 상태를 포함한 일반적인 외부 일반화 성능의 근거로 해석해서는 안 된다.
특히 검증 데이터에서는 선정된 클래스별 수용 임계값을 적용했을 때 초기 자동 수용 결과에 오예측이 포함되지 않았으나, 동일한 임계값을 임계값 설정에 사용하지 않은 시험 데이터에 적용한 결과 7건의 오예측이 초기 자동 수용되었다. 이는 특정 검증 데이터에서 관찰된 신뢰도와 오예측 분포를 기반으로 설정한 수용 임계값이 새로운 데이터에서도 동일한 오류 특성을 보장하는 것은 아님을 의미한다. 더욱이 본 연구의 기존 학습·검증·시험 데이터는 촬영 세션 단위가 아닌 영상 단위로 분할되었고 일부 동일 영상의 중복도 확인되었으므로, 내부 시험 결과는 완전히 독립적인 촬영 조건에 대한 일반화 성능이 아니라 고정된 분기 정책의 내부 평가 결과로 제한하여 해석할 필요가 있다. 따라서 클래스별 수용 임계값은 절대적인 안전 기준이라기보다 자동 수용과 추가 검증 사이의 범위를 조절하는 의사결정 정책으로 보는 것이 타당하다.
또한 최소 자동 수용 표본수와 검증 데이터의 구성에 따라 일부 클래스의 임계값과 분기 결과가 변화하였다. 특히 표본 수가 적은 클래스에서는 복원추출 자료에 따라 유효한 자동 수용 임계값을 설정하지 못하고 전체 탐지를 추가 검증 대상으로 처리하는 경우가 상대적으로 자주 나타났다. 이는 class-specific threshold가 데이터 구성에 영향을 받을 수 있음을 보여주며, 현재의 임계값을 일반적으로 적용 가능한 고정 기준이라기보다 제한된 검증 데이터에서 도출된 경험적 정책 변수로 해석하는 것이 적절하다.
이러한 관점에서 본 연구의 선택적 분기가 갖는 의미는 탐지 오예측을 완전히 제거하는 데 있기보다, 추가 검증 부담과 자동 수용 결과에 남는 오류 사이의 상충관계를 정량적으로 평가하고 조절할 수 있는 구조를 제시하는 데 있다. 실제 적용에서는 허용 가능한 자동 수용 오류 수준과 추가 검증에 필요한 비용을 함께 고려하여 수용 임계값을 설정할 필요가 있으며, 요구되는 보수성의 정도는 대상 설비의 안전 중요도와 점검 목적에 따라 달라질 수 있다. 따라서 본 연구의 기여는 특정 클래스별 임계값 자체의 보편적 우수성을 제시하는 데 있지 않고, 클래스별 예측 오류 특성을 이용한 선택적 분기 정책의 민감도와 검증 부담–오류 포착 간 trade-off를 실증적으로 평가한 데 있다.
VLM 기반 선택적 검증의 역할과 한계
Risk-Aware Routing에서 추가 검증 대상으로 분류된 75건에 VLM 기반 이차 시각 검증을 적용한 결과, 10건은 Supports Detection, 3건은 Contradicts Detection, 62건은 Insufficient Evidence로 분류되었다. 즉 추가 검증 대상의 82.67%가 Insufficient Evidence로 판단되었다. 본 연구에서는 이러한 결과를 판단 보류 상태로 처리하여 전문가 검토 대상으로 이관하였다.
Insufficient Evidence의 비율이 높게 나타난 것은 본 연구의 VLM이 모든 추가 검증 대상에 대해 강제적인 이진 판단을 수행하도록 설계되지 않았기 때문이다. VLM은 YOLO 탐지 영역 주변의 제한된 맥락 영상만을 입력받으며, 제공된 시각적 근거만으로 기존 탐지 결과를 충분히 확인하기 어려운 경우에는 판단을 보류하도록 하였다. 실제로 판단 보류 사례에 검증 대상 경계상자를 추가로 표시한 경우에도 62건 중 60건이 Insufficient Evidence로 유지되었다. 이는 높은 판단 보류 비율이 검증 대상의 위치를 특정하기 어려운 문제만으로 설명되지는 않으며, 입력 영상 자체에서 클래스 상태를 판별하기 위한 시각적 근거가 충분하지 않은 경우가 주요한 제약으로 작용했을 가능성을 보여준다. 이러한 판단 보류는 불확실한 예측에서 응답을 강제하지 않고 보류를 허용하는 selective prediction의 개념과 관련된다(Srinivasan et al., 2024). 본 연구에서 이러한 구조는 자동화 범위를 제한하는 요인이지만, 시각적 근거가 부족한 결과를 무리하게 자동 판단하지 않고 전문가에게 이관한다는 점에서 전문가 검토 연계형 점검을 위한 보수적인 의사결정 기능으로 볼 수 있다.
한편 선택적 VLM 검증을 통해 추가 검증 대상 75건 중 10건을 VLM 확인 자동 판단으로 전환함으로써 전문가 검토 대상은 75건에서 65건으로 13.33% 감소하였다. 그러나 Supports Detection으로 분류된 10건 중 1건은 실제로 YOLO의 오예측을 VLM이 지지한 false-support 사례였다. 이에 따라 Risk-Aware Routing 단계에서 76.67%였던 ECR은 전체 의사결정 경로를 적용한 후 최종 오류 포착률 73.33%로 감소하였다.
Fig. 4는 이러한 false-support 사례를 보여준다. 해당 사례에서 YOLO는 turntable_motor_oil_leak을 turntable_motor_ok로 잘못 분류하였으며, VLM은 이러한 YOLO의 예측을 Supports Detection으로 판단하였다. 영상에서는 모터/기어박스 하부의 어두운 얼룩과 수직 변색이 국소적인 누유 흔적인지, 주변 구조물의 녹·오염 또는 표면 변색인지 시각적으로 명확하게 구분하기 어려웠다. 또한 VLM에 제공되는 예측 클래스만 반대 상태로 변경했을 때 일부 사례에서 판단 결과가 달라졌다. 예측 클래스 변경이 가능한 60건 중 16건(26.67%)에서 VLM 판단이 변화하였으며, 이러한 변화는 Supports Detection, Contradicts Detection 및 Insufficient Evidence 사이의 여러 방향에서 관찰되었다. 이는 VLM의 검증 결과가 영상 자체의 시각 정보뿐 아니라 함께 제공되는 객체 탐지 정보에도 일정 수준 영향을 받을 수 있음을 보여준다. 다만 이러한 결과만으로 예측 클래스 정보가 해당 false-support 사례의 직접적인 원인이라고 단정할 수는 없다.
이 결과는 VLM을 객체 탐지 결과의 정확성을 독립적으로 보증하는 최종 판정자로 사용하기보다, 일부 결과에 대해 추가적인 시각적 근거를 제공하고 충분한 근거를 확보하지 못한 경우에는 전문가에게 판단을 이관하는 보조 검증 수단으로 사용하는 것이 적절함을 보여준다. 최근 산업 점검을 대상으로 한 VLM 평가에서도 세밀한 객체 탐지와 시각적 grounding 및 robustness 측면의 한계가 보고되어, 높은 정밀도가 요구되는 산업 점검에서 VLM을 독립적인 판단 수단으로 사용하는 데 주의가 필요한 것으로 나타났다(Wallace et al., 2025). 따라서 안전점검과 같이 오판의 영향이 클 수 있는 응용에서는 VLM이 객체 탐지 결과를 지지했다는 사실만으로 자동 판단의 정확성이 보장되는 것은 아니며, 자동 판단 조건과 판단 보류 기준을 보수적으로 설정할 필요가 있다.
또한 Full-VLM 분석에서 전체 170건에 VLM을 적용하였을 때 112건이 Insufficient Evidence로 분류되어, 판단 보류가 선택적 분기 대상에만 국한된 현상이 아님을 확인하였다. 이는 현재의 VLM 검증 방식이 자동 판단 확대보다는 불확실한 사례를 보수적으로 걸러내는 특성을 강하게 가진다는 것을 보여준다.
전문가 검토 연계형 점검 시스템으로서의 의미
Risk-Aware Routing과 선택적 VLM 검증을 순차적으로 적용한 결과, 전체 170건의 탐지 결과 중 105건(61.76%)이 최종 자동 판단되고 65건(38.24%)이 전문가 검토 대상으로 분류되었다. 이는 모든 객체 탐지 결과를 전문가가 직접 확인하는 방식과 비교할 때 전문가에게 전달되는 검토 대상의 규모를 줄일 가능성을 보여준다.
그러나 최종 자동 판단된 105건 중 8건이 오예측으로 확인되어 최종 자동 판단 오류율은 7.62%였다. 따라서 본 연구에서 제안한 시스템을 전문가를 대체하는 완전 자동 점검 시스템으로 해석하는 것은 적절하지 않다. 최근 다양한 분야의 객체 탐지 결과를 대상으로 VLM 기반 품질평가를 수행한 연구에서도 모델과 적용 분야에 따른 성능 차이가 확인되어, VLM의 활용에는 감독 기반의 접근이 필요한 것으로 보고되고 있다(Abdelkader, 2026). 따라서 본 연구의 시스템 역시 자동 처리 가능한 결과를 선별하고 불확실하거나 상충되는 결과를 전문가에게 집중적으로 이관하는 전문가 검토 연계형 점검의 의사결정 구조로 보는 것이 타당하다.
모든 탐지 결과에 VLM을 적용한 경우에는 선택적 VLM 방식보다 높은 최종 오류 포착률과 낮은 자동 판단 오류율을 얻을 수 있었으나, VLM 검증 수와 전문가 검토 대상은 모두 증가하였다. 구체적으로 Full-VLM은 170회의 VLM 호출을 통해 최종 오류 포착률 96.67%, 최종 자동 판단 오류율 1.82%를 보였으나 전문가 검토 대상은 115건(67.65%)이었다. 반면 선택적 VLM 방식은 VLM 호출을 75회로 줄이고 전문가 검토 대상도 65건(38.24%)으로 감소시켰지만, 최종 오류 포착률은 73.33%로 낮아지고 최종 자동 판단 오류율은 7.62%로 증가하였다. 따라서 선택적 분기의 역할은 Full-VLM을 정확도 측면에서 대체하는 데 있기보다, 제한된 검증 자원을 어느 탐지 결과에 우선적으로 배분할 것인지 결정하는 데 있다고 볼 수 있다.
이러한 관점에서 시스템의 성능을 Final Automation Rate만으로 평가하는 것은 적절하지 않다. 자동화율을 높이기 위해 수용 임계값이나 VLM 자동 판단 조건을 완화하면 전문가 검토 대상은 감소할 수 있지만, 최종 자동 판단 결과에 포함되는 오예측이 증가할 가능성이 있다. 반대로 보다 보수적인 기준을 적용하면 오류 포착 성능은 높일 수 있으나 추가 검증량과 전문가 검토 부담이 증가할 수 있다. 따라서 실제 점검 시스템에서는 자동화율, 자동 판단 오류율 및 오류 포착률을 함께 고려하여 의사결정 정책을 설정할 필요가 있다.
또한 본 연구에서 구현한 시스템은 각 탐지 결과의 예측 클래스와 신뢰도, 선택적 분기 결과, VLM 검증 상태 및 최종 처리 상태를 데이터베이스와 전문가 검토 대기열에서 함께 관리하도록 구성하였다. 이러한 구조는 AI의 최종 판단 결과뿐만 아니라 해당 결과가 어떤 의사결정 경로를 통해 처리되었는지를 추적할 수 있게 한다. 향후 실제 전문가 검토 결과를 지속적으로 축적할 경우, 이를 이용하여 클래스별 수용 임계값과 VLM 검증 정책을 재평가하고 보정하는 폐루프(closed-loop) 점검 체계로 확장할 수 있을 것으로 판단된다.
다만 본 연구에서는 Human Review Rate를 전문가에게 이관되는 검토 대상의 규모를 나타내는 지표로만 평가하였으며, 실제 전문가의 검토시간, 업무량 감소, 최종 판정 정확도 등은 측정하지 않았다. 따라서 본 연구에서 전문가 검토 대상의 감소가 실제 현장 점검시간이나 인적 비용의 감소로 직접 이어진다고 단정할 수는 없으며, 이러한 운영 효과는 향후 현장 적용 연구에서 별도로 검증할 필요가 있다.
연구의 한계 및 향후 연구
본 연구에는 몇 가지 한계가 있다. 첫째, 클래스별 수용 임계값은 특정 검증 데이터에서 관찰된 신뢰도와 오예측 특성을 기반으로 산출되었다. 본 연구에서는 별도의 2026년 촬영 세션 자료에 기존 임계값을 변경하지 않고 적용하여 새로운 촬영 조건에서 분기 정책의 선택 특성을 추가로 평가하였다. 한편 최소 자동 수용 표본수나 검증 영상의 구성을 변경하여 임계값을 다시 산출한 결과, 일부 클래스에서는 임계값과 분기 결과가 달라졌다. 이러한 변화는 특히 표본 수가 적은 클래스에서 크게 나타났다. 이는 클래스별 수용 임계값이 검증 데이터의 규모와 구성에 영향을 받을 수 있음을 보여준다.
또한 선행연구의 학습·검증·시험 데이터는 촬영 세션 단위가 아니라 영상 단위로 분할되었고 일부 동일 영상이 서로 다른 데이터셋에 중복 포함된 사실이 사후 확인되었다. 따라서 내부 시험 결과는 완전히 독립된 촬영 조건에 대한 일반화 성능으로 해석할 수 없다. 2026년 별도 촬영 세션 자료는 이러한 한계를 일부 보완하지만, 해당 자료에는 결함 상태의 정답 객체가 포함되지 않았으므로 결함 상태에 대한 일반화 성능을 입증하는 근거가 되지는 않는다. 따라서 본 연구에서 얻은 개별 임계값이 다양한 타워크레인과 촬영 조건에서 동일하게 적용된다고 일반화하기는 어렵다. 본 연구에서 제안하는 핵심은 특정 임계값 자체보다 검증 데이터의 클래스별 예측 특성을 이용하여 자동 수용 기준을 설정하는 절차에 있으며, 향후 보다 다양한 현장 데이터를 이용한 검증이 필요하다.
둘째, 본 연구의 후속 의사결정 절차는 YOLO가 생성한 탐지 결과만을 대상으로 한다. 시험 데이터에서는 객체 탐지 단계에서 25건의 미탐(FN)이 발생하였으며, 이들 객체는 후속 분기와 VLM 검증의 입력 자체가 생성되지 않기 때문에 현재 시스템으로 복구할 수 없다. 독립 촬영 세션 자료에서도 108개의 정답 객체 중 76건의 미탐이 확인되어, 객체 탐지 단계의 재현율이 후속 의사결정 구조의 적용 가능성을 제한할 수 있음을 보여준다. 따라서 제안 방법은 객체 탐지 모델의 재현율 자체를 개선하는 방법이 아니라, 객체 탐지 이후 생성된 결과의 오예측 처리와 후속 검증 자원 배분을 다루는 방법으로 범위를 제한하여 해석해야 한다. 본 연구에서 보고한 검증 부담 감소는 YOLO가 생성한 탐지 결과에 대한 후속 검증 부담의 감소를 의미하며, 전체 점검 과정의 안전성 향상이나 전체 결함 검토 부담의 감소를 직접 의미하지 않는다.
셋째, VLM 기반 검증의 안정성과 재현성에는 여전히 한계가 있다. 검증 대상의 위치를 경계상자로 명확히 표시한 경우에도 대부분의 판단 보류가 유지되었으며, 제공되는 예측 클래스가 달라질 경우 일부 VLM 판단이 변경되었다. 이는 VLM 검증 결과가 객체 위치의 명확성만으로 결정되는 것이 아니라 영상의 시각적 근거와 함께 제공되는 입력 정보에도 영향을 받을 수 있음을 보여준다. 또한 본 연구에서는 각 검증 대상에 대해 1회의 추론만 수행하였으므로, 향후에는 맥락 영상의 범위와 구성, 프롬프트 설계, 반복 추론 및 모델 변화가 VLM 검증 결과에 미치는 영향을 추가로 평가할 필요가 있다. 아울러 기본 선택적 검증과 추가 보조실험은 동일한 요청 모델을 사용하였지만 서로 다른 Codex CLI 버전에서 수행되었으므로, 향후에는 실행 환경을 보다 엄격히 고정한 반복 실험을 통해 결과의 재현성을 확인할 필요가 있다.
넷째, 본 연구에서는 오탐과 오분류를 탐지 오예측으로 통합하여 AAER과 ECR을 산출하였으며, 오예측의 유형이나 실제 안전 영향에 따른 비용 차이는 반영하지 않았다. 그러나 실제 설비 점검에서는 정상 상태를 결함으로 판단하는 오류와 실제 결함을 정상 상태로 자동 수용하는 오류가 동일한 안전·운영 영향을 갖는다고 보기 어렵다. 향후에는 구성요소와 결함 유형별 중요도, 오류의 방향 및 안전 영향을 반영한 비용 민감형(cost-sensitive) 또는 안전 중요도 기반 의사결정 정책을 검토할 필요가 있다. 이러한 확장은 현재의 prediction-error-aware routing을 실제 안전 중요도와 오류 비용을 반영하는 risk-aware decision policy로 발전시키는 방향이 될 수 있다.
마지막으로 본 연구에서는 별도의 촬영 세션에서 획득한 자료를 이용하여 분기 정책의 적용 특성을 추가로 평가하였으나, 제안한 시스템의 일반적인 적용 가능성을 평가하기 위해서는 보다 다양한 타워크레인과 촬영 환경을 대상으로 추가적인 현장 검증이 필요하다. 이와 함께 미탐을 후속 단계에서 보완할 수 있는 분석 절차, VLM의 판단 보류 기준 및 검증 안정성을 개선할 필요가 있다. 나아가 본 연구의 선택적 검증 구조는 타워크레인뿐만 아니라 광산의 대형 기계설비, 접근이 어려운 구조물 및 석유·가스 생산설비와 같이 원격 영상 기반 점검이 필요한 자원개발 현장을 대상으로 적용 가능성을 검토할 수 있다.
결 론
본 연구에서는 UAV 기반 타워크레인 객체 탐지 결과를 대상으로 예측 오류 위험에 따라 후속 검증 자원을 선택적으로 배분하는 정책 기반 AI 점검 에이전트 시스템을 개발하였다. 검증 데이터에서 관찰된 구성요소 상태 클래스별 신뢰도와 오예측 특성을 이용하여 수용 임계값을 설정하고, 이를 기반으로 탐지 결과를 초기 자동 수용 또는 VLM 기반 추가 검증 대상으로 분기하는 Risk-Aware Routing을 구성하였다. 또한 추가 검증 대상으로 선정된 탐지에 대해서만 VLM 기반 이차 시각 검증을 수행하고, 그 결과에 따라 VLM 확인 자동 판단 또는 전문가 검토로 처리하는 의사결정 구조를 구현하였다.
59장의 시험 영상에서 생성된 170건의 탐지 결과에 Risk-Aware Routing을 적용한 결과, 75건(44.12%)이 추가 검증 대상으로 분류되어 Global Threshold Routing과 비교하여 VLM 검증 대상이 51.30% 감소하였다. 이 과정에서 자동 수용 오류율(AAER)은 7.37%, 오류 포착률(ECR)은 76.67%로 나타났다. 이후 75건에 대해 선택적 VLM 검증을 수행한 결과, 10건은 Supports Detection, 3건은 Contradicts Detection, 62건은 Insufficient Evidence로 분류되었다. 최종적으로 전체 탐지 결과 중 105건(61.76%)이 자동 판단되고 65건(38.24%)이 전문가 검토 대상으로 이관되었으며, 최종 자동 판단 오류율은 7.62%, 최종 오류 포착률은 73.33%로 나타났다. 반면 전체 170건에 VLM 검증을 적용한 Full-VLM에서는 최종 오류 포착률이 96.67%로 증가하고 최종 자동 판단 오류율은 1.82%로 감소하였으나, VLM 호출 수와 전문가 검토 대상은 각각 170건과 115건으로 증가하였다.
이러한 결과는 클래스별 예측 특성을 반영한 선택적 분기를 통해 모든 탐지 결과에 동일한 추가 검증을 적용하는 경우보다 검증 대상을 줄일 수 있음을 보여준다. 동일한 검증량으로 전역 임계값 방식을 비교한 내부 시험에서는 두 방식의 전체 오류 지표가 동일하게 나타났으나, 별도의 촬영 세션에서 획득한 자료에서는 동일한 검증량에서도 서로 다른 오류 포착 특성이 나타났다. 다만 해당 추가 촬영 자료에는 결함 상태의 정답 객체가 포함되지 않았으므로, 이를 결함 상태에 대한 일반적인 외부 일반화 성능의 근거로 해석하지 않았다. 이는 클래스별 분기가 항상 우수하다는 의미라기보다, 데이터 조건에 따라 단일 전역 임계값과 다른 방식으로 검증 대상을 선택할 수 있음을 보여준다.
또한 선택적 VLM 검증을 통해 일부 추가 검증 대상을 자동 판단으로 전환하여 전문가에게 이관되는 검토 대상을 추가로 줄일 수 있었다. 그러나 추가 검증 대상을 줄이고 자동화 범위를 확대하는 과정에서 일부 오예측이 최종 자동 판단에 포함되었으므로, 제안 시스템을 전문가를 대체하는 완전 자동 점검 방식으로 해석하는 것은 적절하지 않다. 본 연구의 의의는 특정 클래스별 수용 임계값 자체를 일반적인 기준으로 제안하는 데 있지 않고, 클래스별 선택적 분기, VLM 기반 이차 검증 및 전문가 검토를 하나의 의사결정 경로로 연계한 후, 검증 부담, 자동화 수준 및 오류 포착 성능 사이의 상충관계를 다양한 조건에서 정량적으로 평가한 데 있다.
한편 본 연구에서 적용한 클래스별 수용 임계값은 특정 검증 데이터에서 도출되었으며, 검증 데이터의 표본 수와 구성에 따라 일부 클래스의 임계값과 분기 결과가 달라질 수 있음을 민감도 분석에서 확인하였다. 또한 선행연구의 학습·검증·시험 데이터가 촬영 세션 단위로 독립적으로 구성되지 않았고 일부 동일 영상이 서로 다른 데이터셋에 중복 포함된 사실이 사후 확인되었으므로, 내부 시험 결과를 완전히 독립된 촬영 조건에 대한 일반화 성능으로 해석할 수 없다. 별도의 촬영 세션 자료를 이용하여 고정된 분기 정책의 적용 특성을 추가로 평가하였으나, 해당 자료에는 결함 상태의 정답 객체가 포함되지 않았으므로 보다 다양한 타워크레인과 결함 상태를 포함한 독립 데이터에서 추가 검증이 필요하다.
또한 객체 탐지 단계에서 발생한 미탐은 후속 분기와 VLM 검증을 통해 복구할 수 없으며, VLM 검증에서도 판단 보류와 잘못된 지지가 발생할 수 있다. 따라서 본 연구에서 확인한 검증 부담 감소는 YOLO가 생성한 탐지 결과에 대한 후속 검증 부담의 감소를 의미하며, 전체 점검 과정의 안전성 향상을 직접 의미하지 않는다. 향후에는 다양한 현장 자료를 이용한 임계값의 검증과 보정, 미탐을 보완하기 위한 후속 분석 절차, VLM 검증의 안정성과 판단 보류 기준 개선, 그리고 구성요소와 결함 유형별 오류 비용 및 안전 중요도를 반영한 의사결정 정책을 검토할 필요가 있다. 나아가 광산의 대형 기계설비, 접근이 어려운 구조물 및 석유·가스 생산설비 등 원격 영상 기반 점검이 필요한 자원개발 현장을 대상으로 제안한 선택적 AI 점검 의사결정 구조의 적용 가능성을 검증할 필요가 있다.