

서 론
MCP 기반 광산 배차 시뮬레이션 시스템 설계
시스템 개요 및 구성
MCP 기반 시뮬레이션 도구 설계
설정파일 기반 광산 모델 구성
엔진 구현 및 배차 의사결정 구조
자연어 기반 시뮬레이션 분석 절차
MCP 기반 시뮬레이션 시스템 구현 및 검증
시스템 구현 결과
자연어 분석의 확장 적용
참조 모델 재현을 통한 엔진 검증
토 의
결 론
서 론
광산 운영비에서 운반이 차지하는 비중은 노천광산 기준으로 약 50~60%에 달하며, 광산 운영에서 가장 비용 집약적인 영역이다(Alarie and Gamache, 2002). 국내 광산은 가행 심도의 증가와 광체 품위의 저하로 채산성 압박이 커지고 있으며, 단위 광량당 운영비를 낮추기 위한 노력의 중심에 운반 효율의 개선이 있다. 따라서 트럭 배차의 정량 분석과 의사결정 지원은 광산 수익성에 직접적인 영향을 미치는 영역이다.
그러나 광산 현장에서 이러한 분석을 자체적으로 수행할 수 있는 환경은 미흡하다. 국내 광업의 디지털 전환은 상대적으로 더디며(Kim et al., 2025), 현장 작업자의 고령화와 디지털 활용 역량의 격차는 분석 도구의 활용 자체를 제약한다(Park and Choi, 2022). 또한 기존의 시뮬레이션 도구는 코드 기반 모델링 또는 고가의 상용 소프트웨어 조작을 전제하므로, 현장이 자체 분석 역량으로 활용하기에는 진입 장벽이 높다. 그 결과 광산 트럭 배차의 운영은 담당자의 경험과 노하우에 의존하는 경향이 강하며, 정량적 근거에 기반한 의사결정이 제한적이다.
이에 본 연구에서는 광산 이산사건 시뮬레이션, 트럭 배차 및 운반관리, 그리고 LLM 도구 연동의 세 가지 기술을 하나의 분석 환경으로 결합하고자 한다. 이산사건 시뮬레이션(discrete-event simulation, DES)은 시스템의 상태가 사건의 발생 시점에만 변화한다고 보고 사건을 시간 순으로 처리하는 시뮬레이션 기법으로, 광업 시뮬레이션에서 가장 널리 쓰이고 있다(Banks et al., 2010). 광업 분야에서 DES는 채굴 작업(Anani et al., 2017), 노천광산의 동적 거동(Askari-Nasab et al., 2007), 단기 생산계획, 장비 신뢰성 평가 등 가치사슬 전반에 걸쳐 적용되어 왔으며, 최근에는 디지털 트윈(Reed et al., 2022) 및 기계학습 결합으로 확장되고 있다. 국내에서도 채석·파쇄·출하 공정을 통합한 석재 생산 시뮬레이터가 DES 기반으로 개발된 바 있다(Jung et al., 2024). 그러나 모델 구축에는 전문성이 요구되며, 입력 자료의 갱신이 번거롭고, 결과 해석에도 전문 지식이 필요하다는 한계가 보고되어 왔다. 특히 모델의 논리와 입력 자료가 강하게 결합된 경우 조건 변경이나 재사용이 어렵고, 광산별 맞춤형 모델을 구축·유지하는 데에도 적지 않은 비용이 소요된다.
광산 운반·배차는 DES의 가장 큰 응용 영역으로 함대 규모 결정, 배차 정책, 운반 동역학 등 다양한 주제가 다루어져 왔다(Dindarloo et al., 2015; Moradi Afrapoli et al., 2019). 배차 의사결정의 시점·규칙·효과를 평가하는 연구가 다수이며(Fadin et al., 2017; Smith et al., 2021; Mohtasham et al., 2022), 동적 배차의 대표적 기준 모델로 Chaowasakoo et al.(2017)이 있다. 최근에는 전동화 트럭 도입의 운영 효과(Armstrong et al., 2025)와 강화학습 기반 배차(de Carvalho and Dimitrakopoulos, 2021; Noriega et al., 2025)로 확장되고 있다. 국내에서도 지하 광산의 트럭 운반 작업을 대상으로 운반 경로 분석, 장기 운영 로그 기반 운반 시스템 분석, ICT 기반 빅데이터를 활용한 운반 작업 시뮬레이션 등이 수행되어 왔으며(Baek and Choi, 2019; Park and Choi, 2021; Park and Choi, 2024), 특히 지하 석회석 광산의 운반 시뮬레이션(Park et al., 2023)이 본 연구의 검증에서 참조 모델로 활용된다. 그러나 기존 연구는 배차 알고리즘 자체의 고도화나 운반 데이터의 수집·분석에 초점이 맞춰져 있어 현장 사용자가 모델을 쉽게 비교하고 실행할 수 있는 환경은 상대적으로 다루어지지 않았다.
한편 대규모 언어모델(large language model, LLM)은 자연어 의도를 해석하고 외부 도구를 호출하는 기능을 통해 비전문가의 분석 절차 접근성을 향상시킬 수 있는 가능성을 보여왔다(Schick et al., 2023). 실제로 화학 분야에서는 LLM에 도메인 전문 도구를 결합하여 비전문가의 복잡한 분석 수행을 지원한 사례가 보고된 바 있다(Bran et al., 2024). 본 연구에서 활용하는 모델 컨텍스트 프로토콜(Model Context Protocol, MCP)은 LLM과 외부 시스템을 표준화된 방식으로 연결하기 위한 프로토콜로, 외부 기능을 LLM이 호출할 수 있는 도구의 형태로 노출한다(Anthropic, 2026). 그러나 광산 트럭 배차 시뮬레이션에 LLM과 MCP를 결합한 사례는 보고된 바 없다.
이러한 한계는 분석 도구에 대한 접근성과 전문성 의존이라는 현장 활용 환경의 측면과, 모델과 입력 자료가 분리되어 있지 않고 광산별 맞춤형 모델의 구축에 부담이 따른다는 시뮬레이션 도구 자체의 구조적 측면 양쪽에 걸쳐 있다. 이에 본 연구의 목적은 광산 트럭 배차 DES 엔진을 MCP 서버를 통해 도구로 제공하고, LLM이 자연어 요청을 해석하여 해당 도구를 호출하는 통합 시스템을 설계 및 개발하는 것이다. 이를 통해 전문 인력이나 고가의 상용 도구에 의존하지 않고도 광산 운영 효율을 정량적으로 분석할 수 있는 환경을 제공하고자 한다. 본 연구는 광산 배차 시뮬레이션의 기능을 분석 단계별 도구로 나누어 MCP 기반 인터페이스로 제공하고, LLM이 자연어 요청을 해석해 이들 도구를 선택·호출하고 그 결과를 요약하는 절차를 정립하였다. 또한 시뮬레이션 엔진과 광산별 입력 자료를 분리하여 설정파일(configuration file)로 광산 모델을 구성하는 방식을 제안하고, 기존 연구에서 보고된 참조 모델을 재현하여 결과의 정합성을 확인하였다.
MCP 기반 광산 배차 시뮬레이션 시스템 설계
본 장에서는 광산 운반 및 배차 분석의 접근성을 높이기 위한 MCP 기반 광산 배차 시뮬레이션 시스템의 설계 구조를 제시한다. 서론에서 제기한 문제는 크게 네 가지로 요약할 수 있다. 첫째, 광산 현장에서는 코드 기반 모델링이나 고가의 상용 시뮬레이션 소프트웨어에 대한 접근성이 제한될 수 있다. 둘째, 트럭 배차와 운반 효율 분석이 작업자의 경험이나 제한된 현장 판단에 의존하는 경우가 많다. 셋째, 기존 시뮬레이션 모델은 모델 논리와 입력 자료가 강하게 결합되어 있어 조건 변경이나 재사용이 어렵다. 넷째, 광산별 맞춤형 모델 제작은 구축 비용과 유지관리 부담을 증가시킨다.
본 시스템은 이러한 문제에 대응하기 위해 광산 트럭 배차 이산사건 시뮬레이션 엔진을 MCP 서버를 통해 도구 형태로 제공하고, LLM이 자연어 요청을 해석하여 해당 도구를 호출하도록 설계되었다. 이때 LLM은 시뮬레이션의 계산 주체가 아니라, 사용자 요청을 도구 호출로 변환하고 결과를 요약하는 인터페이스 계층으로 기능한다. 즉 본 시스템의 핵심은 새로운 배차 최적화 알고리즘 자체가 아니라, 기존에 전문 도구와 분석 인력에 의존하던 시뮬레이션 기반 분석 절차를 자연어 기반 상호작용으로 접근 가능하게 만드는 데 있다.
시스템 개요 및 구성
본 시스템의 목적은 전문 인력과 고가 상용 도구에 의존하지 않고도 광산 운영 효율 분석을 수행할 수 있는 환경을 제공하는 것이다. 시뮬레이션의 능력은 유지하되 그 접근의 장벽을 낮추는 데 초점이 있다. 기존 시뮬레이션 도구는 모델 구축과 실행에 프로그래밍 또는 전문 소프트웨어의 조작을 전제하므로, 분석 역량이나 도구 접근성이 부족한 현장에서는 활용이 제한된다. 본 시스템은 시뮬레이션 기능을 표준화된 도구 형태로 제공하고 LLM이 그 호출을 담당하게 함으로써, 사용자가 자연어 요청만으로 분석을 수행할 수 있도록 한다.
본 시스템은 다섯 계층으로 구성된다(Fig. 1). 사용자, LLM, MCP 서버, 시뮬레이션 엔진, 그리고 입력과 출력에 해당하는 설정파일 및 시뮬레이션 결과 출력부이다. 사용자는 자연어로 분석을 요청하고, LLM은 그 의도를 해석하여 MCP 서버가 제공하는 적절한 도구를 호출한다. MCP 서버는 호출을 시뮬레이션 엔진에 전달하며, 엔진은 설정파일로 정의된 광산 모델에 대해 이산사건 시뮬레이션을 수행한 뒤 결과를 산출한다. 산출된 결과는 다시 LLM을 거쳐 사용자가 이해할 수 있는 형태로 요약 및 제시된다.
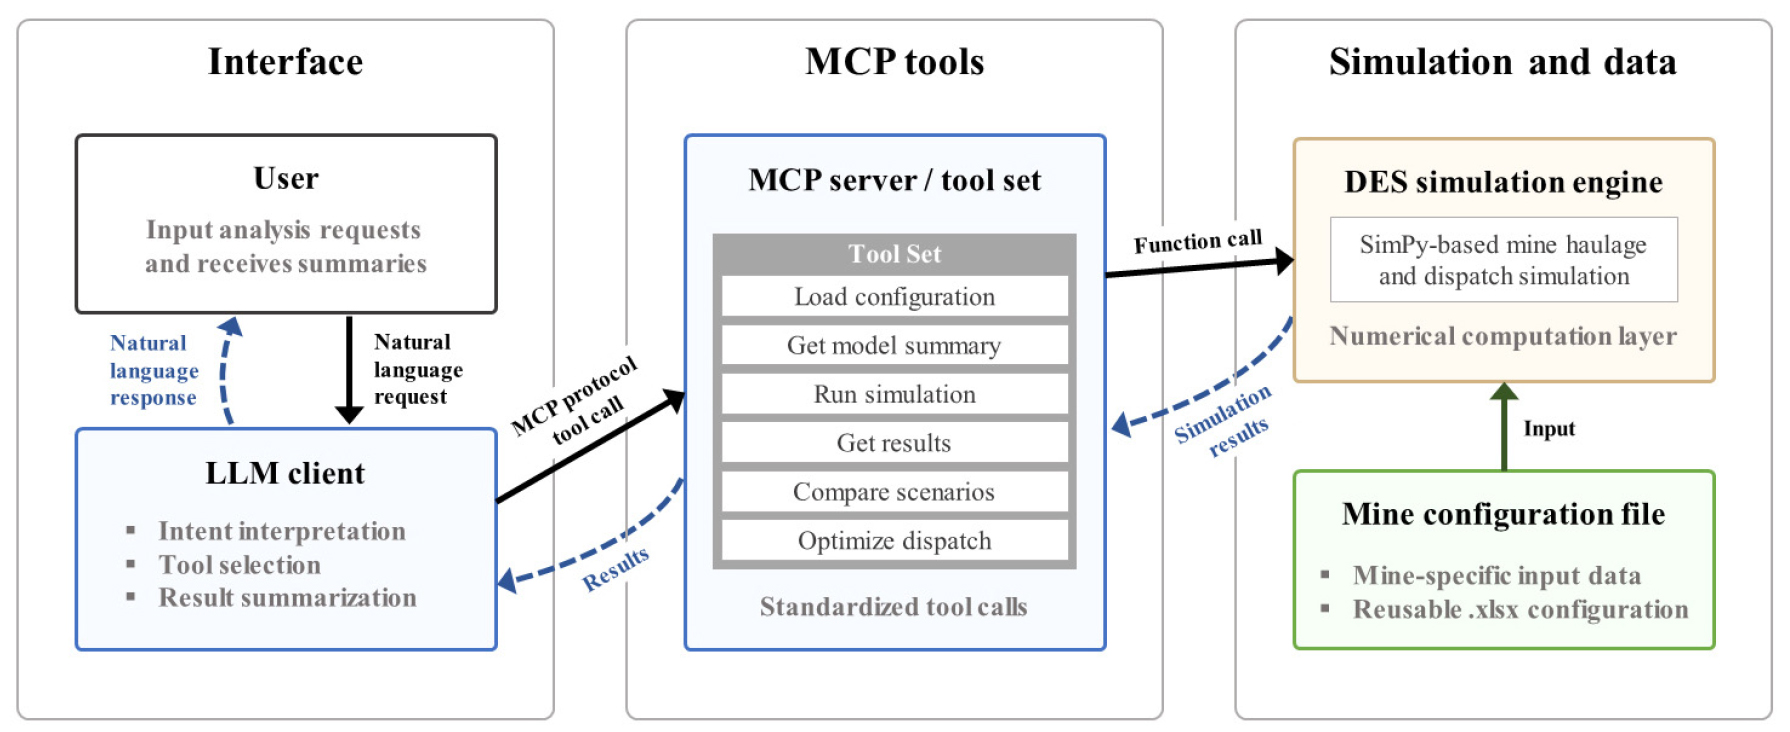
이 구성의 핵심 설계 원칙은 역할의 분리이다. 시뮬레이션의 수치 계산은 전적으로 시뮬레이션 엔진이 담당하며, LLM은 계산에 관여하지 않는다. LLM의 역할은 자연어 의도의 해석, 적절한 도구의 선택과 호출, 결과의 요약 및 설명에 한정된다. 즉 LLM은 시뮬레이션의 계산 주체나 배차의 의사결정 주체가 아니라, 시뮬레이션을 조작하고 그 결과를 해석하는 인터페이스 계층으로 기능한다.
본 시스템의 적용 대상은 광산의 운반 및 배차 시뮬레이션이다. 시뮬레이션 엔진은 트럭과 쇼벨로 구성되는 운반 시스템을 모델링한다. 트럭의 운반 주기는 쇼벨에서의 적재, 덤핑 구역(크러셔 혹은 야적장)으로의 실차 이동, 하역, 적재 구역으로의 공차 이동으로 구성된다. 본 시스템은 설정파일의 표현 범위 안에서 노천 및 지하 광산 모두에 적용될 수 있다.
MCP 기반 시뮬레이션 도구 설계
MCP는 에이전트 AI(agentic AI)의 핵심 구성 요소인 도구 사용(tool use) 기능을 표준화하는 프로토콜로서, LLM이 광산 트럭 배차 DES 엔진을 도구로 호출하고 활용할 수 있도록 지원한다. 본 시스템은 시뮬레이션 엔진의 기능을 하나의 통합 명령으로 묶지 않고, 분석 워크플로의 각 단계에 대응하는 여섯 개의 MCP 도구로 분해하여 정의한다. 각 도구는 명확히 명명되고 매개변수가 정의된 하나의 조작 단위이다.
각 도구는 기능에 따라 상태 설정, 상태 조회, 시뮬레이션 실행, 결과 조회, 반복 실험 및 조건 탐색의 역할로 구분된다(Table 1). 설정파일 로드 도구는 광산 모델을 불러오고 세션 상태를 초기화한다. 모델 요약 조회 도구는 로드된 광산 모델의 주요 구성 요소를 반환한다. 시뮬레이션 실행 도구는 지정된 조건에 따라 단일 시뮬레이션을 수행한다. 결과 조회 도구는 가장 최근 실행 결과의 주요 결과값을 반환한다. 시나리오 비교 도구는 트럭 수, 장비 배치, 운반 조건 등 특정 입력 조건을 변화시키며 결과를 비교한다. 배차 조건 탐색 도구는 쇼벨 배치, 배차 방식, 트럭 수, 전략의 조합을 탐색하여 최적의 운영 플랜을 찾는다.
Table 1.
MCP tool configuration of proposed system
도구 간에는 실행 순서의 의존성이 있으며, MCP 서버는 이를 세션 상태로 관리한다. 설정파일 로드는 다른 모든 도구의 선행 조건으로, 모델이 로드되지 않은 상태에서 시뮬레이션 실행이나 조회가 호출되면 서버는 명시적 오류를 반환한다. 결과 조회는 가장 최근에 수행된 시뮬레이션의 결과를 참조한다. 이러한 상태 관리는 도구가 잘못된 순서로 호출되더라도 시스템이 일관된 상태를 유지하게 한다.
이 구조에서 LLM의 역할은 사용자가 요청하는 자연어의 의도를 해석하고, 그에 맞는 도구를 선택하여 매개변수와 함께 호출하며, 반환된 결과를 요약 및 비교하는 것이다. 본 시스템은 시뮬레이션 기능을 자유로운 코드 형태가 아니라 한정된 도구 집합으로 제공한다. 이러한 설계로 인해 LLM의 작업은 코드 생성이 아니라 정의된 도구 중 적절한 하나를 선택해 호출하는 것으로 단순화된다. 또한 여섯 도구는 모델 구성, 실행, 결과 확인, 조건 변경과 비교에 이르는 DES 분석의 일반적 절차를 그대로 반영하고 있다.
설정파일 기반 광산 모델 구성
기존의 광산 시뮬레이션은 모델의 논리와 특정 광산의 입력 자료가 코드 수준에서 결합되어 있는 경우가 많아, 대상 광산이 바뀌거나 입력 자료가 갱신될 때마다 코드를 직접 수정해야 한다. 본 시스템은 시뮬레이션 엔진과 광산별 입력 자료를 분리하고, 입력 자료를 설정파일이라는 별도의 구조화된 파일을 통해 입력받는다. 엔진은 특정 광산에 종속되지 않으며, 대상 광산은 설정파일로 기술된다. 설정파일은 광산 모델을 구성하는 데 필요한 요소가 여섯 개의 기능 범주로 구성된다(Table 2). 광산 기본 정보, 장비 정보, 트럭 정보, 구역 간 이동 시간, 운영 설정, 그리고 발파 구역(blast zone) 정보가 이에 해당한다.
Table 2.
Components of configuration file
본 시스템은 광산 공간을 적재 구역(loading zone, LZ)과 덤핑 구역(dumping zone, DZ)의 두 종류로 구분하여 표현한다. 쇼벨은 적재 구역에 속하고, 크러셔와 야적장은 덤핑 구역에 속한다. 한 적재 구역에는 여러 쇼벨이 함께 배치될 수 있으며, 각 적재 구역의 하위 단위로 여러 발파 구역이 정의되어 광종, 품위, 잔량을 가진다. 이동 시간은 적재 구역과 덤핑 구역 쌍에 대해 한 번 정의되며, 같은 구역에 속한 장비들이 이를 공유한다. 이러한 구역 단위 표현은 장비 쌍마다 이동 시간을 반복 기술할 필요를 줄이고, 설정파일의 표현을 간결하게 유지한다.
이 구조의 장점은 세 가지이다. 첫째, 코드 수정 없이 설정파일의 편집만으로 광산의 조건을 변경할 수 있다. 둘째, 서로 다른 광산 모델을 동일한 엔진으로 구성 및 재사용할 수 있다. 셋째, 입력 자료의 갱신을 파일 교체만으로 처리할 수 있다. 다만 이 범용성은 설정파일 스키마가 표현할 수 있는 범위로 한정된다. 스키마가 전제하지 않는 구조를 모델링하려면 엔진 자체의 확장이 필요하다. 즉 본 시스템은 스키마가 표현하는 범위 안에서 코드 수정 없이 다양한 광산을 다룰 수 있다.
엔진 구현 및 배차 의사결정 구조
시뮬레이션 엔진은 운반 시스템을 이산사건 시뮬레이션으로 모델링한다. 트럭의 운반 주기는 적재 대기, 적재, 실차 이동, 하역, 공차 이동 등의 사건(event)으로 구성된다. 엔진의 구현에는 Python의 SimPy 라이브러리(SimPy, 2026)를 이용하였다. SimPy는 프로세스 기반의 이산사건 시뮬레이션 라이브러리로, 능동적으로 행동하는 개체를 프로세스로, 여러 개체가 공유 및 경합하는 설비를 용량을 가진 자원으로 표현한다. 본 엔진에서 각 트럭은 앞서 기술한 운반 주기를 반복 수행하는 프로세스로 모델링되며, 쇼벨·크러셔·야적장은 처리 용량 제약을 갖는 자원으로 모델링된다. 시뮬레이션 시계의 진행과 사건의 스케줄링은 SimPy가 담당한다. 적재, 운반, 하역 등 작업 시간에는 확률적 변동을 부여하며, 시뮬레이션을 다수 반복(replication) 실행하여 결과의 통계적 변동을 확보한다.
운반 주기는 자원의 제약 하에 진행된다. 쇼벨은 동시에 처리할 수 있는 트럭 수의 제약을 가지며, 트럭별 적재 시간은 설정파일에 지정된다. 크러셔는 동시 하역 가능 대수와 함께 호퍼 용량, 처리율의 제약을 가지며, 야적장은 동시 하역 가능 대수의 제약을 가진다. 트럭은 적재량의 제약을 가지며, 용량이 다른 이종(heterogeneous) 트럭이 함께 운용될 수 있다. 운반 경로는 구간별 이동 시간으로 표현된다. 적재·하역·이동시간은 정규분포로 샘플링되며, 음수 또는 비현실적인 값을 방지하기 위해 하한값(0.1분)으로 절단(clamping)한다. 이러한 제약으로 인해 트럭은 쇼벨이나 하역지점에서 대기가 발생할 수 있으며, 대기와 병목의 양상이 시뮬레이션의 주요 분석 대상이 된다.
시뮬레이션 엔진은 운반 주기뿐 아니라 광산 상태의 변화도 함께 추적한다. 각 발파 구역은 잔여량과 품위 정보를 가지며, 트럭의 적재량은 구역 잔여량에 따라 동적으로 결정된다. 만약 잔여량이 트럭 적재 용량보다 적은 경우 부분 적재가 발생하며, 구역의 잔여량이 소진되면 해당 쇼벨은 대기 중인 다음 구역으로 자동 재배치된다. 또한 크러셔의 호퍼가 포화 상태에 도달하면 트럭은 야적장으로 자동 재지시된다. 이러한 메커니즘은 본 엔진이 광산 운영의 동적 변화까지 일부 반영하도록 설계되었음을 의미한다.
배차 의사결정은 배차 방식과 전략의 두 개 축으로 구성된다(Table 3). 먼저 배차 방식은 트럭을 목적지에 배정하는 의사결정의 시점을 규정한다. 실시간(realtime) 방식은 운행 중 배정에 필요한 시점마다 동적으로 결정하고, 고정(fixed) 방식은 트럭별 쇼벨을 사전에 배정하며, 혼합(hybrid) 방식은 둘을 결합한 방식이다. 고정 방식과 혼합 방식에서 트럭별 쇼벨 배정은 본 시스템의 최적화 도구가 자동으로 생성하게 된다. 배차 전략은 트럭을 어느 작업장에 배정할지를 결정하는 규칙으로, 대기열 최소화, 최단거리, 균등 배분, 사전 정의된 우선순위, 품위 제어의 다섯 가지를 제공한다.
Table 3.
Two axes of dispatch decision-making
시뮬레이션의 산출 결과값은 생산량, 운반 횟수, 트럭 대기시간, 장비 이용률(utilization), 트럭 생산성, 목표 생산량 달성 여부 등이며, 광산 상태의 변화로서 부분 적재 횟수, 구역 재배치 이력, 운반된 광석의 가중평균 품위 등도 함께 산출된다. 이들 결과값은 배차 방식과 전략의 조합이 운반 시스템의 동작에 미치는 영향을 정량적으로 비교하는 근거가 된다.
자연어 기반 시뮬레이션 분석 절차
사용자는 시뮬레이션 분석을 자연어 요청으로 수행한다. 대표적인 요청 유형은 네 가지로 구분할 수 있다. 첫째, 현재 로드된 광산 모델의 장비, 작업장, 경로, 생산 조건을 확인하는 모델 조회 요청이다. 둘째, 기본 조건 또는 사용자가 지정한 조건에 따라 단일 시뮬레이션을 실행하는 요청이다. 셋째, 트럭 수, 장비 배정, 배차 방식 등 입력 조건을 변화시키며 여러 시나리오를 비교하는 요청이다. 넷째, 배차 전략별 결과 차이를 비교하고 주요 결과값을 해석하는 요청이다.
자연어 요청은 다음 절차에 따라 처리된다(Fig. 2). 사용자가 분석 요청을 입력하면 LLM은 요청의 의도를 해석하고 필요한 MCP 도구를 선택한다. 모델이 로드되어 있지 않은 경우에는 설정파일 로드 도구가 먼저 호출되며, 이후 모델 요약 조회, 시뮬레이션 실행, 결과 조회 또는 시나리오 비교 도구가 요청 목적에 따라 순차적으로 호출된다. MCP 서버는 각 호출을 시뮬레이션 엔진에 전달하고, 엔진은 설정파일과 호출 매개변수를 바탕으로 시뮬레이션을 수행한다. 반환된 결과는 LLM을 통해 자연어 설명, 비교 요약, 표 형식 결과 등 사용자가 이해하기 쉬운 형태로 제시된다. Fig. 2의 숫자는 자연어 기반 시뮬레이션 분석 절차의 주요 단계를 나타낸다.
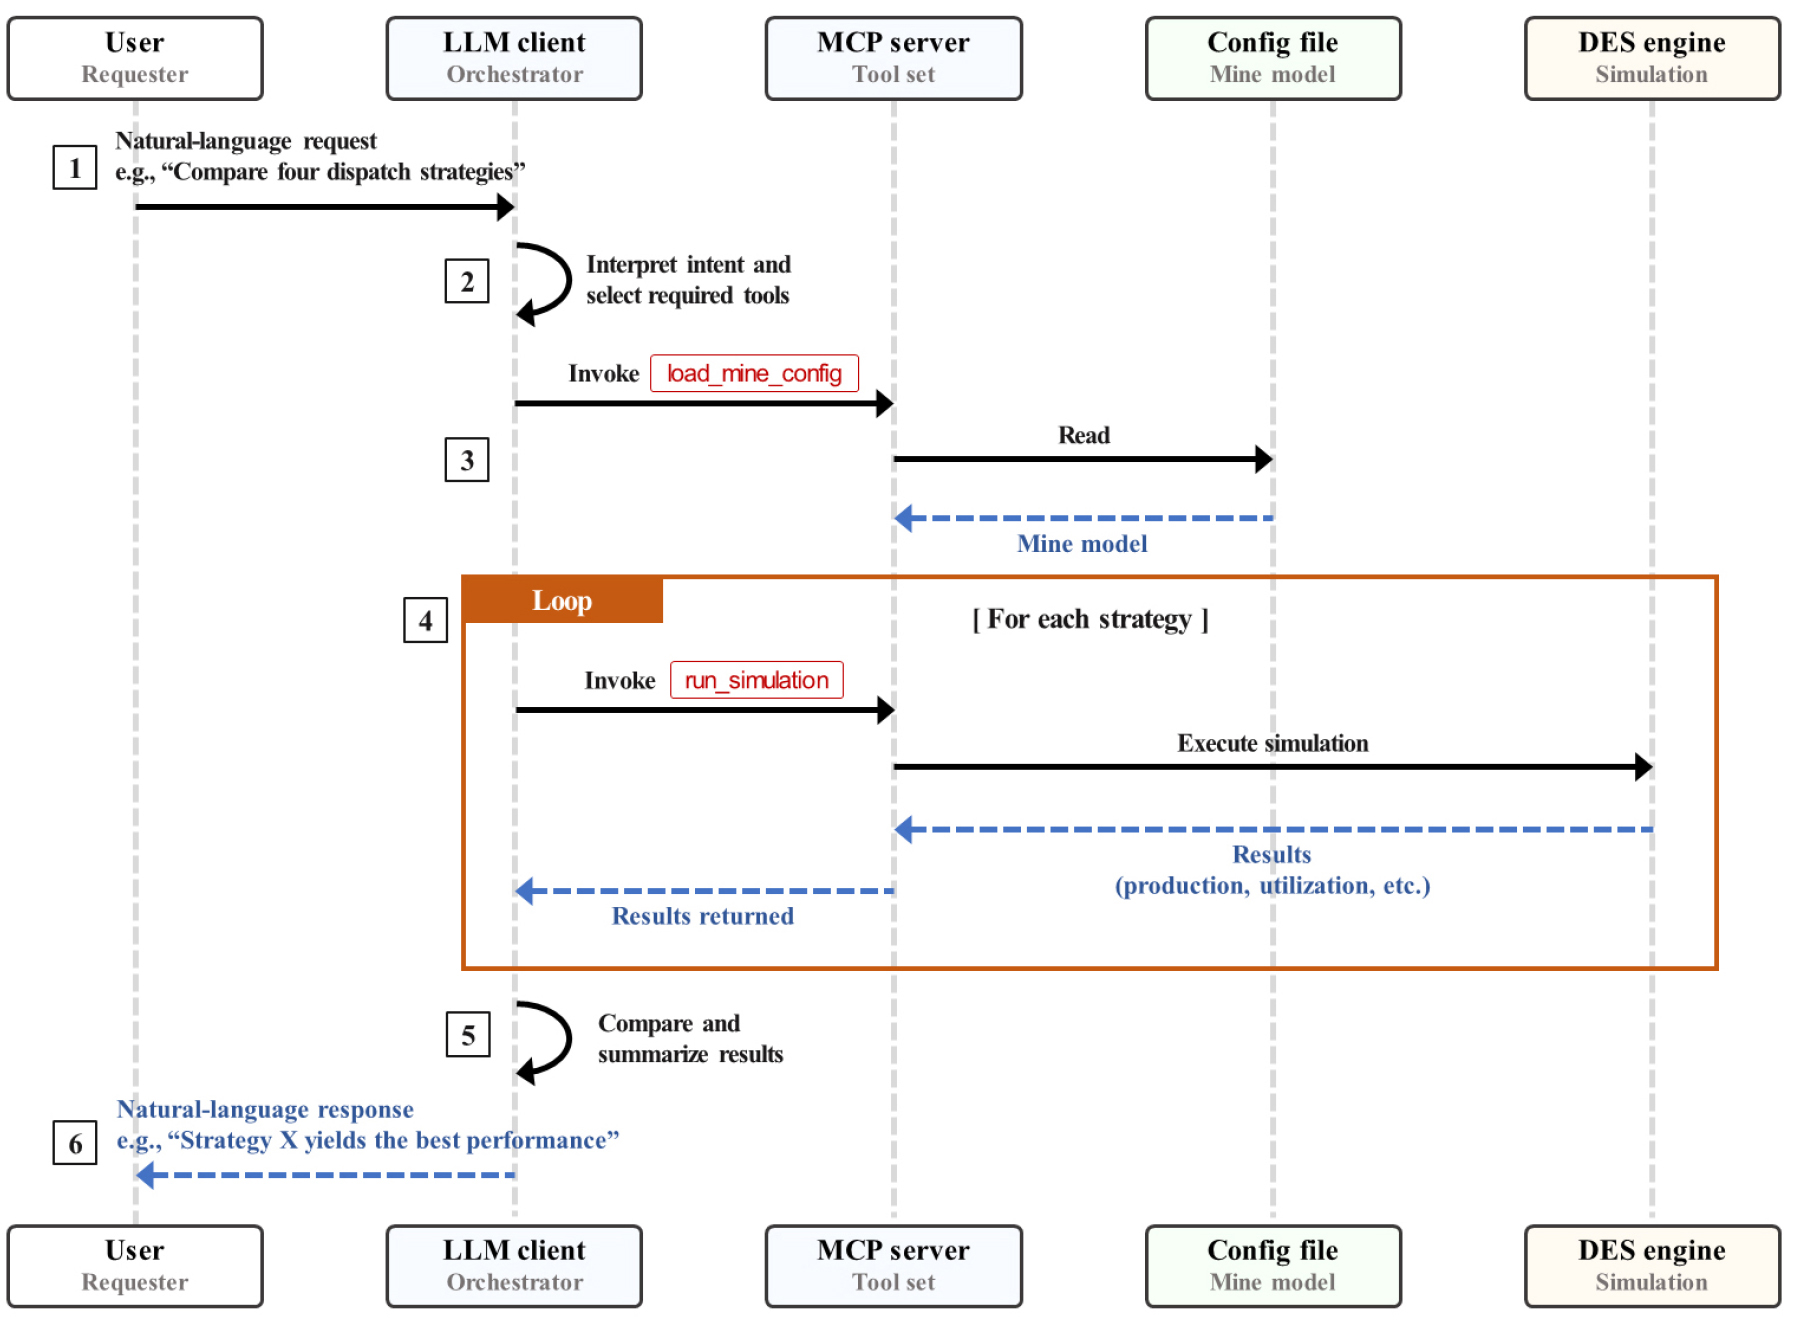
비교 분석의 경우 하나의 자연어 요청은 복수의 도구 호출과 반복 실행으로 확장될 수 있다. 예를 들어 “트럭 수를 3대부터 6대까지 증가시키면서 생산량과 장비 이용률을 비교해 줘”라는 요청은 트럭 수 조건을 변화시킨 여러 번의 시뮬레이션 실행과 결과 비교 절차로 변환된다. 이 과정에서 사용자는 개별 실행 명령이나 코드 작성 없이 분석 조건을 지정할 수 있으며, LLM은 반복 실행 결과를 요약하여 결과 차이를 설명한다. 다만 LLM이 제공하는 결과 요약과 해석은 시뮬레이션 엔진이 반환한 수치에 근거하며, 결과의 정확성은 엔진의 구현과 설정파일의 모델링 가정에 의존한다.
MCP 기반 시뮬레이션 시스템 구현 및 검증
본 장에서는 앞서 제시한 설계의 구현과 검증 결과에 대해 제시한다. 구현된 시스템의 동작은 가상 광산 데이터셋을 이용한 시연으로 확인하며, 수치 결과의 정확성은 기존 광산 시뮬레이션 연구에서 보고된 참조 모델 사례를 본 시스템에서 재현하고 그 결과를 원본 출력값과 비교함으로써 평가한다. 본 논문에서 엔진의 수치 정확성에 대한 검증 범위는 참조 모델이 다룬 고정 배차 사례의 재현에 한정된다.
시스템 구현 결과
본 시스템은 Python 3.10 이상에서 동작하도록 구현하였다. 핵심 라이브러리는 이산사건 시뮬레이션 라이브러리 SimPy 4.1.1, MCP Python SDK 1.0, 그리고 설정파일 파싱을 위한 openpyxl 3.1과 Pandas 2.0이다. MCP 서버는 stdio 통신을 사용하며, LLM 클라이언트(본 연구에서는 Anthropic의 Claude Desktop(모델: Opus 4.8), 별도의 커스텀 시스템 프롬프트 없이 MCP 도구 정의만으로 연동)는 표준 MCP 클라이언트 사양에 따라 본 서버에 연결된다.
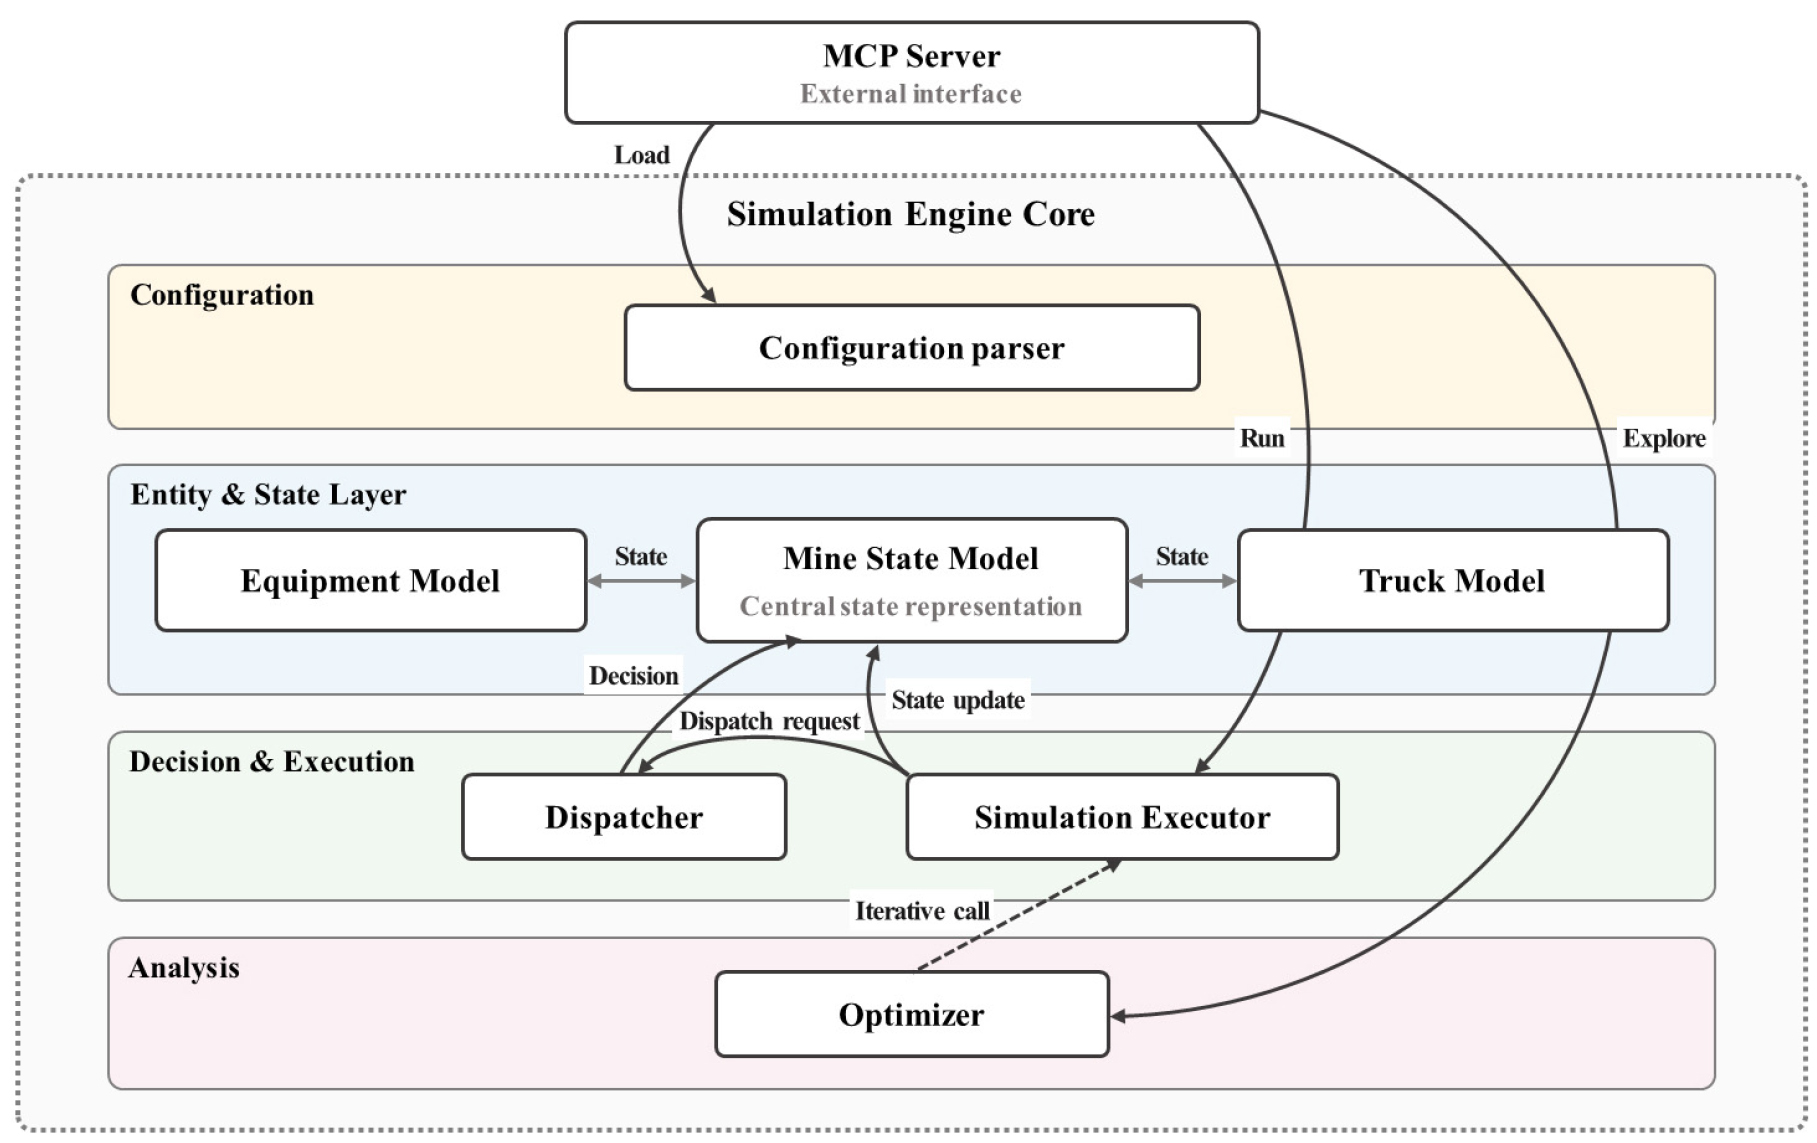
시스템은 시뮬레이션 엔진 패키지와 MCP 서버 모듈로 구성된다(Fig. 3). 엔진 패키지는 설정파일 파서, 장비 모델, 트럭 모델, 광산 상태 모델, 배차 의사결정, 시뮬레이션 진행, 최적화의 일곱 개 하위 모듈로 이루어진다. MCP 서버 모듈은 엔진의 기능을 앞서 정의한 여섯 개의 MCP 도구로 제공한다.
본 시스템의 구현 결과를 확인하기 위해 가상 광산 데이터셋을 구성하였다(Table 4). 본 데이터셋은 두 개의 적재 구역(LZ-A, LZ-B), 두 종류의 덤핑 구역(크러셔를 포함한 DZ-1과 야적장을 포함한 DZ-2), 광석과 폐석을 포함한 네 개의 발파 구역, 그리고 적재량이 서로 다른 이종 트럭 6대(25톤 4대, 45톤 2대)로 구성되어 본 시스템의 주요 입력 구조를 포함하도록 설계되었다. 시뮬레이션 시간은 1교대(480분), 반복 횟수는 10회로 설정하였다.
Table 4.
Configuration of Hypothetical Copper Mine dataset used in current demonstration
본 시스템의 자연어 분석 인터페이스를 시연하기 위해, 먼저 네 개의 배차 전략(균등 배분, 대기열 최소화, 최단거리, 품위제어)의 시뮬레이션을 LLM이 전략별로 실행하여 각각의 결과를 얻었다(Table 5). 이어서 이 네 결과를 종합 비교 검토하는 자연어 요청을 LLM에 입력하였고, LLM은 비교 결과를 표와 그래프로 정리하여 응답하였다(Fig. 4). 네 전략 모두 목표 생산량 3,000톤을 초과 달성하였다. 트럭별 운반량은 적재량에 비례하여 나타나 이종 트럭 운용이 정상적으로 동작함을 보였으며, 트럭 이용률은 92.4~ 96.2% 수준으로 본 설정에서는 트럭이 시스템의 병목임을 확인하였다. 한편 두 쇼벨의 이용률 분포는 전략에 따라 뚜렷한 차이를 보였으며, 이는 동일한 광산 설정에서도 배차 전략의 선택이 시스템의 동작 양상에 영향을 미친다는 것을 보여준다. 크러셔 호퍼의 포화, 발파 구역 재배치, 부분 적재는 본 시나리오의 잔여량 및 운반량 규모에서 발생하지는 않았다.
Table 5.
Simulation results across four dispatch strategies (mean of 10 replications, 480-min shift, 6 trucks)
| Dispatch strategy | Production (t) |
Achievement (%) |
Cycle (min) |
Mix grade (% Cu) |
Truck util. (%) |
S1 util. (%) |
S2 util. (%) |
| Balanced | 3,137.0 ± 23.7 | 104.6 ± 0.8 | 25.2 ± 0.29 | 1.05 ± 0.002 | 92.5 ± 0.7 | 37.5 ± 0.9 | 36.2 ± 1.0 |
| Minimum queue | 3,136.0 ± 31.9 | 104.6 ± 1.1 | 24.3 ± 0.19 | 1.06 ± 0.006 | 96.2 ± 0.5 | 42.5 ± 1.3 | 34.2 ± 1.8 |
| Nearest | 3,135.0 ± 15.8 | 104.5 ± 0.6 | 24.2 ± 0.11 | 0.92 ± 0.000 | 92.4 ± 0.8 | 4.7 ± 0.1 | 72.1 ± 0.5 |
| Grade control* | 3,101.5 ± 37.6 | 103.4 ± 1.3 | 25.8 ± 0.27 | 1.16 ± 0.008 | 92.9 ± 1.1 | 62.2 ± 2.0 | 10.0 ± 1.8 |
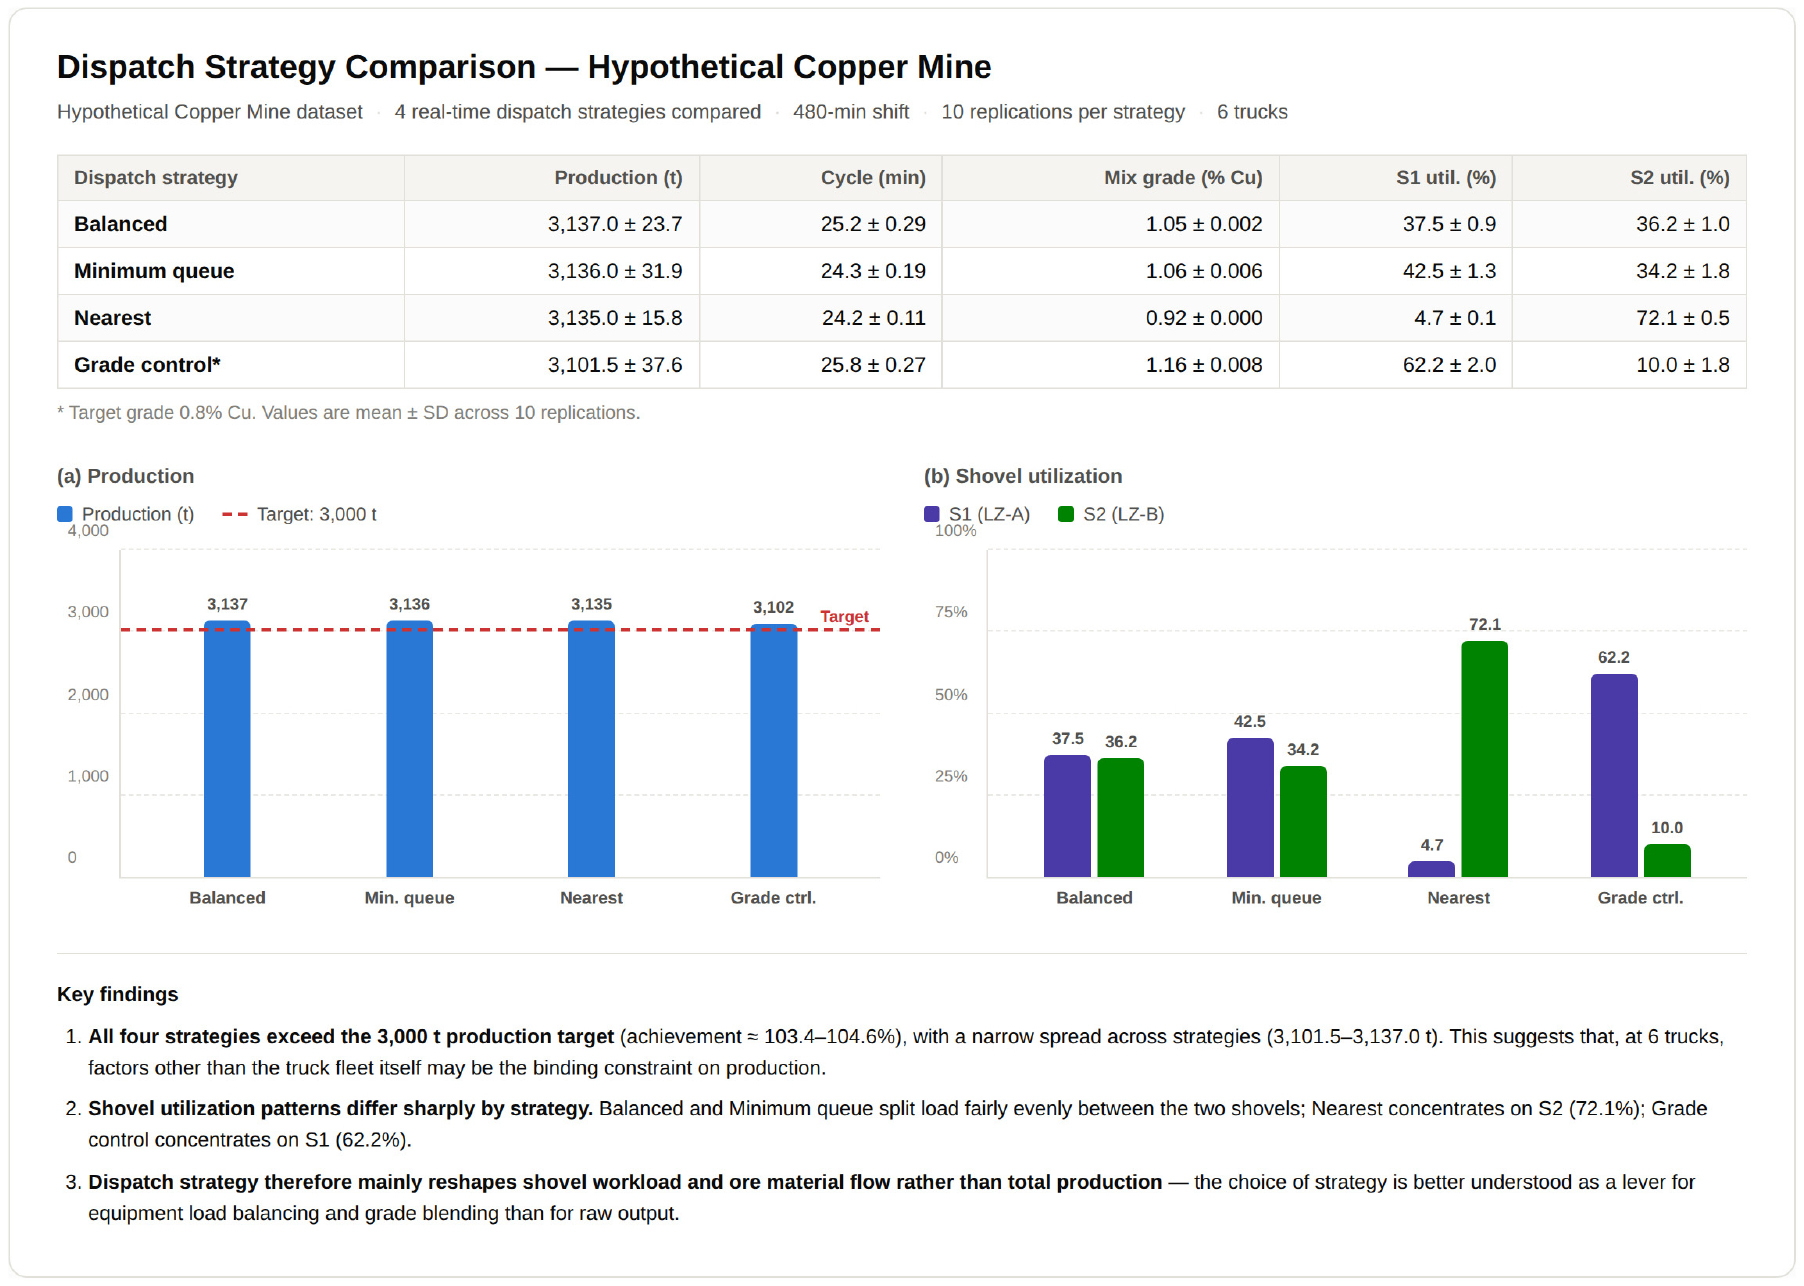
균등 배분, 대기열 최소화, 최단거리 전략의 생산량 차이는 약 1~2톤 수준으로 각 결과의 표준편차보다 작아, 생산량만으로 전략 간 우열을 판단하기는 어렵다. 반면 쇼벨 이용률(S1/S2), 사이클 시간, 혼합 품위에서는 전략별로 뚜렷한 차이가 나타나는데, 이는 각 전략이 생산량은 유사하게 유지하면서도 서로 다른 운영 양상‒쇼벨 부하 분산, 대기시간, 품위 관리‒을 유도함을 보여준다.
자연어 분석의 확장 적용
목표 생산량 달성을 위한 최소 트럭 대수 및 추가 투입 효과의 분석은 광산 운영에서 빈번한 의사결정 과제이다. 본 절에서는 본 시스템의 자연어 분석 인터페이스를 이용하여 트럭 수 변화에 따른 생산성 변화를 분석한 사례를 제시한다.
앞 절에서 사용한 Hypothetical Copper Mine 데이터셋에 대해, 배차 전략은 균등 배분으로 고정한 채 트럭 수를 4대에서 12대까지 2대 간격으로(기본 편성을 초과하는 증차분은 45톤급으로 구성) 변화시키며 생산성을 비교 분석하는 자연어 요청을 LLM에 입력하였다. 시뮬레이션 시간(1교대 480분)과 반복 횟수(10회)는 동일하게 유지하였다. LLM은 시뮬레이션 실행 도구를 트럭 수 별로 다섯 차례 호출하여 각 시나리오의 결과를 얻고, 그 결과를 종합 비교한 응답을 표와 그래프로 정리하였다(Table 6, Fig. 5).
Table 6.
Effect of truck count on system performance (Hypothetical Copper Mine, balanced strategy, 480-min shift, mean of 10 replications)
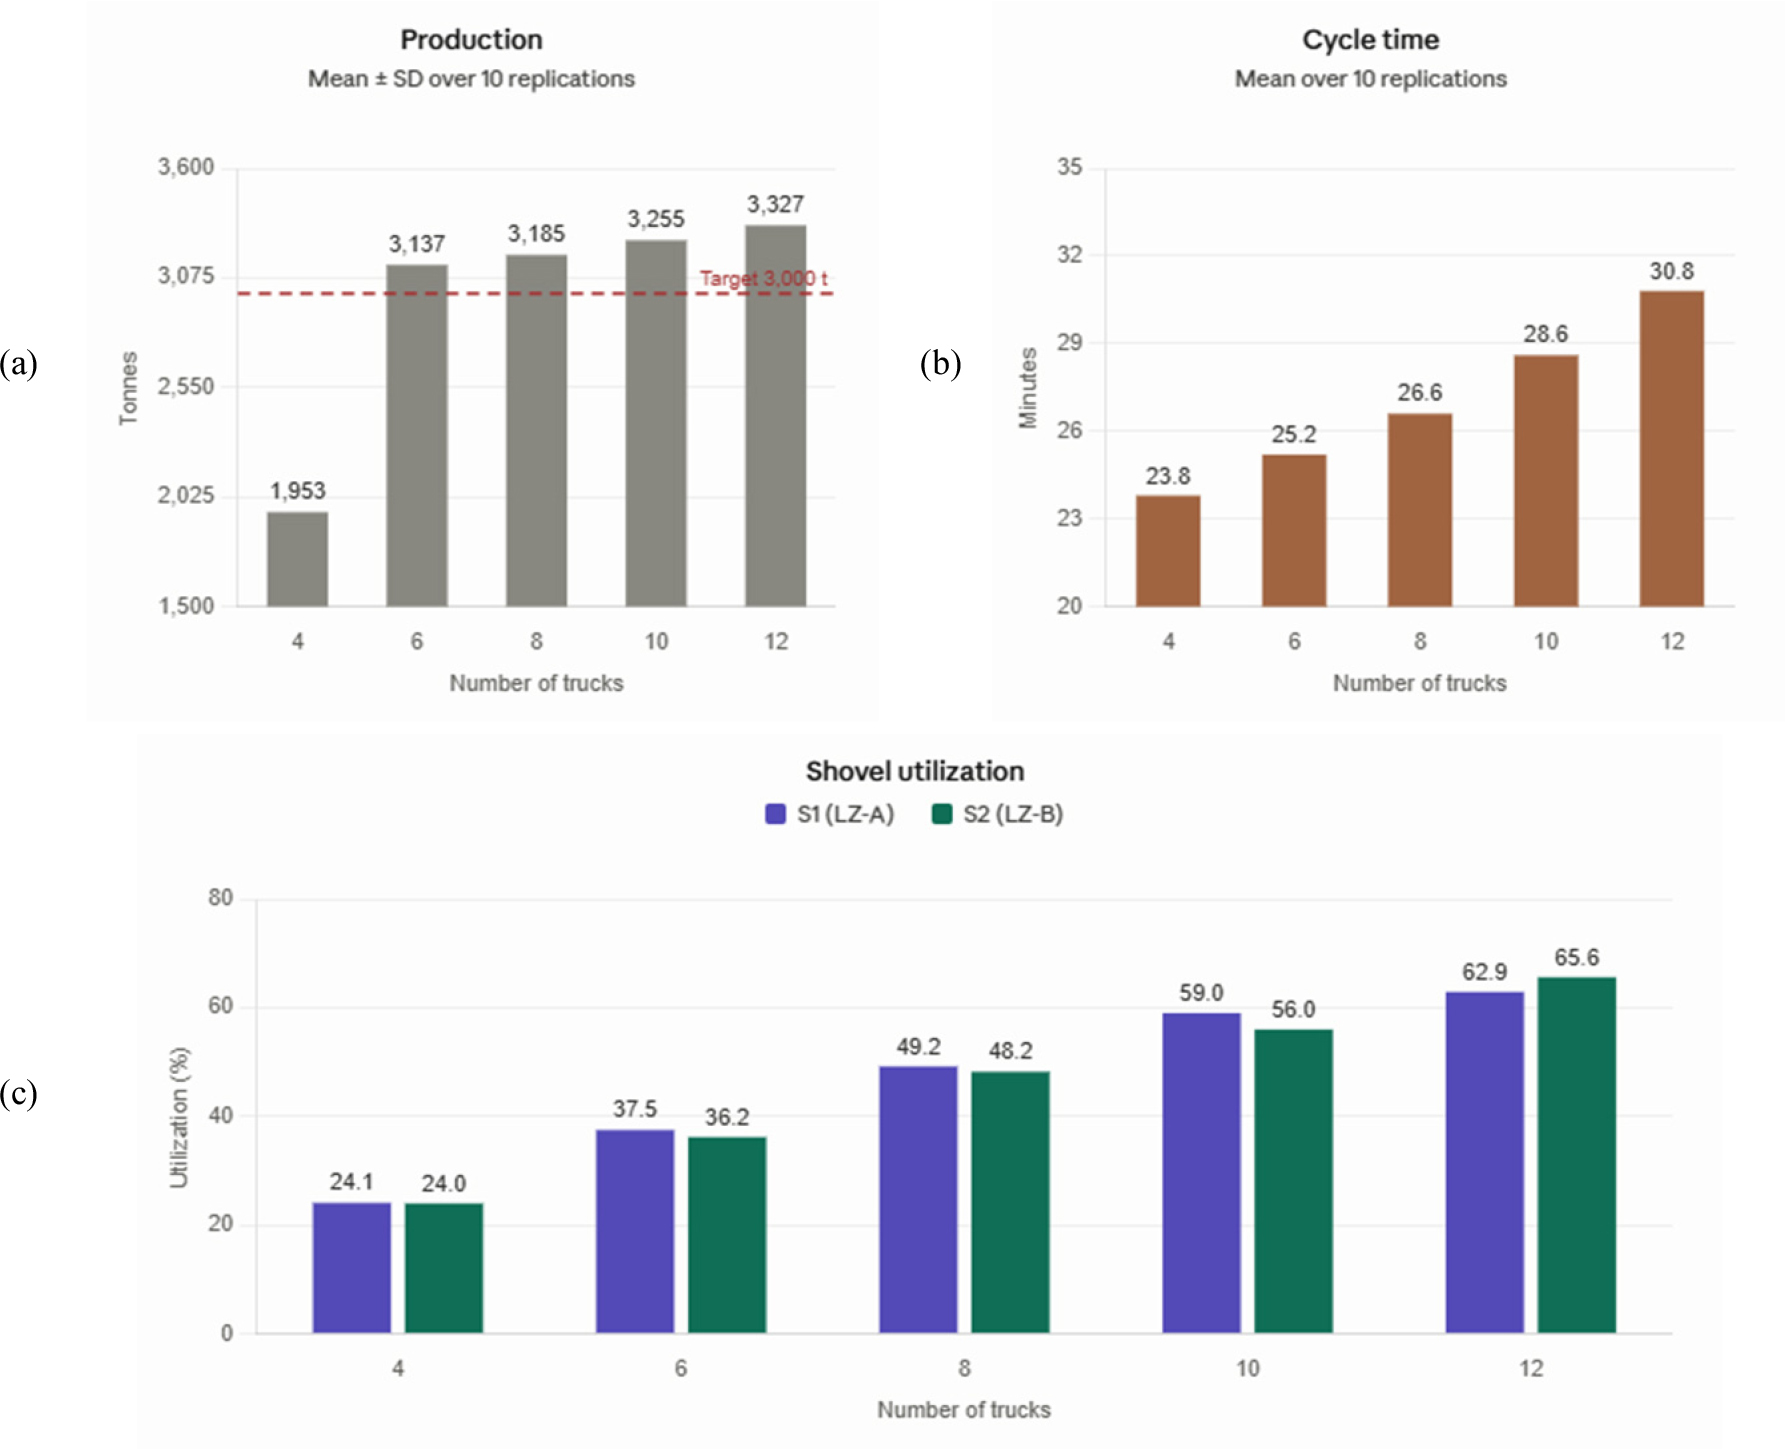
결과에서 트럭 4대 운용 시 생산량은 1,952.5톤으로 목표 3,000톤의 65.1%에 그쳤으나, 6대부터는 목표를 초과 달성하였다. 6대를 넘어선 트럭 수 증가는 생산량을 점진적으로 상승시켰지만, 그 증가폭은 점차 둔화되어 6대에서 12대 사이의 생산량 증가는 약 6%에 그쳤다. 한편 쇼벨 이용률은 트럭 수에 비례하여 단조롭게 상승(약 24% → 63~66%)하였으며, 평균 사이클 타임 또한 23.8분에서 30.8분으로 약 7분 늘어났다. 이는 트럭 수가 증가함에 따라 쇼벨 앞 대기열이 길어져 개별 트럭의 사이클 지연이 누적된 결과로 해석된다. 다만 6대는 본 조건에서 목표 생산량을 달성하는 최소 대수이나, 장비비·운영비·연료 또는 에너지 소비는 고려되지 않았으므로 이를 경제적 의미의 최적 대수로 해석하기는 어렵다.
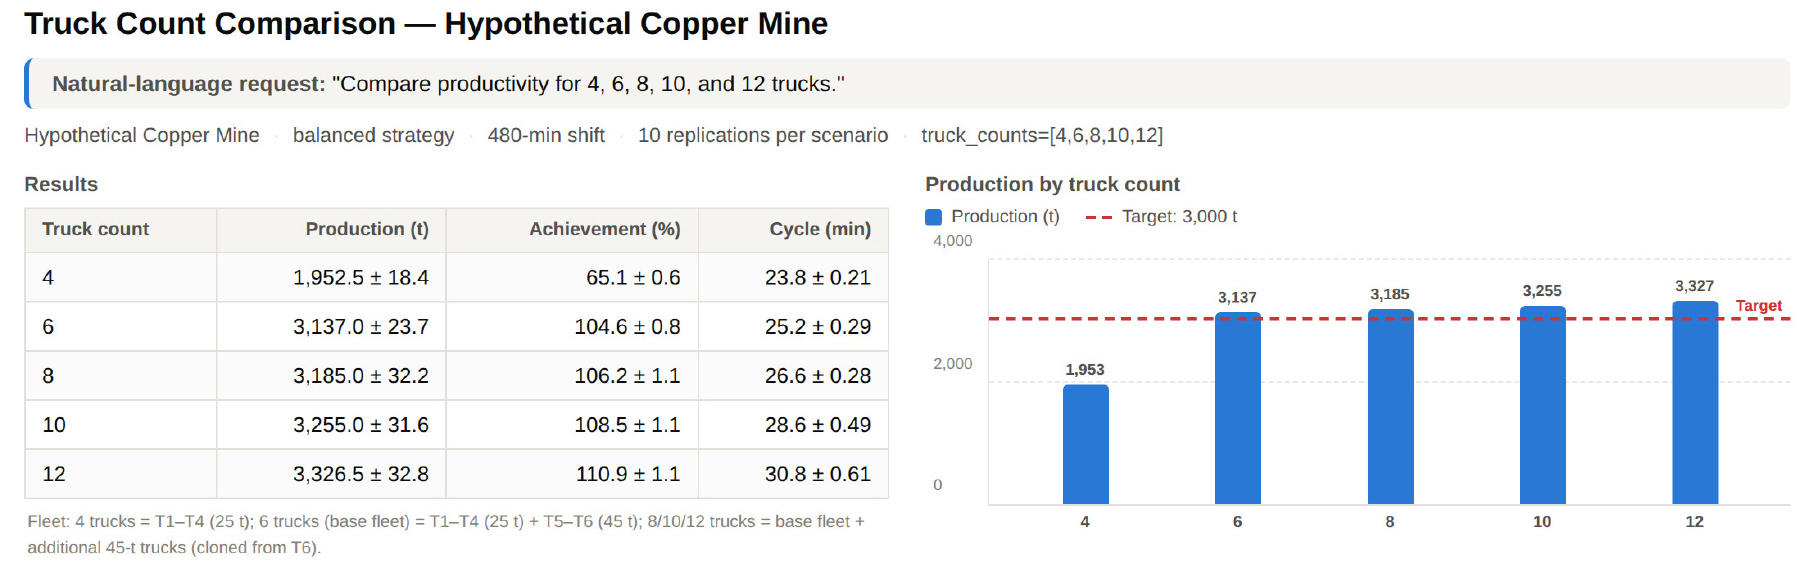
본 시연에서 목표 생산량 달성을 위한 최소 대수 및 추가 투입 효과 분석에 필요한 정량적 기초 데이터를 자연어 요청 한번으로 산출하였다. 이는 본 시스템이 광산 운영의 변수 변화 분석에 활용될 수 있음을 보여준다. 위와 같은 트럭 수 비교는 Compare scenarios 도구를 이용하면 개별 시뮬레이션 실행 호출 없이 단일 호출로 수행할 수 있다(Fig. 6).
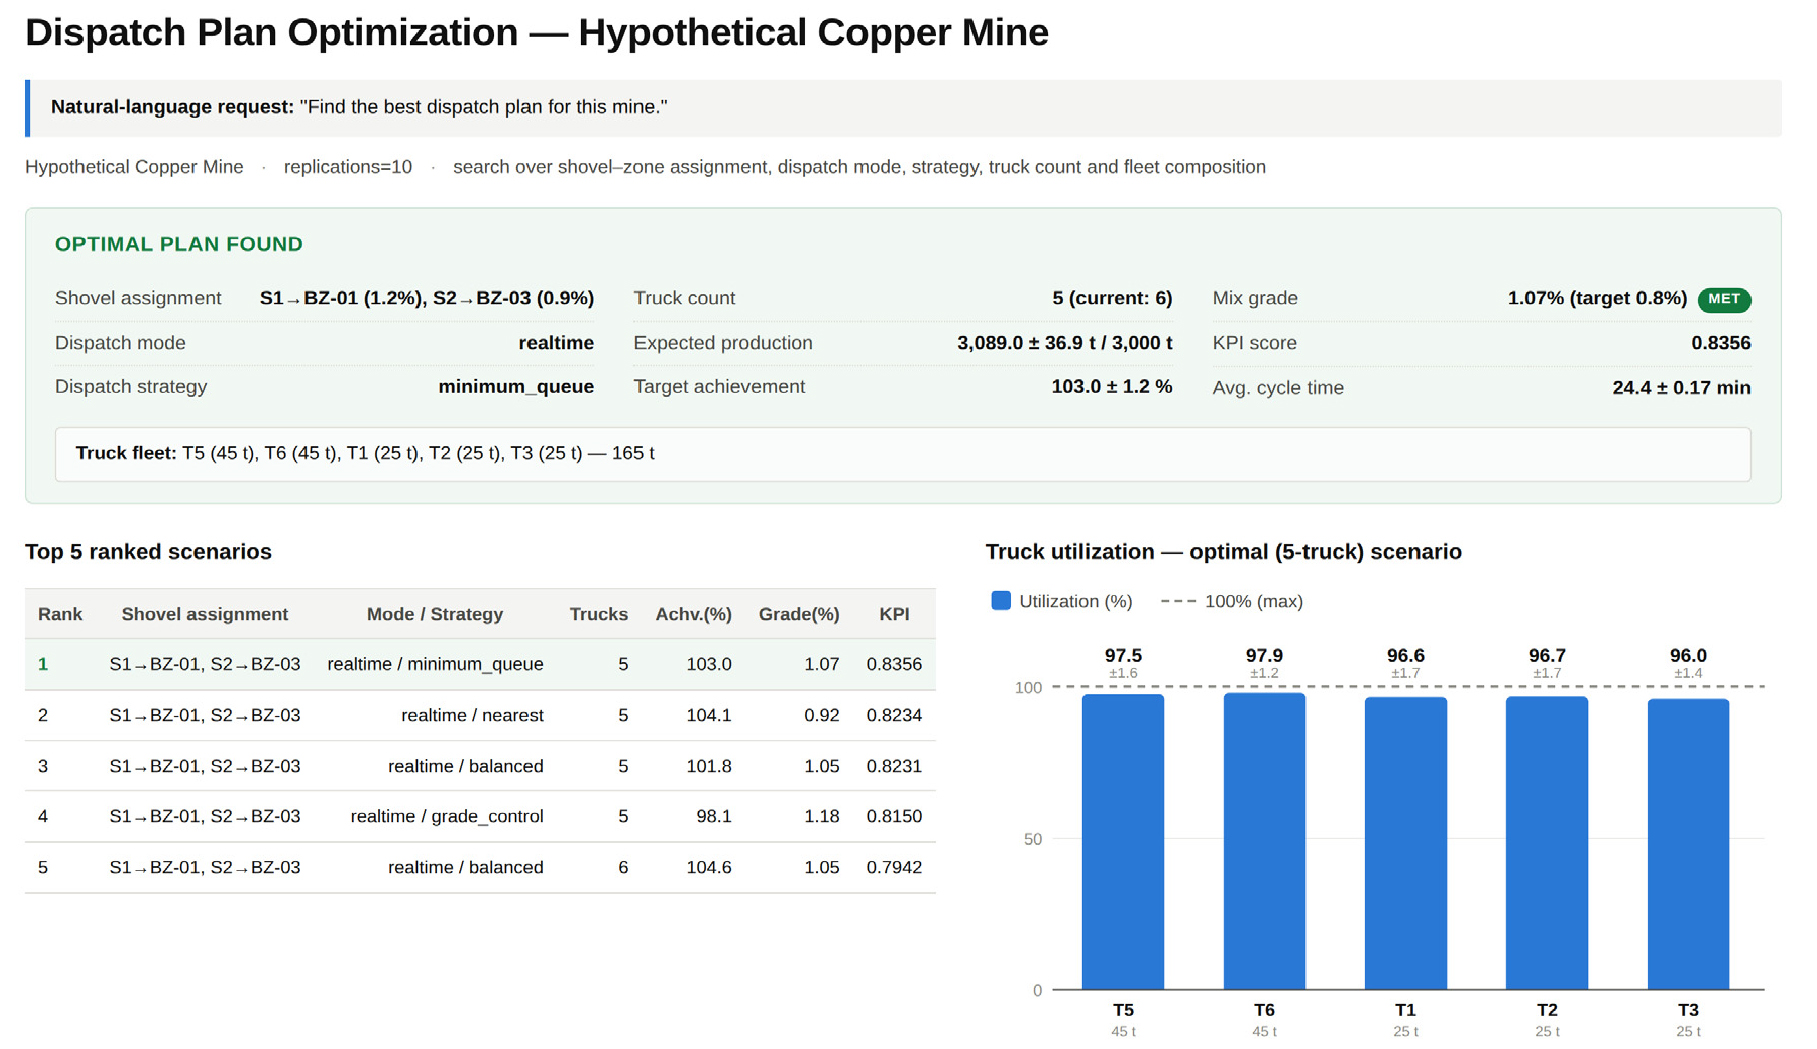
본 시스템의 Optimize dispatch 도구는 쇼벨–발파구역 배정, 배차 방식, 배차 전략, 트럭 수의 조합을 격자 탐색하여 목표 조건을 만족하는 배차안을 제안한다. Hypothetical Copper Mine 데이터셋에 대해 최적 배차 플랜을 탐색하는 자연어 요청을 LLM에 입력한 결과, 현재 6대 편성 대신 5대로도 목표 품위(0.8% Cu)를 만족하면서(혼합 품위 1.06%) 목표 생산량의 104.6%를 달성하는 배차안(실시간 배차, 대기열 최소화 전략)이 도출되었다(Fig. 7). 도구는 상위 5개 후보 시나리오와 최적안의 트럭별 이용률을 함께 제시하였다. 동일한 자연어 요청을 독립된 조건에서 3회씩 반복 수행한 결과, 두 대표 요청(전략·트럭 수 비교, 최적 배차 플랜 탐색) 모두 매번 동일한 도구가 호출되었다.
참조 모델 재현을 통한 엔진 검증
본 시스템이 산출하는 수치 결과의 정확성을 평가하기 위해, 기존 광산 시뮬레이션 연구에서 보고된 참조 모델을 본 시스템에서 재현하고 그 출력값을 비교하였다. 참조 모델로는 Park et al.(2023)이 보고한 국내 석회석 지하광산의 운반 시스템 시뮬레이션을 선정하였다. 해당 연구는 AnyLogic 기반의 DES 모델을 구축한 뒤, 6일간(2020년 11월 23일~28일)의 차량 운영 로그와 시뮬레이션 결과를 비교하여 모델을 검증하였다. 또한 트럭별·구역별 시간 파라미터와 생산량 검증 결과를 구체적으로 보고하고 있어 본 시스템의 재현 검증을 위한 참조 대상으로 적합하다.
해당 광산은 주방식 채광법으로 일 4,500톤의 석회석을 생산하며, 3대의 로더(버킷 4.76, 5.00, 5.70 m3)와 10대의 트럭(23톤 7대, 37.5톤 3대), 8개의 적재지점, 3대의 크러셔로 구성되어 있다. 1교대는 점심시간 1시간을 제외한 8시간이며, 생산 관리자가 일일 생산 계획에 따라 트럭과 로더를 적재지점에 배차한다. Park et al.(2023)은 6일간의 운영 기간 동안 4개의 운반 경로(Route A~D)가 사용되었음을 보고하였다.
본 시스템의 검증 시나리오로는 2020년 11월 23일 오전(08:00~12:00)에 수행된 Truck 1(37.5톤) Route A 운영 사례를 선정하였다. 본 시나리오는 적재지점 A에서 크러셔 3까지 단일 트럭이 단일 경로를 4시간 동안 운영한 사례로, Park et al.(2023)은 차량 운영 로그 실측 생산량과 AnyLogic DES의 출력값이 모두 412.5톤이었다고 보고하였다.
본 시나리오를 선정한 이유는 두 가지이다. 첫째, 단일 트럭·단일 경로 운영 사례이므로 다중 자원 간 경합이 발생하지 않아 사이클 단위의 재현이 비교적 단순하다. 둘째, Park et al.(2023)이 보고한 시간 파라미터를 이용하여 계산한 생산량이 해당 연구에서 제시한 생산량과 정확히 일치하므로, 시간 파라미터를 차용한 재현 결과의 비교 기준이 명확하다. 구체적으로 평균 사이클 시간은 21.41분이며, 240분 동안 11회의 운반 사이클을 완료하는 것으로 계산된다. 이에 트럭 적재용량 37.5톤을 적용하면 총 생산량은 412.5톤이다. 시간 파라미터로는 Park et al.(2023)이 보고한 공차 이동시간 8.83 ± 1.77분, 적재시간 3.73 ± 0.75분, 실차 이동시간 8.23 ± 1.65분, 하역시간 0.62 ± 0.12분을 그대로 이용하였다(Table 7).
Table 7.
Mapping of parameters from Park et al. (2023) to present configuration
| Parameter | Park et al. (2023) | This study |
| Mine | Underground limestone mine | Same ‒ single-route subset |
| Loading equipment | Loader at Loading Point A | L1 (shovel, zone LZ-A, capacity 1) |
| Dumping equipment | Crusher 3 |
C3 (crusher, zone DZ-3, hopper limit disabled) |
| Truck | Truck 1 (37.5 t) | T1 (37.5 t haul truck) |
|
Loading time (mean ± SD) | 3.73 ± 0.75 min | 3.73 ± 0.75 min |
|
Dumping time (mean ± SD) | 0.62 ± 0.12 min | 0.62 ± 0.12 min |
|
Travel ‒ empty (mean ± SD) | 8.83 ± 1.77 min | 8.83 ± 1.77 min |
|
Travel ‒ loaded (mean ± SD) | 8.23 ± 1.65 min | 8.23 ± 1.65 min |
| Operating duration | 240 min (AM session, 08:00–12:00) | 240 min |
| Replications | - | Stochastic: 10 (random seed 42–51); Deterministic: 1 (SD=0) |
검증은 두 가지 방식으로 수행하였다. 첫째, 확률 재현(stochastic)은 Park et al.(2023)이 보고한 시간 파라미터의 평균과 표준편차를 그대로 사용하여 10회 반복 실행한 것이다. 이때 반복 횟수는 10회로 설정하고 난수 시드는 42~51을 순차 사용하였다. 이는 Park et al.(2023)과 동일한 입력 조건에서 본 시스템이 유사한 결과 분포를 산출하는지 확인하기 위함이다. 둘째, 결정론적 재현(deterministic)은 모든 시간 파라미터의 표준편차를 0으로 두어 무작위 변동 없이 1회 실행한 것이다. 본 시스템이 입력 평균값으로부터 이론적으로 계산되는 결과(11 사이클 × 37.5톤 = 412.5톤)를 정확히 산출하는지, 즉 엔진의 기본 계산이 올바른지 확인하기 위함이다.
확률 재현 결과, 평균 생산량은 408.8 ± 11.9톤, 평균 사이클 타임은 20.85분으로 산출되었다(Table 8). 10회 반복 중 9회는 정확히 412.5톤(11 사이클)을, 1회는 375.0톤(10 사이클)을 산출하였으며, 후자는 사이클 타임의 무작위 변동으로 11번째 사이클이 240분 안에 완료되지 못한 경우에 해당한다. Park et al.(2023)이 보고한 412.5톤은 본 시스템의 산출 분포 평균에서 약 0.3 표준편차 거리에 위치하여, 동일한 입력 조건에서 본 시스템이 참조 모델의 보고값과 정합적인 결과 분포를 산출함을 확인하였다. 한편 확률 재현의 평균 사이클 타임(20.85분)이 입력 평균(21.41분)보다 짧게 나타난 것은, 운영 시간 내에 완료된 사이클만 평균에 포함되어 사이클 타임이 길게 실현된 경우가 상대적으로 덜 반영되었기 때문이다.
Table 8.
Numerical comparison of verification scenario between Park et al. (2023) and current study
Note. Park values are from Park et al. (2023). Completed cycles refer to those fully completed within 240 min; Park’s cycle counts are derived as 412.5/37.5 = 11. Stochastic column: mean ± SD over 10 replications; Diff. = stochastic mean − Park (deterministic = Park).
결정론적 재현 결과, 트럭은 240분 동안 11개의 사이클을 완료하여 412.5톤을 산출하였고, 사이클 타임 또한 21.41분으로 입력 평균과 정확히 일치하였다. 이는 본 시스템의 엔진이 사이클 수, 시간 누적, 생산량 계산을 정확히 수행함을 보여준다.
두 결과를 종합하면, 본 시스템의 엔진은 입력 평균값으로부터 이론값을 정확히 산출하고, 입력 분포로부터는 Park et al.(2023)의 결과와 정합적인 분포를 산출함을 확인할 수 있다. 다만 본 검증은 Park et al.(2023)의 전체 광산 운영 모델을 재현한 것이 아니라, 해당 연구가 보고한 시간 파라미터와 생산량 결과를 이용하여 단일 트럭, 단일 경로 조건에서 본 시스템의 사이클 처리 로직만 검증한 것이다. 다중 트럭 간의 자원 경합, 쇼벨 및 크러셔의 대기열 변화, 실시간 배차 의사결정에 대한 검증은 본 검증 범위에 포함되지 않았다.
토 의
본 연구에서 개발한 시스템의 의의는 접근성, 재사용성, 확장성의 세 가지 측면에서 정리할 수 있다. 첫째, 자연어 인터페이스는 코드 작성과 전문 소프트웨어 학습에 요구되는 부담을 완화함으로써 광산 현장의 시뮬레이션 분석 접근성을 높일 수 있다. 네 가지 배차 전략의 비교와 트럭 수 변화 분석에서 확인할 수 있듯이, 사용자는 개별 시뮬레이션 실행 명령이나 코드 작성 없이 자연어 요청을 통해 복수 조건의 시뮬레이션 실행과 결과 요약을 수행할 수 있다. 둘째, 설정파일을 이용하는 구조는 시뮬레이션 엔진과 광산별 입력자료를 분리하기 때문에, 대상 광산의 변경이나 입력 조건 갱신을 코드 수정 없이 처리할 수 있다. 가상의 데이터셋과 국내 석회석 지하광산의 참조 시나리오를 동일한 엔진에서 구성할 수 있었던 점은 이러한 재사용 가능성을 보여준다. 셋째, MCP 표준 인터페이스는 시뮬레이션 엔진과 LLM 사이의 통신 규약을 표준화하므로, 새로운 분석 도구를 추가하거나 LLM 클라이언트를 교체할 때 전체 시스템의 재설계 없이 해당 부분만 변경할 수 있다.
본 시스템의 특성은 상용 시뮬레이션 도구와의 비교를 통해 더 명확해진다(Table 9). 본 시스템은 상용 DES 소프트웨어와 비교할 때 상용 라이선스 의존성, 요구 전문성, AI 연동 방식 측면에서 접근성의 이점을 가진다. 반면 시각화 환경 측면에서는 상용 도구가 강점을 가진다. 따라서 본 시스템은 상용 시뮬레이션 도구를 대체하기 위한 범용 플랫폼이라기 보다, 광산 운반·배차 분석에서 접근성과 반복 분석 가능성이 우선되는 환경에 활용할 수 있는 보완적 도구로 이해하는 것이 적절하다.
Table 9.
Comparison between commercial DES software and proposed system
이러한 보완적 활용은 국내 광산의 여건에서 구체화될 수 있다. 국내 가행 광산의 다수는 중소 규모로서 전담 분석 인력이나 상용 시뮬레이션 도구를 보유하기 어려운 환경에 있으며, 본 시스템은 이러한 광산이 교대 단위의 트럭 수 조정이나 배차 전략 검토와 같은 반복적 운영 의사결정을 생산계획 수립 단계에서 자체적으로 사전 검토하는 용도로 우선 적용될 수 있다. 이때 설정파일의 시간 파라미터는 ICT 기반 운반 로그로부터 추출될 수 있으므로(Baek and Choi, 2019; Park and Choi, 2024), 운반 로그 수집 체계를 갖춘 광산에서는 로그로부터 이동시간과 적재·하역 시간의 분포를 추정하여 설정파일을 구성하는 반자동화된 도입 경로도 마련할 수 있다. 아울러 낮은 진입 장벽과 자연어 기반 상호작용의 특성은 스마트마이닝 실증 인프라나 광업 전문인력 양성 과정에서 배차·운반 분석의 교육 및 훈련 도구로서의 활용 가능성도 시사한다.
시뮬레이션 모델의 신뢰성은 두 단계의 점검을 통해 확보된다. 첫 번째는 검증(verification)으로, 모델이 의도한 논리에 따라 올바르게 구현되었는지를 확인하는 절차이다. 두 번째는 타당성 검증(validation)으로, 모델이 실제 시스템을 적절하게 대표하는지를 확인하는 절차이다(Sargent, 2010). 본 논문에서 수행한 것은 전자에 해당한다. 즉, Park et al.(2023)의 참조 모델에서 보고된 단일 트럭-단일 경로 시나리오를 본 시스템에서 재현하고, 동일한 시간 파라미터에서 기존 DES 출력값과 정합적인 결과가 출력되는지를 확인하였다. 반면 본 시스템이 실제 광산 운영 데이터를 얼마나 잘 대표하는지에 대한 타당성 검증은 본 연구의 범위에 포함하지 않았으며, 이 부분은 향후 연구과제로 다루어야 할 것이다.
이러한 구분을 바탕으로 본 연구의 한계는 다음과 같다. 첫째, 참조 모델 기반 검증은 단일 트럭과 단일 경로 조건에 한정되므로, 다중 트럭 간 자원 경합, 쇼벨과 크러셔에서의 대기열 변화 양상, 실시간 배차 의사결정의 적절성까지 검증한 것은 아니다. 둘째, 사례 적용은 가상 광산 데이터셋 한 개와 참조 광산의 단일 시나리오로 제한되어, 다양한 광산 조건에 대한 일반화에는 한계가 있다. 셋째, LLM의 자연어 의도 해석에는 모호성과 잘못된 도구 호출의 가능성이 존재하며, 최종적인 분석 조건과 결과 해석은 사용자의 확인을 필요로 한다. 넷째, 본 시스템의 범용성은 설정파일 스키마가 표현할 수 있는 광산 운반 구조로 제한되며, 이 외의 구조를 다루기 위해서는 엔진과 설정파일의 확장이 필요하다. 다섯째, 본 연구에서는 자연어 기반 시뮬레이션 분석이 가능함을 시연하였으나, 실제 현장 사용자의 작업 시간 단축, 학습 부담 감소, 사용성 향상에 대해서는 별도의 사용자 평가(user study)를 수행하지 않았다. 접근성 향상 효과의 정량적 확인은 향후 연구에서 다루어야 할 과제이다.
다만 현 단계에서 본 시스템의 적용 범위는 계획 단계의 분석 지원에 한정하는 것이 현실적이다. 실시간 배차 관제에 본 시스템을 직접 적용하는 것은 LLM 응답 지연과 의도 해석의 불확실성, 그리고 앞서 기술한 검증 범위의 한계를 고려할 때 아직 적절하지 않다. 이러한 한계를 넘어서기 위한 향후 확장 방향에서 가장 중요한 축은 AI 에이전트 기반 배차 의사결정 시스템으로의 발전이다. 본 연구에서 LLM은 시뮬레이션 조작과 분석을 위한 인터페이스 계층에 한정되었으며, 배차 의사결정은 사전 정의된 규칙 기반 전략에 의해 수행되었다. 향후에는 강화학습 또는 다중 에이전트 기반 배차 정책을 시뮬레이션 환경에서 학습시키고, 이를 본 시스템의 배차 의사 결정 모듈과 연계하는 방향으로 확장되어야 할 것이다. 이 경우 본 시스템의 시뮬레이션 엔진은 에이전트가 학습하거나 추론을 수행하는 가상 환경의 역할을 하며, MCP 도구 집합은 에이전트가 그 환경 안에서 시뮬레이션 실행, 조건 변경, 결과 조회 등을 위해 수행 가능한 작업들이 된다. 이러한 확장은 본 연구의 인터페이스 계층을 대체하는 것이 아니라, 그 위에 새로운 의사결정 계층을 추가하는 방향이다. 이 외에도 실측 데이터 기반 타당성 검증, 광산 유형과 규모에 대한 사례 다변화, 현장 사용자를 대상으로 한 사용성 평가, 비용·에너지·안전 분석을 위한 MCP 도구 확장, LLM 기반 자율 분석 에이전트로의 발전 등의 확장 방향을 고려할 수 있다.
결 론
본 연구에서는 광산 트럭 배차 이산사건 시뮬레이션 엔진을 MCP 서버를 통해 도구 형태로 제공하고, LLM이 자연어 요청을 해석하여 해당 도구를 호출하는 통합 시스템을 설계하고 구현하였다. 시뮬레이션 엔진의 기능은 분석 워크플로의 각 단계에 대응하는 여섯 개의 MCP 도구로 분해되었으며, 엔진과 광산별 입력 자료를 설정파일을 통해 분리하여 코드 수정 없이 서로 다른 광산을 동일한 엔진에서 구성할 수 있도록 하였다. 이때 LLM은 시뮬레이션의 계산 주체가 아니라 사용자 요청을 도구 호출로 변환하고 그 결과를 요약하는 인터페이스 계층으로 기능한다.
가상 광산 데이터셋을 이용한 시연에서 본 시스템은 네 가지 배차 전략의 비교와 트럭 수 변화에 따른 생산성 분석을 자연어 요청만으로 수행하였다. 특히 트럭 수 분석에서는 4대 운용 시 목표 생산량의 약 65% 수준에 그쳤으나, 6대부터 목표를 초과한 뒤 증가폭이 점차 둔화되는 양상이 나타났다. 이러한 결과는 자연어 요청 한 번으로 산출된 것으로, 본 시스템이 목표 생산량 달성을 위한 최소 대수 및 추가 투입 효과 분석과 같은 운영 의사결정의 정량적 기초 자료를 제공할 수 있음을 보였다. 또한 Park et al.(2023)이 보고한 지하 석회석 광산의 운반 시뮬레이션을 참조 모델로 재현하여, 결정론적 조건에서 이론 생산량(412.5톤)을 정확히 산출하고 확률적 조건에서도 참조 모델과 정합적인 결과 분포를 얻음으로써 엔진의 수치 정확성을 확인하였다.
본 연구는 광산 트럭 배차 시뮬레이션 엔진을 MCP 기반 에이전트 AI 환경에서 활용할 수 있도록 구조화한 첫 통합 시스템을 개발하였다. 본 시스템은 상용 시뮬레이션 도구를 대체하기보다, 전문 인력과 고가 도구에 의존하지 않고도 시뮬레이션의 분석 능력을 유지한 채 그 접근의 장벽을 낮추는 보완적 분석 도구로서 의의를 가진다. 다만 본 연구의 검증은 단일 트럭, 단일 경로 조건에 한정되며 사용자 평가 또한 수행되지 않았으므로, 향후 실측 데이터 기반의 타당성 검증과 사용성 평가, 그리고 강화학습 등 AI 에이전트 기반 배차 의사결정으로의 확장이 필요할 것으로 판단된다.