

서 론
이 론
천연수소 생성 기작
천연수소 이동 및 집적
주요 지질학적·지구물리학적 자료
머신러닝
연구 방법
입력 데이터
학습 목표
데이터 전처리
모델 구성 및 학습
모델 성능 평가
특성 중요도 분석 방법
결과 및 고찰
모델의 천연수소 유망도 예측 성능 비교
유망도 예측 인자의 특성 중요도
전문가 의사결정 지원 도구로서의 모델 활용 가능성
결 론
서 론
전 세계적으로 심화되는 기후 위기에 대응하기 위해 온실가스 감축과 탄소중립의 중요성이 더욱 강조되고 있다(Staffell et al., 2019). 이러한 배경에서 청정에너지원으로서 수소에 대한 관심이 증가하고 있으나, 그린 수소는 높은 생산 비용과 대규모 생산의 제약이 있으며(Hassanpouryouzband et al., 2021), 그레이 수소는 생산 과정에서 상당한 양의 탄소를 배출한다는 한계가 있다(Hermesmann and Müller, 2022). 최근에는 이러한 기존 수소 생산 방식의 한계를 보완할 수 있는 대안으로 천연수소(natural hydrogen)가 주목받고 있다(Zgonnik, 2020). 천연수소는 지하에 자연적으로 존재하는 수소를 시추를 통해 직접 생산할 수 있다는 점에서 기존의 인위적인 수소 생산 방식과 구별된다. 또한 생산 비용을 낮출 가능성이 있으며, 전과정평가(life-cycle assessment) 측면에서도 상대적으로 낮은 탄소 배출량을 보일 수 있다는 장점이 제시되고 있다(Prinzhofer et al., 2018; Zgonnik, 2020). 특히 아프리카 말리에서는 천연수소의 상업적 생산 가능성이 실제 사례를 통해 입증되었으며, 이를 계기로 미국, 프랑스, 호주 등 여러 국가에서 천연수소의 자원 잠재력을 평가하고 탐사 기술을 고도화하기 위한 연구와 프로젝트가 활발히 추진되고 있다(Prinzhofer et al., 2018).
천연수소 탐사를 위한 시추 이전 단계에서는 지표 징후와 다양한 탐사 자료를 활용하여 유망지역을 선별하는 초기 탐사 절차가 제안되었다(Moretti et al., 2021). 먼저 지질학적·지구물리학적 자료를 바탕으로 천연수소의 생성, 이동 및 집적 가능성이 높은 지역을 선별한다. 이후 위성영상 등의 원격탐사 자료를 활용하여 Fairy Circle과 같이 지표 가스 누출과 관련될 가능성이 있는 지형적 특징을 식별한다. 다음으로, 식별된 지역에서 휴대용 가스 탐지기 등을 이용하여 토양 내 수소 농도를 현장 측정하고 가스 시료를 채취한다. 마지막으로 채취한 시료에 대한 실험실 분석을 통해 수소의 존재 여부와 가스 조성 등을 확인하고, 이를 바탕으로 해당 지역의 천연수소 탐사 가능성을 평가한다(Moretti et al., 2021). 그러나 지표 가스 누출 징후를 중심으로 한 탐사 기법은 심부 수소의 생성 및 집적 조건을 직접적으로 평가하기 어렵고, 지표에서 관찰되는 현상만으로는 광역적인 수소 시스템의 공간적 분포를 충분히 파악하기 어렵다는 한계가 있다(Moretti et al., 2021). 따라서 시추 이전 단계에서 탐사 불확실성을 줄이고 광역적인 규모에서 탐사 우선순위를 설정하기 위해서는 다양한 지질학적·지구물리학적 자료를 통합하여 수소의 생성, 이동, 저류 및 밀봉에 관련된 지질학적 요소를 정량적으로 평가하는 천연수소 유망도 평가(prospectivity assessment)가 필요하다(U.S. Geological Survey, 2025).
미국 지질조사국(USGS)은 미국 본토를 대상으로 천연수소의 축적 가능성을 평가한 광역 규모의 예비 유망도 지도(prospectivity map)를 제시하였다(U.S. Geological Survey, 2025). 이 예비 유망도 지도는 수소의 생성(source), 저류층(reservoir), 덮개암(seal) 등 천연수소 시스템의 주요 요소와 관련된 지질학적·지구물리학적 자료를 통합하고, 전문가 판단에 기반한 충족 확률(Chance of Sufficiency, COS) 평가 모델을 적용하여 구축되었다(U.S. Geological Survey, 2025). 이를 통해 미국 중부 대륙 균열대와 일부 해안 지역 등 천연수소 잠재력이 상대적으로 높은 지역을 식별하고, 광역적인 탐사 우선순위를 설정하기 위한 정량적 평가 체계를 제시하였다(U.S. Geological Survey, 2025). 이러한 USGS의 예비 유망도 지도는 천연수소 시스템을 구성하는 주요 지질학적 요소의 공간적 분포와 상대적 유망성을 통합적으로 가시화함으로써, 초기 탐사 단계에서 유망지역을 선별하고 탐사 리스크를 줄이기 위한 기초 자료를 제공한다는 점에서 의의가 있다(U.S. Geological Survey, 2025).
천연수소 유망도 평가는 단층, 암상, 중력·자력·방사능 이상 등 서로 다른 특성을 갖는 다양한 지질학적·지구물리학적 자료를 종합적으로 고려해야 하므로, 이질적인 다원 자료를 정량적으로 통합·분석할 수 있는 방법론이 요구된다. 특히 천연수소의 생성·이동·집적은 단일 요인에 의해 결정되는 것이 아니라 여러 지질학적·지구물리학적 요인의 복합적인 상호작용에 의해 좌우되므로, 변수 간의 복잡한 비선형 관계를 데이터 기반으로 분석할 수 있는 머신러닝(machine learning, ML) 기법을 활용할 수 있다. 이러한 ML 기반 접근법은 광역적인 지질·지구물리 자료로부터 천연수소의 공간적 유망도를 정량적으로 예측함으로써 전문가 기반 해석을 보완하고, 초기 탐사 단계에서 유망지역의 우선순위를 설정하기 위한 의사결정 지원 도구로 활용될 수 있다.
이러한 접근의 적용 가능성을 검토하기 위해 본 연구에서는 USGS가 구축한 천연수소 예비 유망도 지도를 기준 유망도 지도(reference prospectivity map)로 설정하고, 다양한 지질학적·지구물리학적 입력자료를 이용하여 해당 지도의 공간적 분포를 재현할 수 있는지를 평가하고자 한다. 이를 위해 Random Forest(RF)와 U-Net을 선택하여, 두 모델의 기준 유망도 지도 재현 성능과 공간적 예측 특성을 비교하였다. 본 연구에서의 기준 유망도 지도는 모델의 학습 및 비교를 위한 목표 자료이며, 실제 천연수소 부존 여부를 확인한 관측자료를 의미하지 않는다. 본론에서는 천연수소의 주요 생성 기작과 이동 및 집적 과정을 고찰하고, 입력자료의 구성과 전처리, 자료 분할 및 모델 구축 과정을 설명한다. 이후 시험용 데이터를 이용하여 예측 모델의 성능을 평가하고, 두 모델에 특성 중요도 분석을 적용하여 입력변수에 대한 모델의 의존성을 비교한다. 마지막으로 기준 지도에 내재한 가정과 불확실성 및 자료 분할의 한계를 고려하여 결과의 해석 범위와 향후 검증 과제를 논의한다.
이 론
천연수소 생성 기작
천연수소는 단일 기작이 아니라 다양한 지질학적 환경에서 여러 물리·화학적 과정에 의해 생성될 수 있으며, 대표적인 생성 기작으로 사문석화 반응, 방사선 분해, 심부 기원 등이 제시되고 있다(Zgonnik, 2020; Moretti et al., 2021). 사문석화 반응은 초염기성 암석(Ultramafic rocks)에 포함된 철을 함유한 광물이 물과 반응하는 과정에서 산화되고, 이에 수반되는 물의 환원을 통해 수소가 생성되는 반응으로, 해령 주변뿐만 아니라 대륙 지각에서도 발생할 수 있으며 천연수소의 주요 생성 기작 중 하나로 알려져 있다(McCollom and Bach, 2009; Moretti et al., 2021; U.S. Geological Survey, 2025). 방사선 분해는 결정질 암석에 포함된 우라늄(U), 토륨(Th), 칼륨(K) 등의 방사성 동위원소의 붕괴로 방출되는 이온화 에너지가 지하수에 전달되어 물 분자를 분해함으로써 수소를 생성하는 기작이다. 이러한 과정은 특히 오래된 결정질 기반암에서 지질학적 시간 규모에 걸쳐 지속될 수 있다(Lollar et al., 2014; U.S. Geological Survey, 2025). 한편, 맨틀 및 지구 심부 기원의 수소는 지구 심부에 존재하는 원시 수소(primordial hydrogen)의 탈기(outgassing) 또는 섭입된 함수 광물의 탈수·분해 과정 등과 관련될 가능성이 제시되어 왔다(Zgonnik, 2020; U.S. Geological Survey, 2025). 이러한 심부 기원의 수소는 심부 단층 및 지각 규모의 구조대를 잠재적인 이동 경로로 이용하여 상부 지각으로 이동하고, 적절한 저류층과 덮개암이 존재하는 경우 집적될 수 있다(U.S. Geological Survey, 2025). 이외에도 유기물의 열분해, 미생물 활동, 단층 운동과 암석 파쇄에 수반되는 기계화학적 반응(mechanochemical or mechanoradical reactions), 황화물 광물의 산화 등 다양한 수소 생성 기작이 제안되고 있다. 그러나 각 생성 기작의 상대적인 기여도와 지질학적 조건에 따른 중요성에는 여전히 상당한 불확실성이 존재하며, 이에 대해서는 추가적인 연구가 필요하다(Moretti et al., 2021; Mahlstedt et al., 2022; U.S. Geological Survey, 2025).
천연수소 이동 및 집적
지하에서 생성된 천연수소는 농도 및 압력 구배, 부력 등의 영향으로 확산과 유체 이동을 통해 상부 지각으로 이동할 수 있으며, 단층·균열대 및 투수성 지층은 주요 이동 경로로 작용할 수 있다(U.S. Geological Survey, 2025). 이동한 수소가 지하에 장기간 집적되기 위해서는 충분한 공극률과 투과도를 갖는 저류층이 존재하여 수소를 저장할 수 있어야 한다. 한편, 수소는 분자 크기가 작고 이동성과 확산성이 높아 상부 지각 또는 지표로 유실될 가능성이 있으므로, 장기간 보존을 위해서는 낮은 투과도와 충분한 밀봉 능력을 갖는 덮개암이 필요하다(Moretti et al., 2021; U.S. Geological Survey, 2025). 암염을 포함한 증발암(evaporites)이나 일부 치밀한 화성암체는 이러한 덮개암 역할을 할 수 있으며, 저류층과 덮개암이 적절한 지질구조를 형성할 경우 천연수소의 포획 및 집적에 유리한 트랩이 형성될 수 있다(Moretti et al., 2021; U.S. Geological Survey, 2025).
주요 지질학적·지구물리학적 자료
천연수소의 생성·이동·집적은 다양한 지질학적 과정과 환경에 의해 영향을 받으므로, 부존 가능성을 평가하기 위해서는 각 과정과 관련된 지질학적·지구물리학적 자료를 종합적으로 활용하는 것이 중요하다(U.S. Geological Survey, 2025). 먼저 화강암을 비롯한 결정질 기반암에 포함된 우라늄, 토륨, 칼륨 등의 방사성 원소는 방사선 분해에 의한 수소 생성과 관련될 수 있으므로, 항공 감마선 분광 자료 및 지표 방사능 탐사 자료를 이용하여 이들 방사성 원소의 공간적 분포를 파악할 수 있다(U.S. Geological Survey, 2025; Milkov, 2022). 또한 철이 풍부한 고철질·초고철질 암석과 이들의 사문석화 과정은 천연수소 생성과 밀접하게 관련되며, 이 과정에서 암석의 밀도와 자화 특성이 변화할 수 있다. 따라서 중력 및 자력 이상 자료는 수소 생성에 유리한 고철질·초고철질 암체와 관련 변질대를 간접적으로 식별하는 데 활용될 수 있다(U.S. Geological Survey, 2025). 한편, 하부 지각이나 맨틀에서 기원한 심부 수소는 심부 단층대, 균열대 및 지각 규모의 봉합대와 같은 구조적 불연속면을 따라 상부 지각으로 이동할 가능성이 있으므로, 지질 구조 자료와 지구물리 자료를 이용하여 이러한 잠재적 이동 경로를 평가할 수 있다(U.S. Geological Survey, 2025). 또한 생성된 수소가 상부 지각으로 이동하여 저류층에 집적되는 과정은 석유·가스 시스템과 일부 유사한 특성을 가지므로, 이용 가능한 2D/3D 탄성파 탐사 자료와 물리검층(well logging) 자료를 활용하여 저류층의 분포와 특성, 덮개암의 연속성 및 밀봉 능력, 그리고 이들을 포함하는 트랩 구조를 평가할 수 있다(U.S. Geological Survey, 2025).
머신러닝
머신러닝은 데이터로부터 변수 간의 관계와 패턴을 학습하고, 이를 바탕으로 새로운 데이터에 대한 예측 또는 추정을 수행하는 데이터 기반 방법론이다(Bishop, 2006). 딥러닝(deep learning, DL)은 머신러닝의 한 분야로서, 다수의 인공신경망 계층을 이용하여 데이터에 내재된 복잡하고 비선형적인 특징을 계층적으로 표현하고 학습할 수 있다(LeCun et al., 2015). 심층 신경망의 학습에는 역전파(backpropagation)가 핵심적으로 활용되며, 손실함수의 기울기를 출력층에서 입력층 방향으로 연쇄법칙(chain rule)에 따라 계산하여 각 모델 파라미터에 대한 기울기를 구한다(Rumelhart et al., 1986). 이후 계산된 기울기를 기반으로 최적화 알고리즘을 적용하여 모델 파라미터를 갱신한다. 이러한 계층적 특징 학습 능력을 바탕으로 딥러닝은 복잡한 함수 근사 및 패턴 인식 문제에 효과적으로 적용되고 있다(Rumelhart et al., 1986; LeCun et al., 2015).
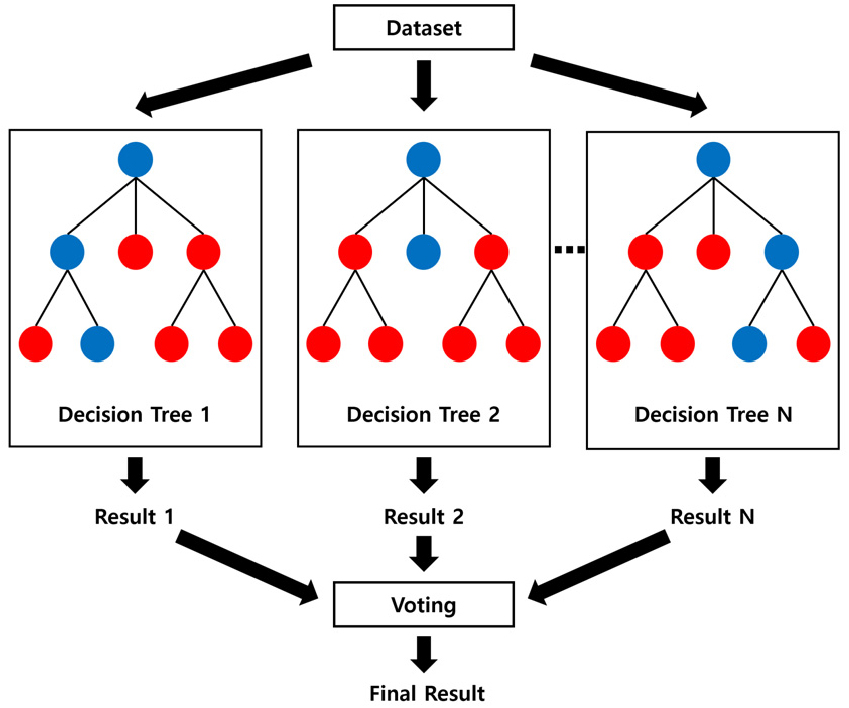
RF는 Breiman(2001)이 제안한 의사결정나무 기반의 앙상블 학습 방법으로, 다수의 의사결정나무(decision trees)를 구축하고 이들의 예측 결과를 종합하여 최종 예측값을 산출한다(Fig. 1). 각 의사결정나무는 원 데이터로부터 생성된 부트스트랩 표본(bootstrap sample)을 이용하여 학습되며, 각 분기에서 전체 입력 변수 중 무작위로 선택된 일부 변수만을 후보로 사용한다. 이러한 데이터 및 변수의 무작위성을 통해 개별 트리 간의 상관성을 감소시키고, 단일 의사결정나무에 비해 과적합을 완화하면서 변수 간의 복잡한 비선형 관계를 학습할 수 있다(Breiman, 2001). 회귀 문제에서는 일반적으로 개별 트리의 예측값을 평균하여 최종 예측값을 산출한다.
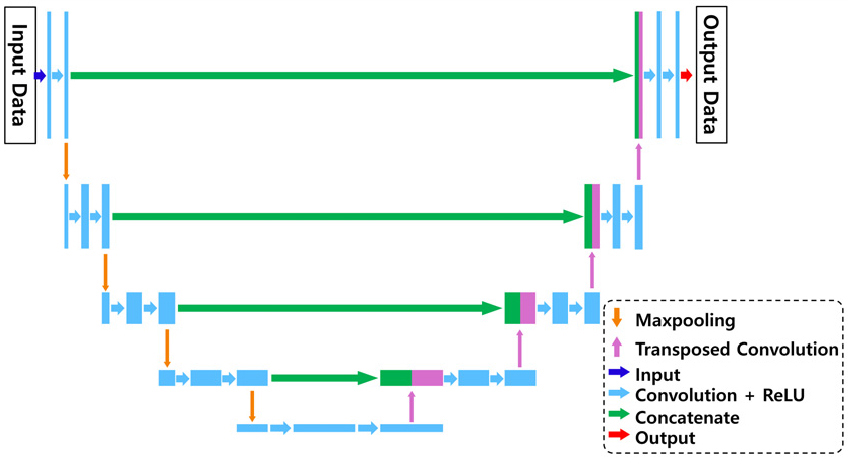
U-Net은 Ronneberger et al.(2015)이 영상 분할(image segmentation)을 위해 제안한 합성곱 신경망(convolutional neural network, CNN) 기반의 인코더–디코더 구조이다(Fig. 2). 인코더(encoder)는 연속적인 합성곱 및 다운샘플링 과정을 통해 입력 자료의 다중 스케일 특징을 추출하고, 디코더(decoder)는 이를 업샘플링하여 공간적 해상도를 복원한다. 이 과정에서 동일한 공간적 스케일에 해당하는 인코더와 디코더의 특징 맵을 연결하는 스킵 연결(skip connection)을 통해 다운샘플링 과정에서 손실될 수 있는 위치 및 세부 정보를 보완한다(Ronneberger et al., 2015). 따라서 U-Net은 국소적인 공간 정보와 서로 다른 공간 스케일에서 나타나는 특징을 함께 학습할 수 있으며, 이러한 특성은 지질학적·지구물리학적 자료와 같이 공간적 연속성과 다중 스케일 패턴을 포함하는 자료의 분석에 활용될 수 있다.
연구 방법
입력 데이터
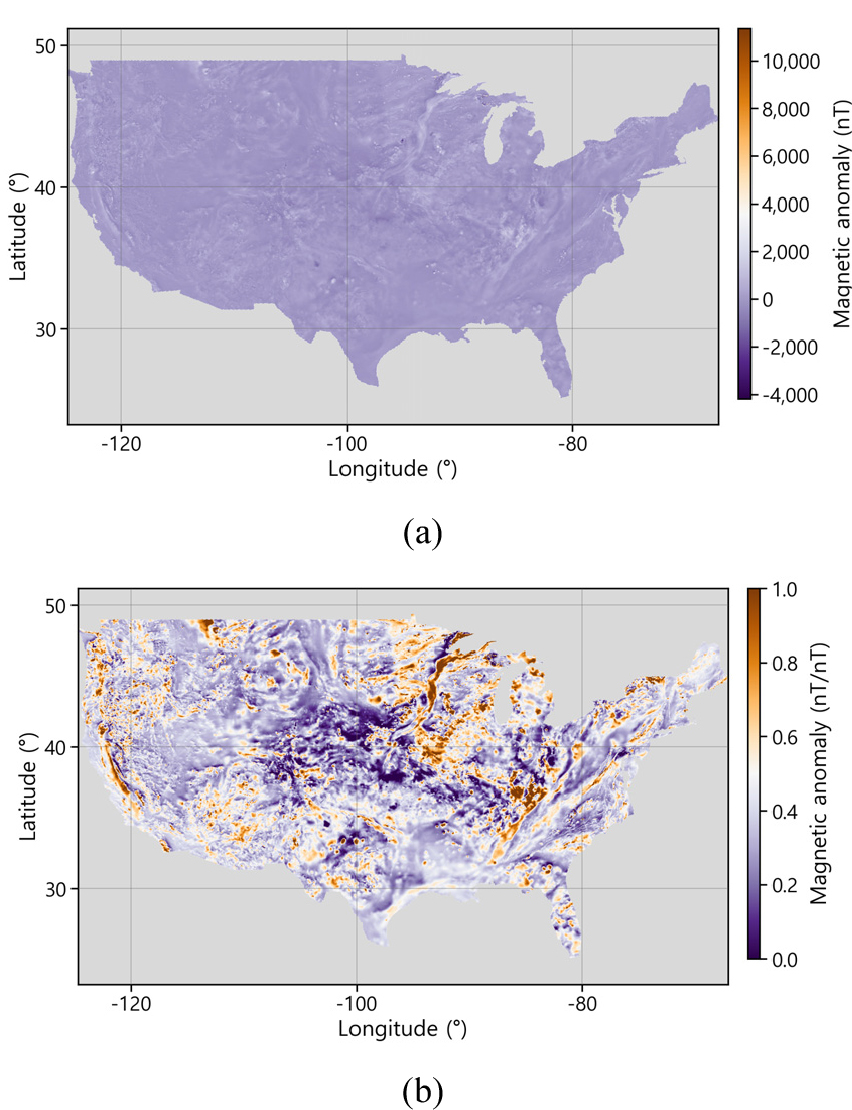
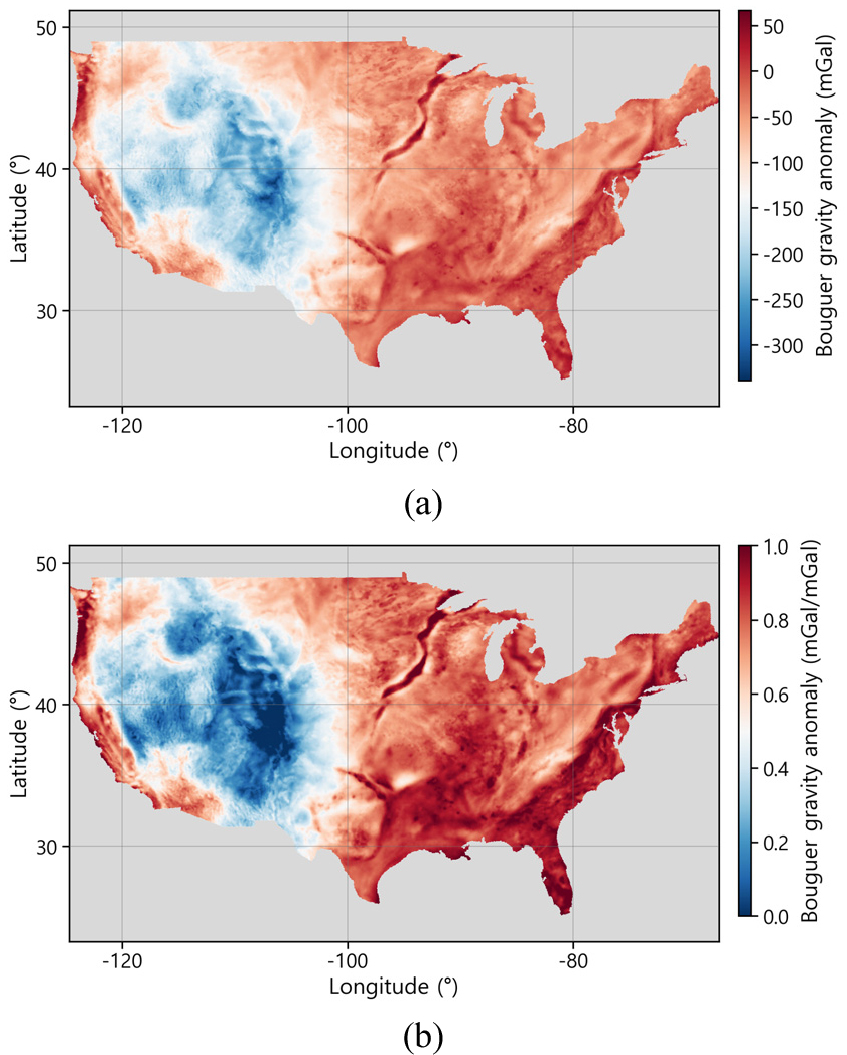
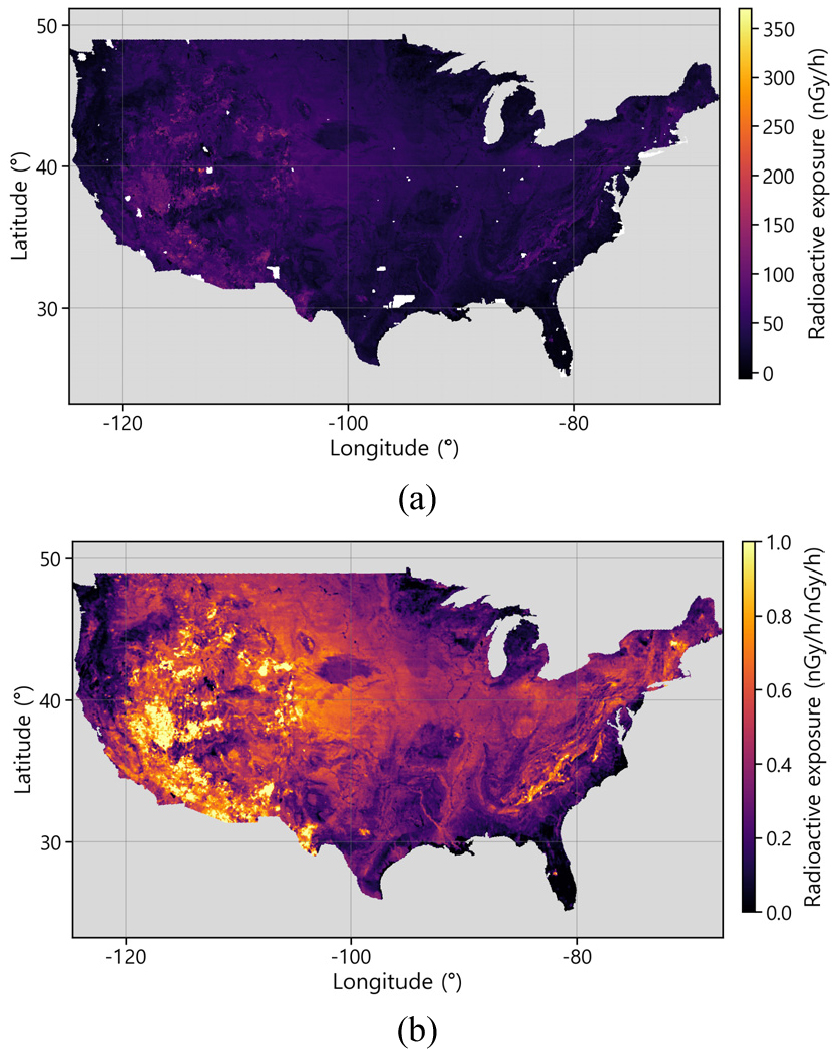
본 연구에서는 천연수소의 생성·이동·집적과 관련된 지질학적 조건을 반영하기 위해 자력, 중력, 방사능, 지질 및 단층 자료를 입력 변수로 활용하였다. 자력이상 자료는 지하 암석의 자화 특성 차이를 반영하며, 특히 사문석화 과정에서 생성될 수 있는 자철석과 철이 풍부한 고철질·초고철질 암체의 공간적 분포를 간접적으로 추정하는 데 활용할 수 있다. 자력이상 입력 자료로는 USGS에서 제공하는 1 km 격자 간격의 북미 대륙 자기이상 병합 격자(Merged Magnetic Anomaly Grid)를 사용하였다(U.S. Geological Survey, 2002)(Fig. 3). 중력이상 자료는 지각을 구성하는 암석의 밀도 차이를 반영하므로, 지표에 노출되지 않은 심부 암체와 광역적인 지각 구조를 추정하는 데 활용할 수 있다. 분석에는 USGS에서 제공하는 미국 본토의 4 km 격자 간격 부게 중력이상(Bouguer gravity anomaly)과 지각평형 잔여 중력이상(isostatic residual gravity anomaly) 격자 자료를 사용하였다(U.S. Geological Survey, 1999)(Fig. 4). 방사능 자료는 지표 부근의 우라늄, 토륨, 칼륨 등 방사성 원소의 공간적 분포를 반영하므로, 방사선 분해(radiolysis)에 의한 수소 생성과 관련된 지질학적 조건을 간접적으로 평가하는 데 활용할 수 있다. 방사능 입력 자료로는 USGS에서 제공하는 감마선 분광 격자 자료를 사용하였다(U.S. Geological Survey, 2005)(Fig. 5).
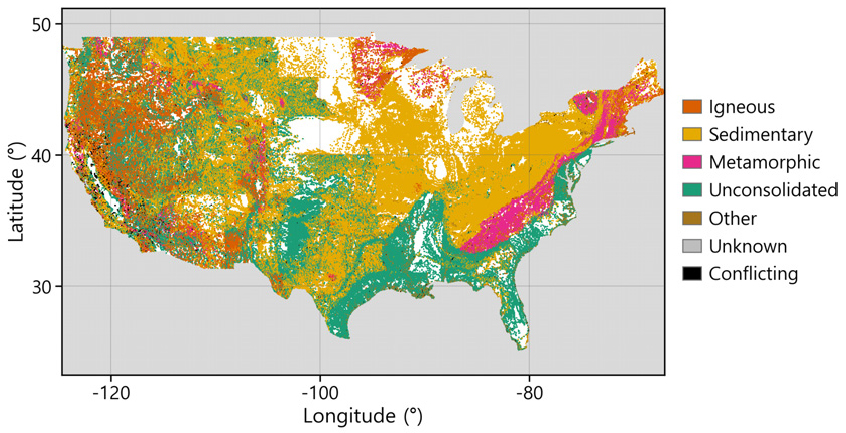
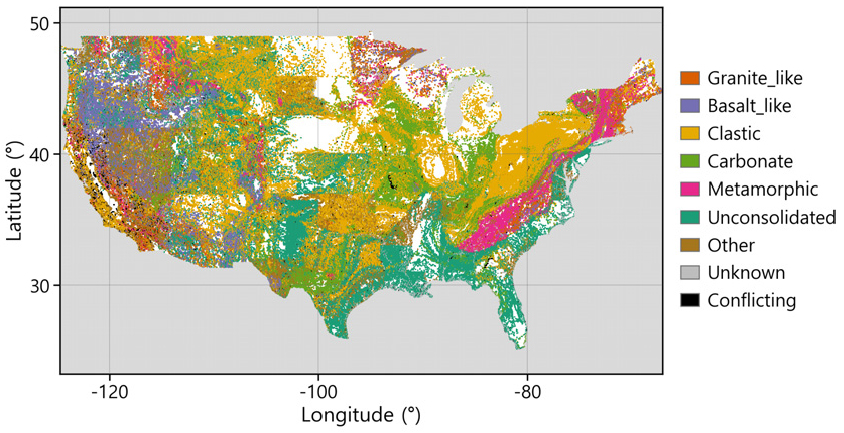
지질 자료는 연구 지역의 암석 기원과 암상 분포를 나타내는 입력자료로 사용하였다. USGS의 SGMC(State Geologic Map Compilation)에서 지질 기원(GENERALIZED_LITH)과 주요·부차 암상(MAJOR1, MAJOR2, MINOR1) 정보를 이용하였다(U.S. Geological Survey, 2017). 지질 기원 정보는 화성·퇴적·변성 등 지질 단위의 형성 기원을 나타내며(Fig. 6), 암상 정보는 각 지질 단위를 구성하는 암석의 종류를 나타낸다(Fig. 7). 본 연구에서는 이들 자료를 이용하여 암석의 기원과 구성 차이에 따른 공간적 특성을 모델에 제공하고, 기준 유망도 지도를 재현하는 데 있어 해당 정보의 역할을 평가하였다.
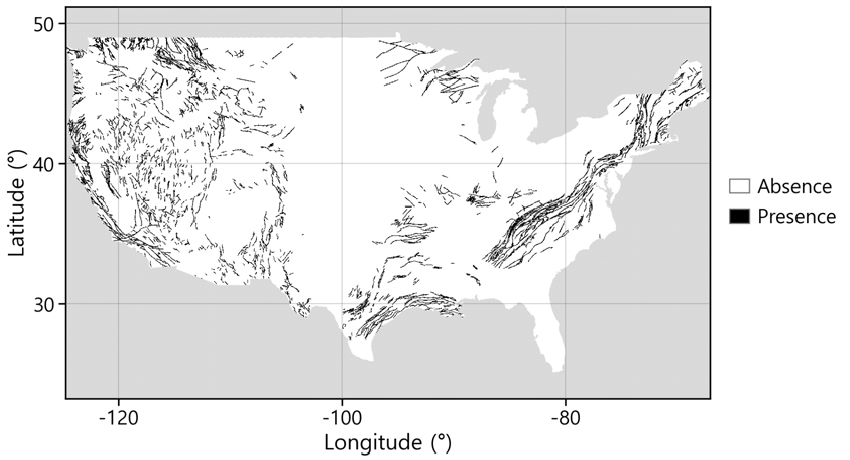
단층 자료는 북미 지질도(Geologic Map of North America, GMNA)에 수록된 단층선 자료를 사용하였다(U.S. Geological Survey, 2009). 해당 자료는 지도에 표시된 단층의 위치와 선형 분포를 나타내며(Fig. 8), 연구 지역의 구조적 특성을 표현하는 입력자료로 활용하였다. 단층은 천연수소의 이동이나 누출과 관련된 잠재적 경로가 될 수 있으므로(U.S. Geological Survey, 2025), 본 연구에서는 지도상 단층의 공간적 분포와 기준 유망도 사이의 관계를 모델이 학습할 수 있도록 하였다. 다만 단층선의 분포만으로 개별 단층의 투수성, 심부 연결성 또는 실제 수소 이동 여부를 판단할 수는 없다.
학습 목표
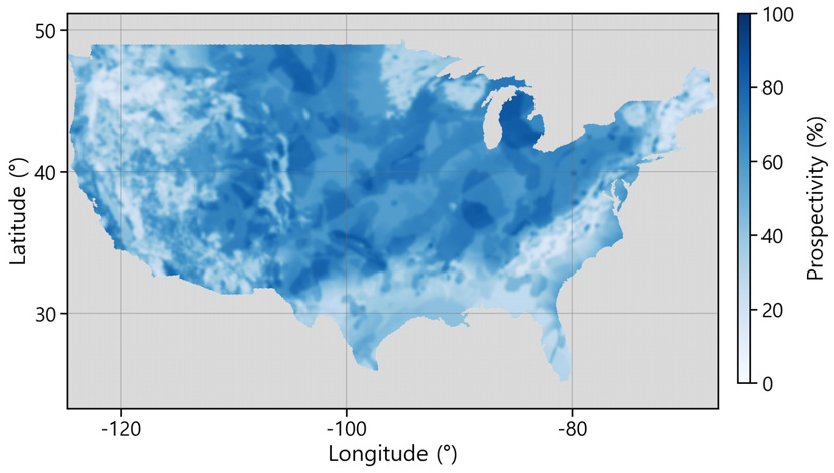
머신러닝 모델의 학습 목표로는 USGS가 2025년에 발표한 미국 본토 대상 천연수소 예비 유망도 지도를 사용하였다(Fig. 9). 해당 지도는 천연수소 발견 지점의 분포를 나타내는 관측 지도가 아니라, 수소 생성원, 저류층 및 덮개암 등 천연수소 시스템의 주요 요소가 충족될 가능성을 평가하고 통합한 결과이다(U.S. Geological Survey, 2025). 지도 구축 과정에서는 각 요소의 평가에 수반되는 불확실성을 반영하기 위해 Monte Carlo 시뮬레이션을 수행하고, 그 결과를 P10, P50 및 P90 수준의 지도로 제시하였다. 여기서 P10, P50 및 P90은 초과확률을 기준으로 정의된다. 각 위치에서 P10은 시뮬레이션 결과의 10%가 초과하는 값이며, P90은 90%가 초과하는 값이다. 따라서 P10은 상대적으로 낙관적인 추정치, P90은 상대적으로 보수적인 추정치에 해당하고, P50은 추정 분포의 중앙값을 나타낸다. 본 연구는 낙관적 또는 보수적 시나리오에 따른 탐사 후보지 선정이 아니라, 기존 유망도 평가의 대표적인 공간 분포를 재현하는 것을 목적으로 하므로 P50 지도를 기준 유망도 지도로 선정하였다.
데이터 전처리
서로 다른 좌표계와 격자 구조를 갖는 자료를 통합하기 위해, 공간 연산에 사용하는 좌표계를 기준 유망도 자료의 미터 단위 투영좌표계로 통일하였다. 기준 유망도 자료는 원래 5 km 간격의 격자로 제공되며, 이를 이중선형 보간(bilinear interpolation)을 통해 2.5 km 간격의 격자로 변환하였다. 원래 격자점의 정답은 유지하였으며, 자료 범위 밖으로의 외삽은 수행하지 않았다. 방사능 이상, 자기이상 및 중력이상과 같은 연속형 입력자료는 가까운 자료점에 높은 가중치를 부여하는 역거리 가중 보간(inverse distance weighting, IDW)으로 격자를 정렬하였다. 최대 50 km 이내의 최근접 자료점을 최대 5개까지 사용하고 거리에 반비례하는 가중치를 적용하였으며, 원자료와 위치가 일치하면 해당 값을 사용하고 유효한 자료가 없으면 결측으로 처리하였다(Fig. 3-b, Fig. 4-b, Fig. 5-b).
지질 기원은 6개 범주로 구분하여 원-핫 인코딩(one-hot encoding)을 적용하였다. 암상은 주요·부차 속성을 8개 통합 범주로 재분류하여 해당 범주가 하나라도 포함되면 1을 부여하였으며, 이에 따라서 암상은 동일 위치에서 여러 범주가 동시에 나타날 수 있다. 범주형 변수는 50 km 이내의 가장 가까운 자료값을 사용하는 최근접 이웃(nearest-neighbor) 방법으로 정렬하였으며, 동일 좌표의 인코딩 결과가 일치하면 통합하고 충돌하면 결측으로 처리하였다. 단층 자료는 중복 형상을 제거한 뒤, 투영좌표계에서 최대 선분 길이가 1 km가 되도록 세분화를 진행하였다. 이후 각 격자점에서 단층 선분까지의 최단거리를 계산하여 2.5 km 이하이면 1, 그렇지 않으면 0인 단층 존재 지시변수를 격자점마다 부여하여 사용하였다. 이 임계거리는 격자 간격에 맞춘 처리 기준으로, 천연수소의 이동 거리나 단층의 지질학적 영향 반경을 의미하지 않는다.
연속형 입력에는 주변 값의 중앙값으로 국지적인 변동을 완화하는 3 × 3 격자 크기의 미디언 필터(median filter)를 적용하였다. 이후 결측값은 학습 집합에서 계산한 변수별 중앙값으로 대체하였다. 연속형 변수는 학습 집합의 1백분위수와 99백분위수를 경계로 값을 제한하는 클리핑(clipping)을 수행한 뒤, 동일한 경계값을 이용한 min–max 정규화로 0–1 범위의 무차원 값으로 변환하였다. 결측 대체값과 클리핑·정규화 기준은 학습 집합에서만 산정하여 검증 및 시험 집합에 동일하게 적용하였다. 지질 기원·암상·단층 존재 변수와 같은 범주형 입력에는 미디언 필터와 백분위수 기반 정규화를 적용하지 않았다. 또한 결측값을 대체하기 전의 결측 여부를 보존하기 위해 각 기본 변수에 이진 보조 채널을 추가하고, 결측이면 1, 그렇지 않으면 0을 부여하였다.
자료의 전체 영역을 서로 중첩되지 않는 64 × 64 격자 크기의 공간 패치로 나누었다. 이들 패치를 학습·검증·시험 집합에 각각 60%, 15%, 25%의 비율로 무작위 배정하였다(Fig. 10). 실제 배정된 패치 수와 유효 격자 수는 Table 1에 정리하였다. RF와 U-Net에는 동일한 자료 분할을 적용하였고, RF는 학습 패치에 포함된 유효 격자의 속성 벡터를 사용하였으며, U-Net은 해당 패치를 입력으로 사용하였다. 검증 집합은 RF의 하이퍼파라미터 탐색과 U-Net의 학습 중 모델 선택에 사용하였고, 시험 집합은 이러한 선택 과정에 사용하지 않았다. 이 분할은 동일한 격자가 여러 집합에 중복되는 것을 방지하지만, 서로 다른 집합에 속한 인접 패치 사이에는 공간적 상관성이 남을 수 있다. 또한 지질 범주에 따른 분할은 수행하지 않았으므로 각 집합의 지질학적 대표성을 보장하지 않는다. 따라서 평가 결과는 연구 영역 내에서 학습 및 모델 선택에 사용하지 않은 패치에 대한 기준 지도 재현 성능으로 해석하였다.
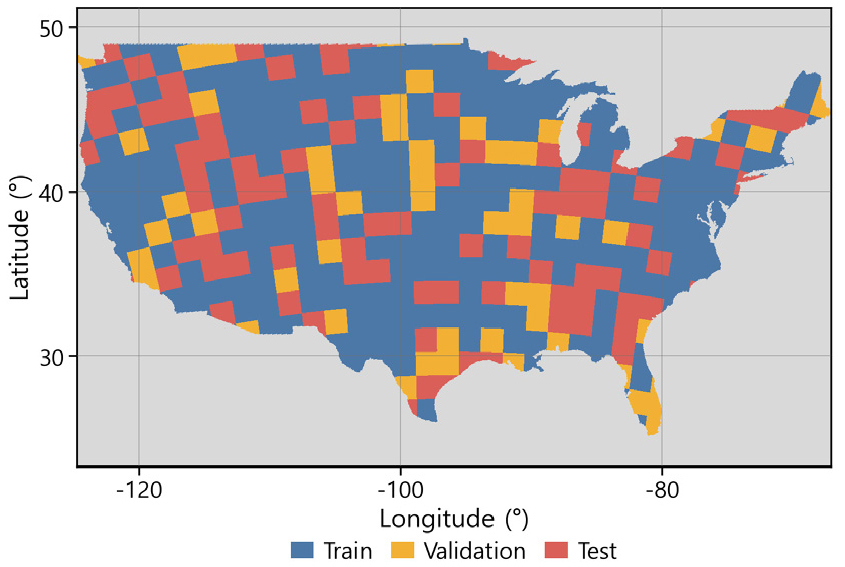
Table 1.
Allocation of patches and grid cells to the training, validation, and test sets
| Split Ratio | Number of Patches | Patches After Augmentation | Number of Grid Cells | |
| Training | 60% | 220 | 1,760 | 753,145 |
| Validation | 15% | 55 | 55 | 179,227 |
| Test | 25% | 92 | 92 | 314,512 |
| Sum | 100% | 367 | 1,907 | 1,246,884 |
U-Net의 학습 패치는 RF 학습에 사용한 격자 속성 벡터보다 훨씬 적은 양이므로 학습자료 불균형을 완화하기 위해 회전(rotation)과 반전(flipping)을 이용한 데이터 증강(data augmentation)을 적용하였다. 각 패치에 대해 0°, 90°, 180°, 270° 회전과 반전을 조합한 8가지 변환을 구성하고, 입력 패치와 기준 유망도 패치 및 유효 격자 마스크에 동일하게 적용하여 공간적 대응 관계를 유지하였다. 검증 및 시험 패치에는 증강을 적용하지 않았다. Table 1에 데이터 분할 비율과 증강 전후의 패치 수, 그리고 격자 셀의 수를 제시하였으며, 증강된 학습 표본은 독립적인 관측자료의 증가로 해석하지 않았다.
최종 기본 입력변수는 방사능 이상 자료 4개, 자기이상 자료 3개, 중력이상 자료 2개, 지질 기원 변수 6개, 암상 변수 8개 및 단층 존재 변수 1개로 총 24개이다. 방사능 이상 자료에는 칼륨, 토륨, 우라늄 및 감마선 흡수선량률(gamma-ray absorbed dose rate) 지표를 포함하였으며, 변수별 정의와 원자료 단위는 Table 2에 정리하였다. 여기에 결측 표시 채널 24개를 더하여 총 48개 입력 채널을 구성하였다. RF와 U-Net에는 동일한 변수 구성을 적용하되, RF는 격자별 속성 벡터를, U-Net은 공간 패치를 입력으로 사용하였다.
Table 2.
Input data types and corresponding variables after preprocessing
모델 구성 및 학습
RF는 격자별 입력 속성 벡터를 이용하여 기준 유망도 값을 개별적으로 추정하도록 구성하였다. 하이퍼파라미터 선정을 위해 Optuna를 이용하여 최적화를 수행하였으며, 검증 집합의 평균제곱근오차(Root Mean Square Error, RMSE)를 최소화하는 조합을 최적 매개변수로 선택하였다. 탐색 대상은 트리 수, 최대 깊이, 노드 분할에 필요한 최소 표본 수, 리프 노드의 최소 표본 수 및 분할 시 고려하는 입력변수의 비율로 설정하였다(Table 3). 총 150회의 탐색을 수행하였고, 각 후보 모델의 성능은 검증용 데이터를 사용하여 평가하였다. 시험용 데이터는 하이퍼파라미터 탐색과 모델 학습에 사용하지 않았다.
Table 3.
Hyperparameter search space for the random forest model
U-Net은 48개 채널로 구성된 64 × 64 격자 패치를 입력 이미지로 받아 각 격자의 기준 유망도 값을 이미지 형태로 추정하는 회귀 모델로 구성하였다. 인코더는 각각 32개와 64개 출력 채널을 갖는 두 단계로 구성하였다. 각 단계에는 3 × 3 합성곱, 배치 정규화(batch normalization), ReLU 활성함수를 순차적으로 적용하는 연산을 두 번 반복한 합성곱 블록을 사용하였다. 각 인코더 단계 이후에는 2 × 2 최대 풀링(max pooling)을 수행하여 공간 크기를 각각 32 × 32와 16 × 16으로 축소하였다. 병목층(bottleneck)에도 동일한 합성곱 블록을 적용하여 16 × 16 격자에서 128개 채널의 특징을 추출하였다. 디코더에서는 보폭(stride)이 2인 2 × 2 전치 합성곱(transposed convolution)을 이용하여 공간 크기를 단계적으로 복원하였다. 복원된 특징 맵은 동일한 공간 크기를 갖는 인코더의 특징 맵과 채널 방향으로 연결한 뒤, 동일한 합성곱 블록을 적용하여 각각 64개와 32개 출력 채널로 변환하였다. 마지막에는 1 × 1 합성곱을 통해 입력과 동일한 64 × 64 공간 크기의 단일 유망도 출력 채널을 생성하였다. 출력층에는 별도의 활성함수를 적용하지 않았다(Fig. 11). 모델 학습에는 Adam 최적화 알고리즘을 사용하였으며, 학습률은 0.001, 배치 크기는 16으로 설정하였다. 손실함수는 유효한 학습 격자의 예측값과 정답 사이의 평균제곱오차(MSE)로 정의하고, 결측 정답 및 패딩 영역은 손실 계산에서 제외하였다. 최대 학습 횟수는 500 에포크(epoch)로 설정하였다. 각 에포크 이후 검증 패치의 예측 결과를 검증 격자에 배치하여 RMSE를 계산하고, 이 값이 가장 작은 모델을 저장하였다. 검증용 RMSE가 50 에포크 동안 연속하여 개선되지 않으면 학습을 조기 종료하였다(Table 4).
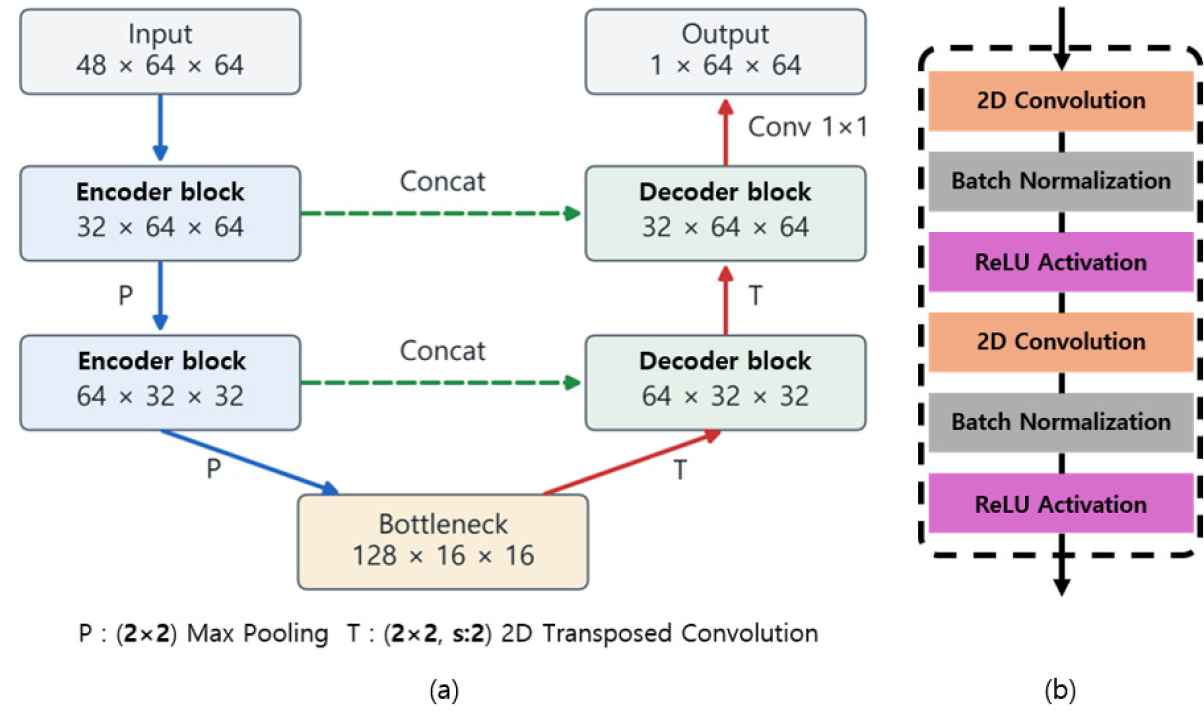
Table 4.
Training settings for the U-Net model
모델 성능 평가
두 모델의 성능은 학습 및 모델 선택에 사용하지 않은 시험용 데이터에서 평가하였다. 값의 재현 오차는 평균절대오차(Mean Absolute Error, MAE), RMSE 및 결정계수(Coefficient of Determination, R2)로 평가하였다. 공간 구조의 유사도는 구조적 유사도 지수(Structural Similarity Index Measure, SSIM)를 이용하여 평가하였다(Wang et al., 2004). 지도 내 공간적 변화 정도는 Total Variation(TV)을 이용하여 검토하였다(Table 5).
Table 5.
Definitions and descriptions of the metrics used to evaluate prospectivity map predictions
Table 5에서 은 시험 격자 수를, 는 기준 유망도 값을, 는 모델의 예측값을, 는 시험 데이터의 기준 유망도 평균을 나타낸다. R2는 모든 시험 격자에 기준 유망도의 평균값을 예측값으로 사용하는 경우와 비교하여 모델의 재현 성능을 나타내며, 모델의 제곱오차 합이 평균값을 사용한 경우보다 크면 음수가 될 수 있다. SSIM에서 와 는 평가 창 내 기준 유망도 값과 예측값의 평균을, 와 는 각각의 분산을, 는 두 값 사이의 공분산을 나타낸다. 과 는 계산을 안정화하기 위한 상수로, 자료 범위를 1로 설정하여 각각 0.012과 0.032으로 정의하였다. 본 연구에서는 격자 수가 7 × 7인 평가 창을 사용하여 SSIM을 계산하였고, 각 평가 창에서 계산된 SSIM의 평균을 최종 지표로 사용하였다. TV에서 는 시험 데이터 내 수평·수직 방향으로 인접한 격자 쌍의 집합이며, 는 해당 격자 쌍의 수이다. 평균 TV는 인접한 예측값 사이의 변화 정도를 나타내므로, 실제 경계나 국지적 변화가 과도하게 완화된 경우에도 낮게 나타날 수 있다. 따라서 TV만으로 예측 정확도나 기준 지도와의 공간 패턴 일치도를 판단할 수는 없다. 본 연구에서는 TV를 예측 지도의 평활화 정도를 설명하는 보조 지표로 사용하고, SSIM 및 오차 지표와 함께 해석하였다.
특성 중요도 분석 방법
두 모델의 입력변수에 대한 의존성을 비교하기 위해 RF와 U-Net에 동일한 순열 특성 중요도(permutation feature importance) 분석을 적용하였다. 순열 특성 중요도는 학습된 모델을 고정한 상태에서 특정 입력변수의 공간적 대응 관계를 교란하고, 이에 따른 예측 오차의 증가량을 측정하는 방법이다. 따라서 해당 변수를 제외하고 모델을 다시 학습하는 방식과는 구분된다.
본 연구에서는 시험용 데이터에서 16 × 16 격자 블록을 구성하여 각 입력변수에 대해 블록 내부의 값 배열은 유지하면서 블록의 위치를 무작위로 재배치하였다. 이때 해당 변수의 결측 표시 채널에도 동일한 재배치를 적용하고, 나머지 입력변수와 기준 유망도 값은 변경하지 않았다. 두 모델에는 동일한 시험 블록과 재배치 순서를 적용하였으며, 각 변수의 교란을 10회 반복하였다. 중요도 평가에 사용한 시험용 데이터 집합을 , 학습된 모델을 , 원래 입력을 , 변수 에 대한 번째 블록 순열을 적용한 입력을 라 하면, 각 반복의 중요도()는 다음과 같이 정의된다.
변수별 중요도는 10회 반복에서 얻은 MSE 증가량의 평균으로 나타내고, 반복 사이의 변동은 표본 표준편차로 제시하였다.
중요도가 양수이면 해당 변수의 교란으로 재현 오차가 증가하였음을 의미하며, 값이 클수록 모델이 해당 입력의 공간적 대응 관계에 크게 의존함을 나타낸다. 음수는 교란 후 오차가 감소한 경우로, 결과에서 임의로 0으로 대체하지 않았다. 기본 입력변수와 결측 표시 채널을 함께 교란하였으므로, 중요도에는 변수값뿐 아니라 해당 자료의 결측 양상에 대한 모델의 의존성도 포함된다.
결과 및 고찰
모델의 천연수소 유망도 예측 성능 비교
학습 및 모델 선택에 사용하지 않은 시험용 데이터에서 RF와 U-Net의 기준 유망도 지도 재현 성능을 비교하였다. 시험 집합에 대한 기준 유망도 값과 예측값의 관계는 Fig. 12에, 정량적 평가 결과는 Table 6에 제시하였다. RF의 MAE와 RMSE는 각각 0.077과 0.101이었으며, U-Net은 각각 0.062와 0.082로 나타났다. 두 모델의 성능을 비교해보면, U-Net의 MAE와 RMSE는 RF 대비 각각 약 19.5%와 18.8% 감소하였고, R2는 RF의 0.626에 비해 U-Net이 0.755로 0.129 높았다. 이러한 결과는 본 실험의 시험용 데이터에서 U-Net이 RF보다 기준 유망도 값을 더 작은 오차로 재현하였음을 나타낸다.
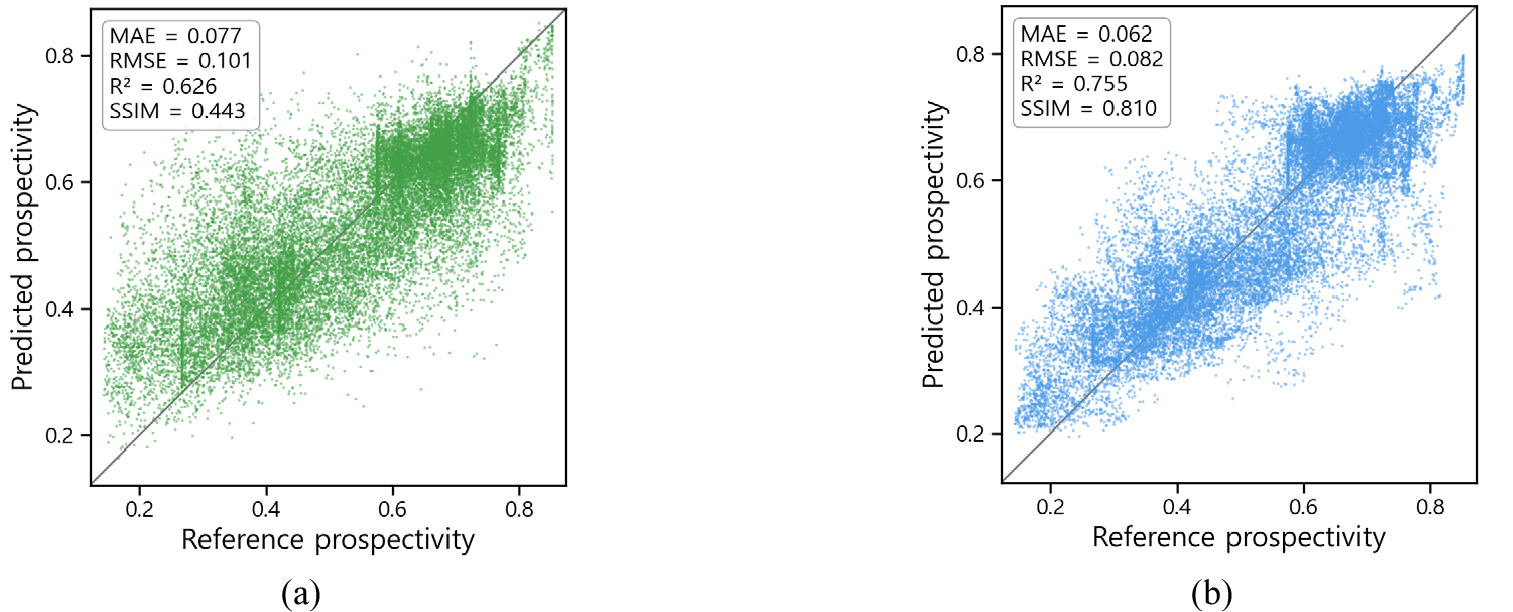
Table 6.
Performance of the random forest and U-Net models on the test set
| MAE | RMSE | R2 | SSIM | TV | |
| RF | 0.077 | 0.101 | 0.626 | 0.443 | 0.02853 |
| U-Net | 0.062 | 0.082 | 0.755 | 0.810 | 0.00455 |
공간 구조의 유사도를 평가한 SSIM은 RF에서 0.443, U-Net에서 0.810으로 나타나 U-Net이 RF보다 0.367 높았다. 이는 시험용 데이터에서 U-Net의 예측 지도가 기준 지도와 국지적인 값의 분포 및 공간 구조 측면에서 전반적으로 더 높은 유사도를 보였음을 의미한다. 따라서 U-Net은 본 시험용 데이터에서 격자별 값의 재현 오차뿐만 아니라 국지적인 공간 구조의 유사도에서도 RF보다 우수한 결과를 보였다.
TV는 RF에서 0.02853, U-Net에서 0.00455로 나타났으며, U-Net이 RF보다 약 84.1% 낮았다. 이는 U-Net의 예측 지도에서 인접 격자 사이의 값 변화가 상대적으로 작았음을 나타낸다. 다만 작은 TV는 실제 경계나 국지적 변화가 과도하게 완화된 경우에도 나타날 수 있으므로, TV 감소만으로 기준 지도의 공간적 연속성을 더 정확히 보존하였다고 판단할 수는 없다. 본 결과에서는 U-Net의 낮은 MAE와 RMSE 및 높은 SSIM을 근거로 기준 지도 재현 성능을 평가하고, TV는 예측 지도의 평활화 정도를 설명하는 보조 지표로 해석하였다.
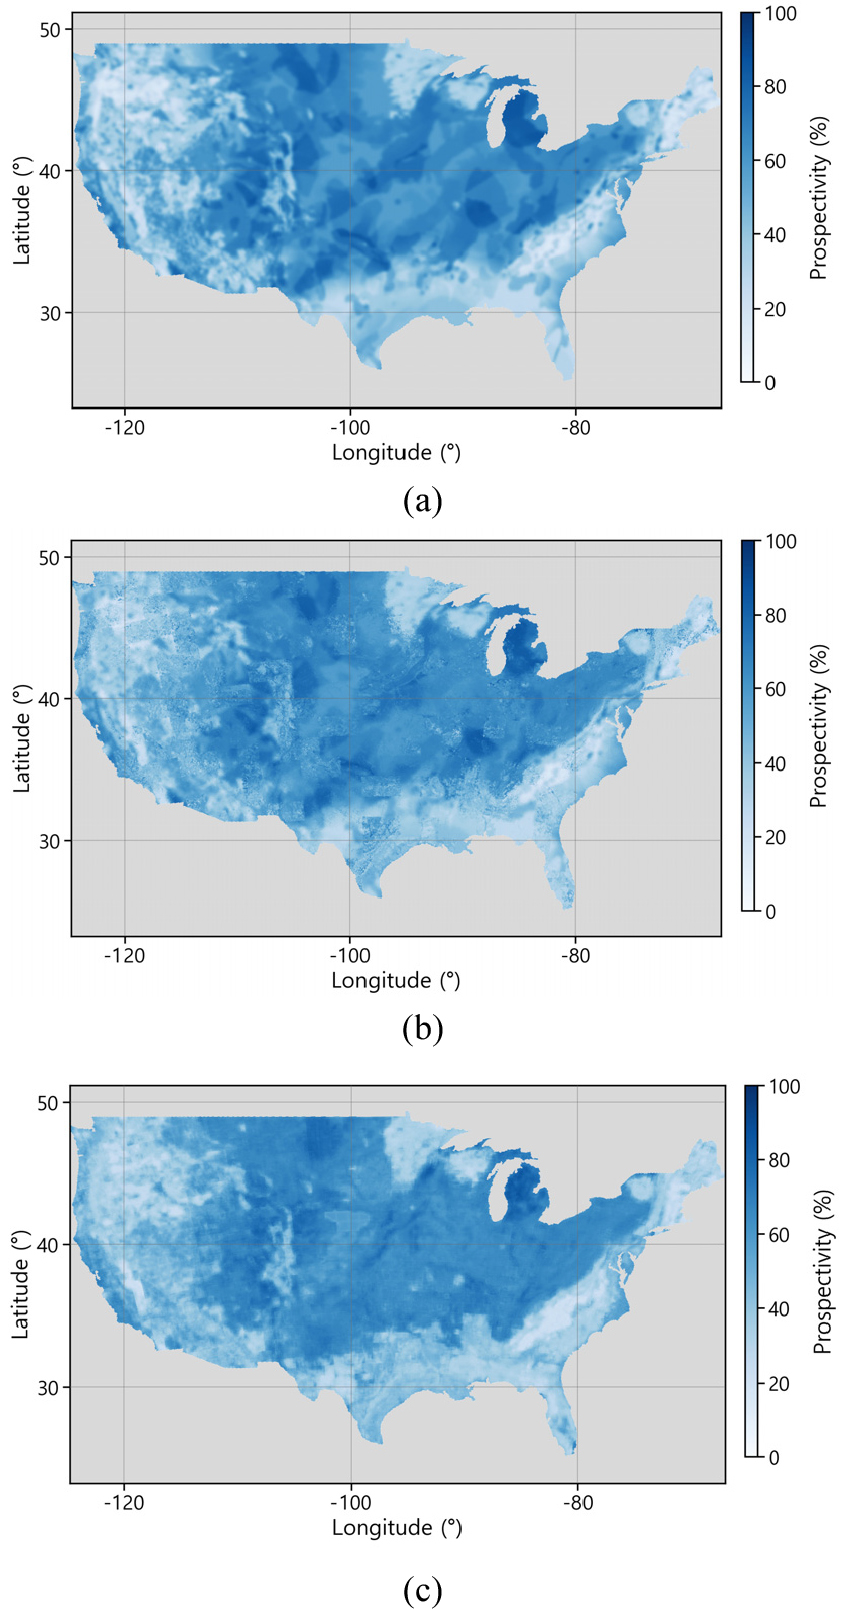
학습·검증·시험 영역을 포함한 전체 연구 지역에서 기준 유망도 지도와 두 모델의 예측 지도를 정성적으로 비교하였다(Fig. 13). 이 비교는 전체적인 예측 분포를 살펴보기 위한 것으로, 학습 및 모델 선택에 사용하지 않은 자료에 대한 성능 평가는 앞서 제시한 시험 집합의 정량적 평가 결과를 기준으로 하였다. 시각적 비교 결과, U-Net은 RF보다 기준 유망도 지도의 주요 분포 형태와 공간적 연결성을 더 유사하게 재현하였다(Fig. 13). RF에서는 주변 격자와 구분되는 고립된 예측값 분포가 나타난 반면, U-Net에서는 이러한 양상이 상대적으로 적고 인접 영역으로 이어지는 분포가 관찰되었다. 이러한 시각적 비교는 시험 집합에서 확인된 U-Net의 낮은 재현 오차와 높은 SSIM 결과에 부합한다. 다만 예측 분포의 평활함 자체가 정확성을 의미하지는 않으므로, 공간적 연결성은 기준 지도에 나타난 경계와 분포 형태를 함께 고려하여 해석해야 한다.
광물 유망도 매핑 분야에서도 합성곱 신경망과 주의집중 기법을 활용하여 공간적 패턴을 학습하는 연구가 수행되어 왔다(Li et al., 2023). Lou and Liu(2023)는 텅스텐 다금속 광상 유망도 평가에서 여러 머신러닝 모델을 비교하여 CNN과 LightGBM이 우수한 성능을 보였다고 보고하였다. 또한 Wang et al.(2026)은 Gejiu 주석 광상 유망도 평가에서 CNN이 RF보다 높은 예측 성능을 보였다고 보고하고, CNN이 복합적인 광상 지배 요인과 공간 패턴을 학습하는 데 활용될 수 있음을 제시하였다. 이러한 선행연구는 유망도 매핑에서 공간적 맥락을 학습하는 방법의 활용 가능성을 보여준다.
다만 본 연구에서 RF는 개별 격자의 속성 벡터를 이용하는 반면, U-Net은 동일한 변수로 구성된 패치에서 주변 격자의 정보를 함께 학습한다. 따라서 관찰된 성능 차이에는 모델 구조와 그에 따른 공간적 맥락 활용 방식의 차이가 함께 반영된다. 본 결과는 이러한 실험 구성에서 U-Net이 기준 지도의 공간 분포를 재현하는 데 유리하였음을 보여주지만, 공간 파생 변수를 추가한 RF와의 비교나 독립 지역 검증을 수행하지 않았으므로 모델 계열의 보편적인 우열로 일반화할 수는 없다. 또한 서로 중첩되지 않는 패치로 자료를 분할했더라도 서로 다른 집합 사이에 공간적 상관성이 남을 수 있으므로, 공간적으로 분리된 독립 지역에 대한 추가적인 성능 검증이 필요하다.
유망도 예측 인자의 특성 중요도
두 모델이 기준 지도를 재현하는 데 활용한 정보의 차이를 살펴보기 위해 블록 순열 특성 중요도 결과를 비교하였다. 앞서 제시한 방법에 따라 각 기본 변수와 대응하는 결측 표시 채널에 동일한 블록 순열을 적용하여 시험 영역의 16 × 16 격자 블록 단위로 재배치하고, 교란 전후의 MSE 차이를 중요도로 산정하였다. 이러한 순열 기반 분석은 예측모델의 입력 의존성을 평가하는 데 사용된다(Breiman, 2001; Fisher et al., 2019). 변수별 교란을 10회 반복하여 얻은 평균과 표준편차를 이용하였으며, 전체 24개 변수의 결과를 Figs. 14와 15 및 Table 7에 제시하였다.
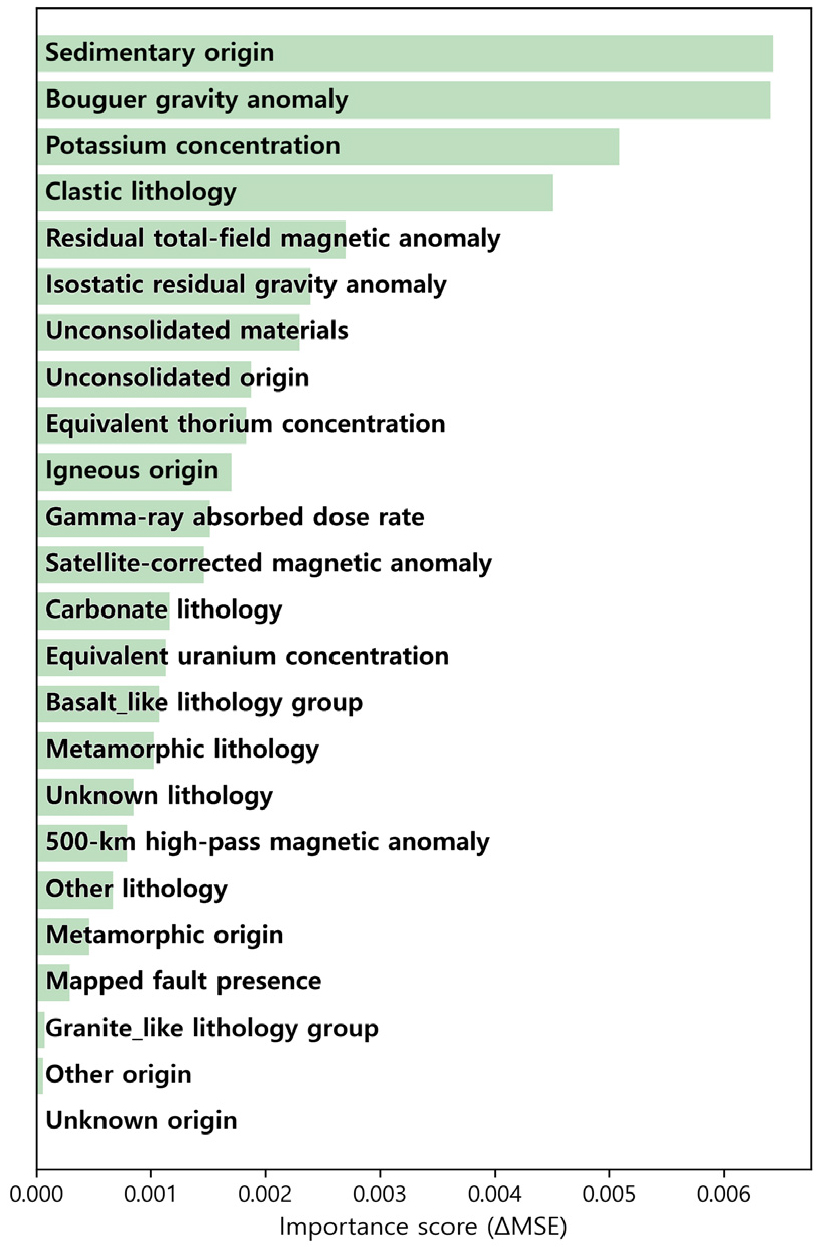
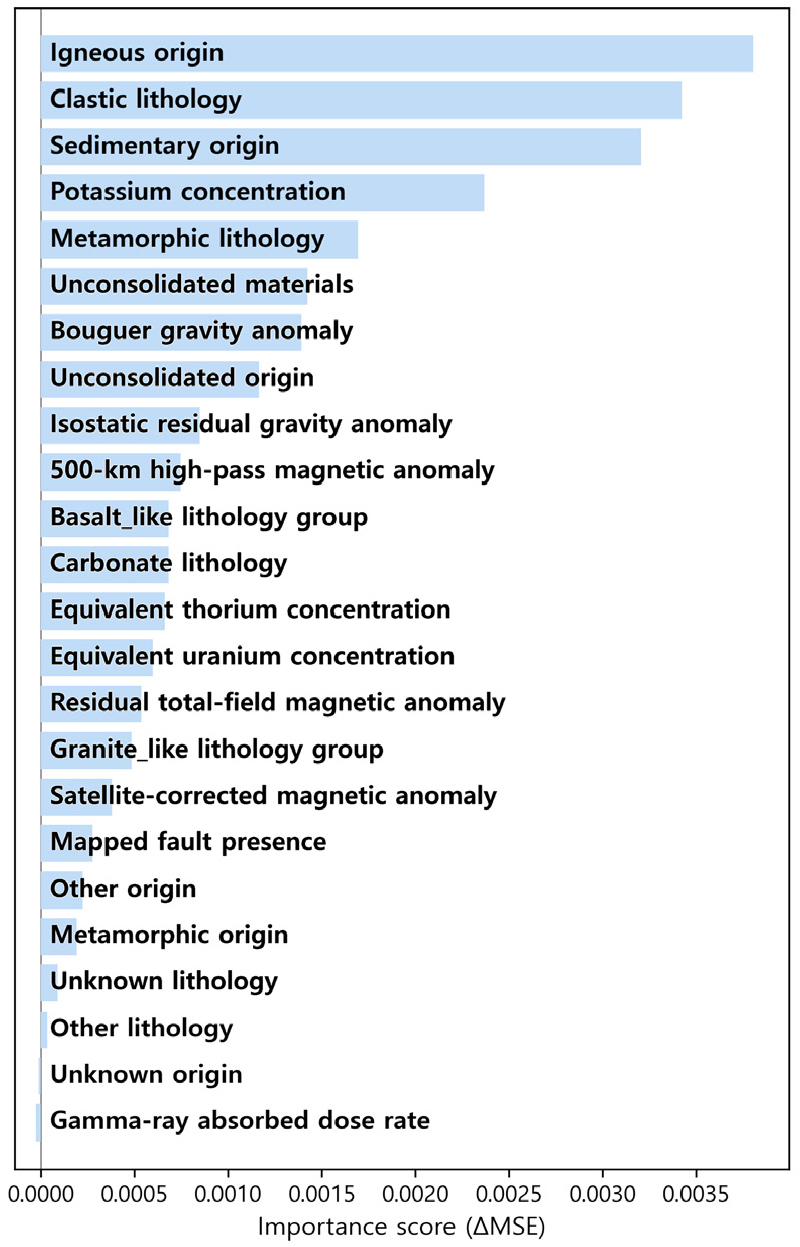
Table 7.
Importance of all 24 base input variables for the random forest and U-Net models. All importance values (ΔMSE) and their standard deviations are reported in units of 10⁻3
RF에서는 퇴적 기원 변수와 부게 중력이상의 평균 중요도가 유사하게 높았다. 순열 반복에 따른 변동성을 고려할 때 미세한 순위 차이보다는 두 변수 모두에서 높은 중요도가 나타났다는 점에 주목하였다. 다음으로 칼륨 농도, 쇄설성 암상 및 잔여 총자기장 이상의 중요도가 높게 나타났다. 이는 RF가 기준 유망도 지도를 재현하는 과정에서 지질 기원과 암상뿐 아니라 중력·방사능·자기 자료에도 의존하였음을 보여준다.
U-Net에서는 화성 기원 변수의 평균 중요도가 가장 높았으며, 다음으로 쇄설성 암상, 퇴적 기원 및 칼륨 농도 순으로 높게 나타났다(Fig. 15). 뒤를 이어 변성 암상, 미고결 암상 및 부게 중력이상 순으로 중요도가 높았다. 따라서 본 실험에서 U-Net은 화성 기원 변수의 공간적 배치를 교란했을 때 재현 오차가 가장 크게 증가하였으며, 쇄설성 암상과 퇴적 기원 등 다른 지질 변수 및 칼륨 농도에도 의존하였다.
두 모델의 중요도 분포를 비교하면, 퇴적 기원과 칼륨 농도 및 쇄설성 암상은 두 모델 모두에서 상위권에 포함되었으나, 변수별 순위에는 차이가 나타났다. RF에서는 퇴적 기원과 부게 중력이상이 가장 높은 중요도를 보인 반면, U-Net에서는 화성 기원이 가장 높았고 쇄설성 암상과 퇴적 기원이 뒤를 이었다. 특히 U-Net에서 가장 높은 중요도를 보인 화성 기원 변수는 RF에서는 상대적으로 낮은 순위에 위치하였다. Fisher et al.(2019)은 예측 성능이 좋은 모델들 사이에서도 특정 변수에 대한 의존성이 달라질 수 있음을 설명하였다. 본 연구에서도 동일한 중요도 산정 방법을 적용했음에도 두 모델에서 서로 다른 중요도 분포가 나타났으며, 이는 각 모델의 입력 변수에 대한 의존성이 다를 수 있음을 보여준다. RF는 격자별 속성 벡터를 이용하고 U-Net은 주변 격자의 공간적 맥락을 함께 이용하므로, 공간 정보의 처리 방식이 이러한 차이에 영향을 주었을 가능성이 있다.
본 분석의 중요도는 주어진 입력 구성과 시험용 데이터에서 나타난 모델의 의존성을 의미하며, 실제 천연수소 생성·이동·집적에 대한 인과적 기여도를 나타내지 않는다. 또한 범주형 채널을 개별적으로 교란하면 원래 자료에 존재하지 않는 범주 조합이 발생할 수 있으며, 결측 표시 채널을 함께 교란하였으므로 중요도에는 자료의 결측 양상에 대한 의존성도 포함될 수 있다. 순열 반복의 표준편차 역시 교란에 따른 변동을 나타내며, 반복 학습이나 기준 지도 자체의 불확실성을 의미하지 않는다. 이러한 특성을 고려하여 중요도 결과를 기준 유망도 지도 재현에 사용된 정보의 상대적 역할로 해석하는 것이 바람직하다.
전문가 의사결정 지원 도구로서의 모델 활용 가능성
앞의 성능 및 중요도 분석 결과를 탐사에 활용하려면 기준 지도의 성격을 함께 고려해야 한다. 천연수소 유망지역 평가에서는 다양한 지질학적·지구물리학적 정보를 종합하는 과정에서 전문가의 해석과 판단이 반영될 수 있으며, 이에 따라 평가 결과에 주관성이 개입될 가능성이 있다(Moretti et al., 2021; U.S. Geological Survey, 2025). 이러한 평가를 보조하기 위해 본 연구에서는 RF와 U-Net 모델을 적용하여 USGS 예비 유망도 지도에 반영된 복합적인 지질학적 평가 패턴을 데이터 기반으로 학습하고, 동일한 입력자료에 대해 일관된 절차로 기준 유망도를 재현할 수 있는지 검토하였다. U-Net은 RF보다 낮은 재현 오차와 높은 구조적 유사도를 보였으며, 기준 지도의 주요 공간 분포를 상대적으로 잘 재현하였다. 이러한 접근은 전문가 판단을 대체하기보다는 기존 평가를 재현하고 비교하는 과정의 일관성과 반복 가능성을 높이는 보조 수단으로 활용될 수 있다.
또한 현장 계측과 심부 시추를 포함하는 천연수소 탐사는 많은 시간과 비용을 필요로 하므로, 광역적인 범위에서 유망지역을 사전에 선별하고 탐사 우선순위를 설정하는 과정이 중요하다(Moretti et al., 2021). 이러한 측면에서 본 연구의 데이터 기반 예측 모델은 추가적인 검증을 거쳐 후속 정밀 탐사의 대상 지역을 검토하는 스크리닝 도구로 활용될 가능성이 있다. 이를 통해 현장 조사와 시추에 앞서 탐사 자원의 배분과 추가 조사 계획을 논의하는 데 참고할 수 있다. 다만 실제 탐사 우선순위 설정에 대한 기여도와 비용 절감 효과를 확인하기 위해서는 독립적인 탐사 자료를 이용한 추가 검증이 필요하다.
이러한 ML 기반 예측 결과는 입력자료의 품질과 공간적 분포, 학습 목표자료의 특성에 크게 의존하며, 학습자료에 포함된 불확실성이나 지리적 편향을 모델이 그대로 반영할 가능성이 있다(Bergen et al., 2019). 특히 본 연구에서 학습 목표로 사용한 USGS 예비 유망도 지도는 전문가의 판단과 확률론적 평가를 통해 구축된 자료이므로(U.S. Geological Survey, 2025), 평가 요소의 선정과 각 요소의 존재 가능성에 대한 판단이 모델의 학습 및 예측 결과에도 반영될 수 있다. 따라서 동일한 절차로 예측을 반복할 수 있다는 점이 기준자료 자체의 주관성을 제거하거나 예측 결과의 객관성을 보장하는 것은 아니라는 점에 주의해야 한다. 모델의 높은 재현 성능 역시 기준 지도와의 일치도를 나타내므로, 이를 실제 천연수소 부존 여부에 대한 직접적인 증거로 해석해서는 안 된다. 이에 ML 기반 유망도 예측 결과는 탐사 의사결정을 지원하는 보조 자료로 활용하고, 최종 유망지역의 선정에는 지질학적 해석, 추가적인 지구물리·지화학 조사 및 독립적인 현장 검증을 종합적으로 적용할 필요가 있다.
결 론
본 연구에서는 미국 본토의 지질·지구물리 자료를 통합하여 RF와 U-Net을 이용한 광역 천연수소 유망도 지도 재현 모델을 구축하고, 동일한 시험용 데이터에서 성능을 비교하였다. U-Net은 RF보다 낮은 재현 오차와 높은 구조적 유사도를 보였으며, 정성적인 지도 비교에서도 고립된 예측값 분포가 상대적으로 적고 기준 지도의 주요 분포 형태를 더 유사하게 재현하였다. 특성 중요도 분석 결과, RF는 퇴적 기원과 부게 중력이상에, U-Net은 화성 기원 변수에 높은 의존성을 보였으며, 두 모델의 입력 변수에 대한 의존성에 차이가 있음을 확인하였다. 이러한 결과는 본 연구 조건에서 공간적 맥락을 함께 학습하는 U-Net이 기준 유망도 지도 재현에 유리할 수 있음을 시사한다. 학습·검증·시험 집합을 분리했음에도 인접한 패치 사이에 공간적 상관성이 남을 수 있으므로, 본 결과를 공간적으로 독립된 지역에 대한 일반화 성능으로 확대하여 해석하기는 어렵다. 또한 전문가가 구축한 기준 지도의 판단과 불확실성이 모델에 반영될 수 있으며, 높은 재현 성능과 특성 중요도가 실제 천연수소 부존 예측 정확도나 지질학적 인과관계를 의미하지는 않는다. 향후에는 반복 실험과 공간적으로 독립된 지역 검증으로 결과의 안정성과 모델의 활용 가능성을 평가하고, 지화학·시추·부존 자료를 이용하여 실제 탐사 활용 가능성을 검증할 필요가 있다. 아울러 서로 다른 지질 환경으로 연구 범위를 확대하고 공간 정보 활용 방식이 다른 다양한 모델을 비교함으로써, 전문가의 탐사 의사결정을 지원하는 광역 천연수소 유망도 매핑 방법론을 발전시킬 수 있을 것으로 기대한다.