

서 론
본 론
최적화 프레임워크의 개요
이중 심층 Q-네트워크
소프트 액터-크리틱
유정배치와 운영조건 최적화를 위한 마르코프 결정과정 구성
제안한 최적화 프레임워크의 학습과정
결 과
기본사례
운영조건 의사결정의 시간간격 변화에 대한 학습된 SAC의 적용
토 의
결 론
서 론
유전개발계획(field development plan, FDP)은 저류층 특성, 시추계획, 생산설비, 경제성 등을 종합적으로 고려하여 수립된다. 이 가운데 유정의 공간적 배치와 시간에 따른 운영은 저류층의 거동과 사업의 수익에 주요한 영향을 미친다. 유정배치는 어느 위치에 어떤 종류의 유정을 언제 시추할 것인지 선택하는 의사결정이다. 운영조건 설정은 전체 유전개발기간 동안 유정의 압력 또는 유량을 조절하는 의사결정이다.
두 의사결정은 저류층 거동에 서로 다른 방식으로 영향을 미친다. 유정배치는 저류층 내 생산정과 주입정의 위치와 간격의 설정으로 유체의 공간분포에 영향을 미친다(Salehian et al., 2021). 운영조건은 시간에 따른 각 유정의 압력 또는 유량의 조절로 저류층의 압력 분포와 유체의 유동 양상을 변화시킨다(van Essen et al., 2009). 따라서 동일한 유정배치에서도 운영조건에 따라 유전의 생산거동과 순현재가치(net present value, NPV)가 달라질 수 있다(Epelle and Gerogiorgis, 2019). 그러므로 사업의 경제성을 극대화하기 위해서는 유정배치 뿐만 아니라 운영조건의 최적화도 수행되어야 한다.
시간의 흐름에 따라 여러 시점에서 순차적으로 의사결정을 내리는 문제는 마르코프 결정과정(Markov decision process, MDP)으로 정식화할 수 있으며, 이를 최적화하는 방법으로 심층강화학습(deep reinforcement learning, DRL)이 적용될 수 있다. 최근에는 유정배치나 운영조건 수립과 같이 복잡한 MDP를 최적화하기 위해 DRL을 활용한 연구가 다양한 분야에서 보고되고 있다(Wang and Tang, 2021; Zhang et al., 2022; Shen et al., 2022; Bogyrbayeva et al., 2023; Jo et al., 2025; Lin et al., 2025).
대표적으로 Bogyrbayeva et al.(2023)은 트럭과 드론을 동시에 활용하여 물품을 배송하는 시간을 최소화하는 문제에 DRL을 적용하였다. Jo et al.(2025)는 DRL을 활용해 3차원 비균질 대수층에서 제약조건을 만족하며 누적 이산화탄소 주입량을 최대화하는 주입계획을 도출하였다. 이 연구에서는 주입정의 공저압력(bottomhole pressure, BHP) 및 단층에서의 평균 압력과 같은 부분적인 관측정보로부터 매 시점마다 주입유량을 결정하였다. 이와 같이 관측된 정보만으로 의사결정에 필요한 정보를 충분히 파악하기 어려운 경우에는, 해당 문제를 부분 관측가능한 MDP (partially observable MDP, POMDP)로 정식화할 수 있다.
현재까지 DRL을 활용한 유정배치와 운영조건의 최적화 연구 사례들은 변수의 유형에 따라 구분할 수 있다. 유정의 위치, 개수, 시추순서와 같은 이산적인 변수들을 다루는 연구들이 수행되었다(Nasir et al., 2021; He et al., 2022; Zhang et al., 2024). 한편 유정의 BHP과 주입유량과 같은 연속적인 변수들을 다루는 연구들도 수행되었다(Wang et al., 2023a; Adeyemi and Onur, 2025; Xin et al., 2025). 최근에는 유정의 종류 변경이나 천공층 차단 여부와 같은 이산변수를, 연속변수인 운영조건과 함께 다루는 시도도 있었다(Wang et al., 2023b; Xin et al., 2026).
즉, FDP의 최적화에 DRL을 적용한 기존 연구 사례들은 유정배치와 운영조건을 각각 독립적인 의사결정으로 다뤄왔으며, 두 의사결정 문제를 하나의 프레임워크 내에서 연계하여 최적화한 연구는 충분히 이루어지지 않았다. 유정배치마다 운영조건 최적화로 경제성이 개선되는 효과가 다를 수 있으므로, 복수의 유정배치 후보에 대해 운영조건을 최적화하고 그 결과를 비교할 필요가 있다.
본 연구에서는 이산적인 유정배치 변수와 연속적인 운영조건 변수에 적합한 두 DRL 알고리즘을 적용하는 순차(sequential) 최적화 프레임워크를 제안한다: 이산변수의 최적화에 적합한 이중 심층 Q-네트워크(double deep Q-network, DDQN) 알고리즘으로 NPV가 높은 유정배치 후보들을 도출하고; 연속변수를 다루기 적합한 소프트 액터-크리틱(soft actor-critic, SAC) 알고리즘으로 각 유정배치 후보의 생산정 BHP와 주입정 물 주입유량으로 표현된 운영조건을 최적화한다.
구체적으로, 유정배치 후보별 운영조건 최적화 전후의 NPV를 비교하여 최적의 유정배치와 운영조건의 조합을 확인한다. 아울러 운영조건에 대한 의사결정 시간간격이 다른 경우에 대해 기 학습한 SAC의 효율 및 fine-tuning을 위한 신경망 초깃값으로의 재사용 가능성을 검토한다.
본 론
최적화 프레임워크의 개요
본 연구에서 제안한 최적화 프레임워크는 Fig. 1과 같이 유정배치 최적화와 운영조건 최적화의 두 단계로 구성된다. 유정배치 최적화 단계에서는 DDQN을 이용하여 유정의 시추여부, 위치, 종류를 의사결정 시점마다 결정한다. 결정된 유정배치를 저류층 모델에 반영하고 시뮬레이션을 수행하여 저류층 압력과 오일포화도, 유체의 생산량과 주입량을 계산한다. 이를 바탕으로 NPV를 계산하여, 유정배치 및 시뮬레이션 결과와 함께 DDQN의 학습에 활용한다. 이 과정을 반복하여 다양한 유정배치를 탐색한 뒤, NPV가 높은 유정배치들을 운영조건 최적화 대상으로 선정한다.
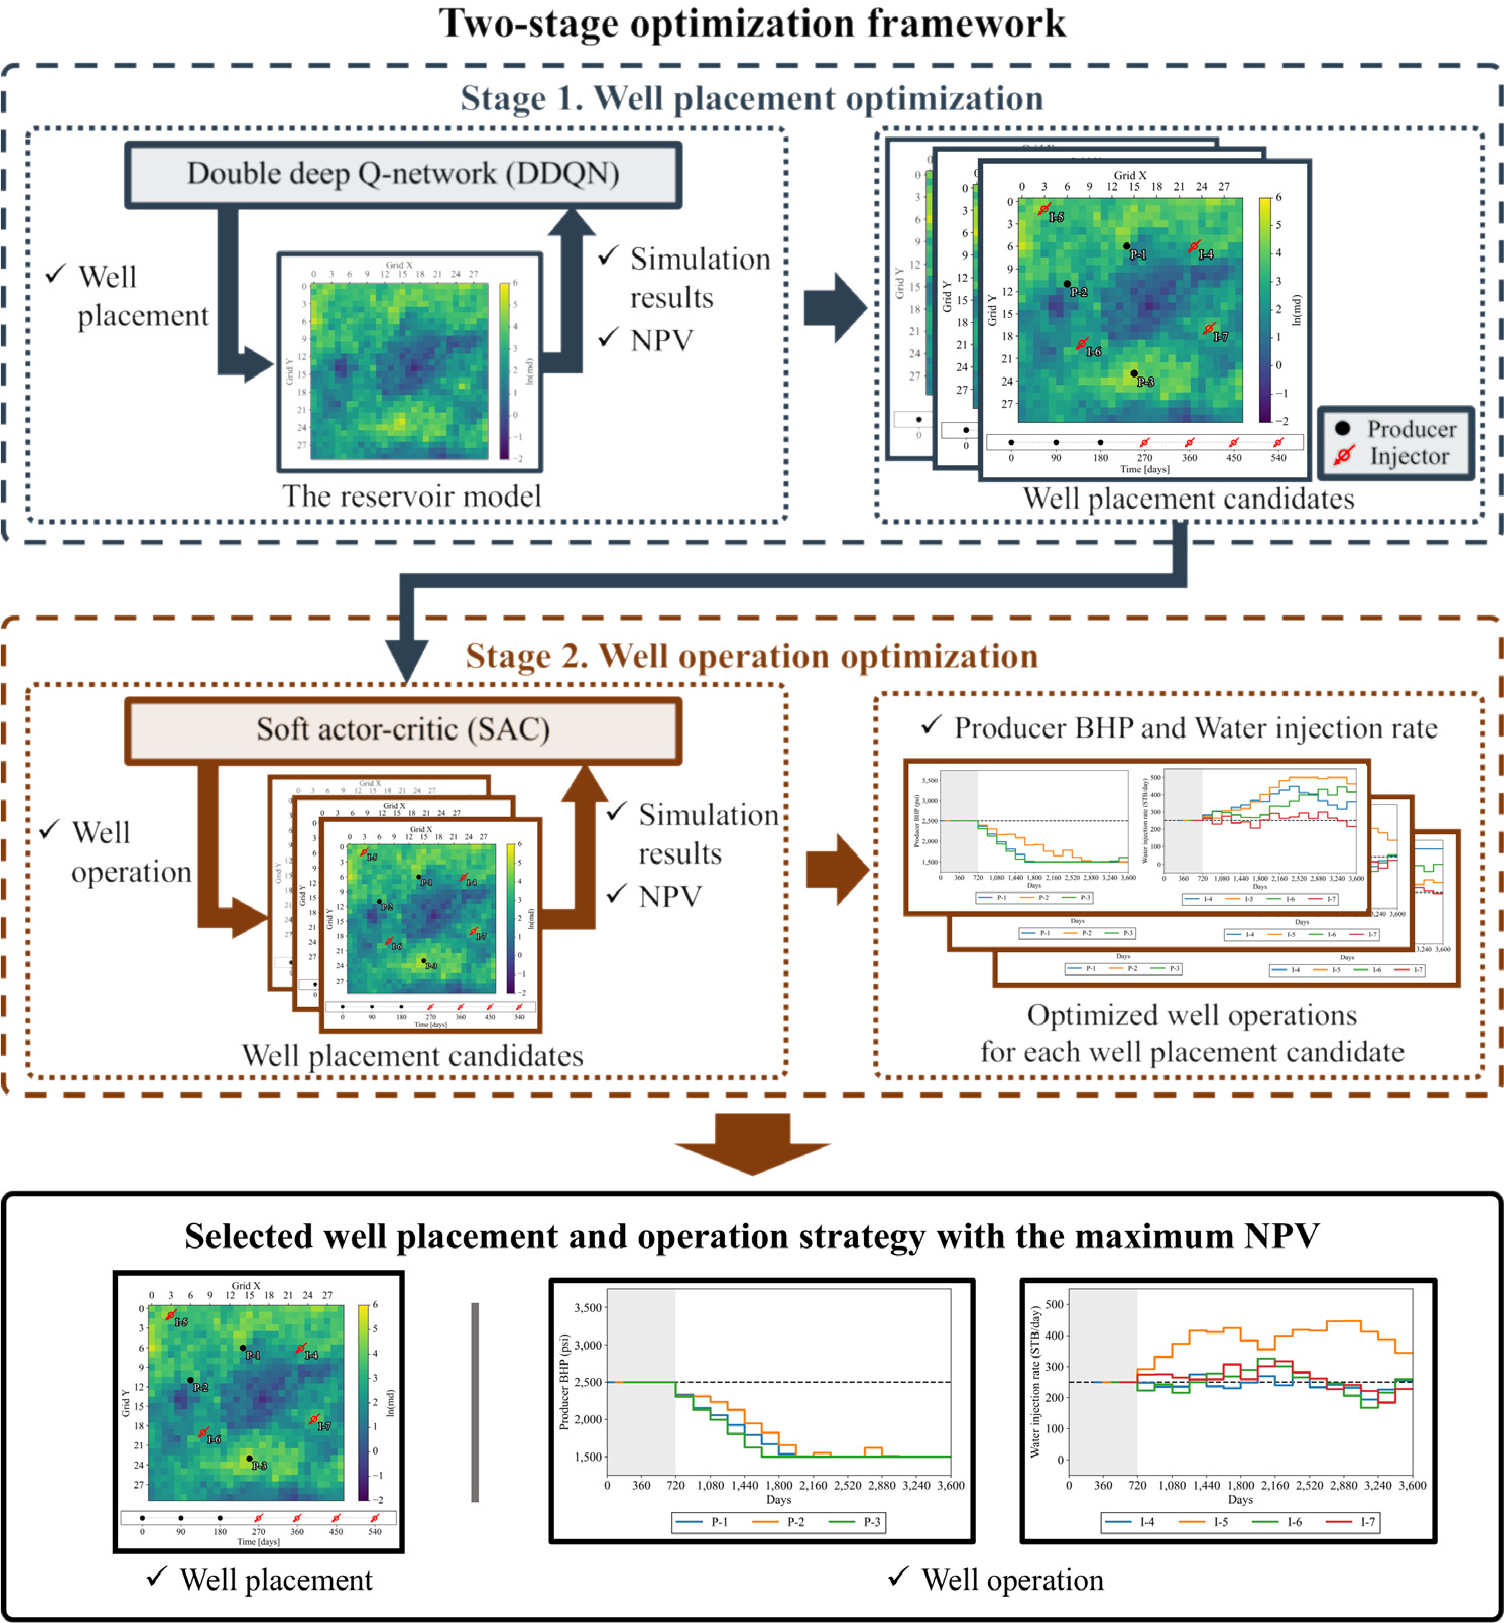
운영조건 최적화 단계에서는 선정된 유정배치 후보들을 대상으로 SAC를 학습한다. SAC는 생산정의 BHP와 주입정의 물 주입유량을 의사결정 시점마다 조절하며 이에 따른 저류층 시뮬레이션 결과와 NPV를 학습에 사용한다. 이러한 과정을 반복하여 각 유정배치 후보별 최적 운영조건을 도출하고 운영조건 최적화 전후의 NPV 개선 정도를 평가한다. 최종적으로 NPV가 가장 높은 유정배치 후보와 그에 대응하는 운영조건을 최적 시나리오로 선정한다.
DRL을 적용하기 위해 각각의 최적화 문제를 에이전트(agent), 환경(environment), 상태(state), 행동(action), 보상 (reward)으로 구성되는 MDP로 표현하였다. 에이전트는 의사결정 시점마다 환경의 상태를 바탕으로 행동을 선택하며, 환경은 선택된 행동을 반영하여 다음 의사결정 시점의 상태와 보상을 에이전트에게 돌려준다. 에이전트는 이러한 환경과의 상호작용을 반복하며 누적되는 보상을 높이도록 행동을 선택하는 규칙을 학습한다. 이어지는 절에서는 DDQN과 SAC 알고리즘을 설명하고, 두 최적화 문제에 사용한 상태, 행동, 보상의 구체적인 구성을 제시한다.
이중 심층 Q-네트워크
DDQN은 주어진 상태에서 이산적인 행동의 가치(Q-가치)를 신경망으로 추정하고 이를 기반으로 행동을 선택하는 DRL 알고리즘이다(van Hasselt et al., 2016). DDQN의 신경망은 Q-가치를 바탕으로 행동을 선택하는 온라인 네트워크와, 학습을 위한 목표값을 계산하는 타깃 네트워크로 구성된다.
온라인 네트워크의 학습을 위해, 의사결정 시점 +1에서 선택 가능한 행동 중 Q-가치가 가장 높은 행동 을 식 (1)과 같이 선택한다.
는 시점 +1에서 선택 가능한 모든 행동의 집합을 의미하며, 은 의 원소이다. 는 시점 +1에서의 상태 로부터, 신경망 파라미터 𝜃를 가지는 온라인 네트워크가 추정한 의 Q-가치이다.
를 사용해 온라인 네트워크의 학습을 위한 목표값을 계산하며, 이를 타깃 Q-가치(target Q-value)라 한다. DDQN의 타깃 Q-가치 는 식 (2)와 같이 계산된다.
는 시점 에서 행동 에 따른 보상을 의미한다. 𝛾는 미래 보상의 중요도를 결정하는 할인인자(discount factor)이다. 는 신경망 파라미터 𝜃-를 가지는 타깃 네트워크가 추정한 Q-가치이다.
온라인 네트워크는 의 Q-가치와 의 차이를 최소화하도록 학습되며, 이는 식 (3)과 같이 표현된다.
는 온라인 네트워크의 목적함수이며, 는 기댓값 연산을 의미한다. 한편 타깃 네트워크는 온라인 네트워크의 파라미터를 일정한 학습 주기마다 전달받아 갱신된다. 본 연구에서 사용한 DDQN의 신경망 구조와 학습설정은 Kim et al.(2026)을 따른다.
소프트 액터-크리틱
SAC는 행동을 선택하는 액터(actor)와 선택된 행동의 Q-가치를 평가하는 크리틱(critic)을 사용하는 DRL 알고리즘으로, 높은 보상 합을 얻으면서도 행동 선택의 다양성을 유지하도록 학습된다(Haarnoja et al., 2018). SAC의 액터와 크리틱의 목적함수를 구성하는 전체 학습 목표 는 식 (4)와 같이 나타낼 수 있다.
여기서 𝜋는 정책으로, 주어진 상태에서 행동에 대한 확률분포를 의미한다. 는 마지막 의사결정 시점을 뜻한다. 는 𝜋에 따라 액터가 환경과 상호작용하며 형성하는 상태와 행동의 분포이다. 는 에서 𝜋의 엔트로피로, 행동에 대한 확률분포가 행동공간에 퍼진 정도를 나타낸다. 𝛼는 엔트로피의 중요도를 조절하는 온도계수(temperature coefficient)로, SAC의 학습과정에서 갱신된다.
SAC는 일반적으로 서로 독립적인 두 개의 크리틱을 사용하며, 이를 학습하기 위해 두 개의 타깃 크리틱(target critic)으로 SAC의 타깃 Q-가치 를 식 (5)와 같이 계산한다. 여기서 를 계산하기 위한 은 식 (6)과 같이 얻는다.
여기서 는 신경망 파라미터 를 가지는 타깃 크리틱이 추정한 Q-가치를 의미한다. 는 크리틱 및 타깃 크리틱의 인덱스로 1 또는 2이다. 는 신경망 파라미터 𝜙를 가지는 액터가 정의하는 정책이며, 은 에서 의 조건부 확률밀도이다. 은 에서 액터가 정의한 정책을 의미한다.
각각의 크리틱은 식 (7)과 같이 목적함수 를 최소화하도록 갱신된다.
여기서 는 신경망 파라미터 를 가지는 크리틱이 추정한 Q-가치이다. SAC의 학습 안정성을 높이기 위해, 각 타깃 크리틱의 파라미터를 대응하는 크리틱의 갱신된 파라미터와의 가중합으로 갱신하여 의 변화를 줄인다.
액터는 식 (8)과 같은 목적함수 을 최소화하도록 학습된다.
식 (8)에 따르면 액터는 높은 Q-가치를 가지는 행동 영역에 더 높은 확률밀도를 부여하도록 학습되며, 특정 행동 부근에 확률밀도가 지나치게 집중되는 것을 방지하기 위해 엔트로피 관련 항인 을 함께 고려한다. 본 연구에서 사용한 SAC의 액터, 크리틱 및 타깃 크리틱의 신경망 구조는 Appendix에 수록하였다.
유정배치와 운영조건 최적화를 위한 마르코프 결정과정 구성
본 연구에서는 유정배치와 운영조건의 최적화 문제를 각각의 MDP로 구성하여 DRL 알고리즘을 적용하였다. Kim et al.(2026)의 2차원 가상 저류층 모델을 사용하고, 유정배치 MDP의 환경, 상태, 행동, 제약조건, 보상을 해당 연구와 동일하게 정의하였다. 이를 바탕으로 본 연구의 운영조건 MDP에서는 유정의 운영정보를 상태에 반영하고, 생산정의 BHP와 주입정의 물 주입유량의 변화량을 행동으로 정의하였다.
이하의 본문에서는 저류층 모델과 두 MDP의 환경 및 상태를 “환경과 상태” 절에서, 행동의 정의와 제약조건을 “행동” 절에서 설명한다. NPV의 계산 방법과 보상은 “보상” 절에서 소개하고, 이어서 제안한 프레임워크의 학습과정을 제시한다. 설명의 편의를 위해 앞으로 유정배치는 WP(well placement), 운영조건은 WO(well operation)로 기술한다.
환경과 상태
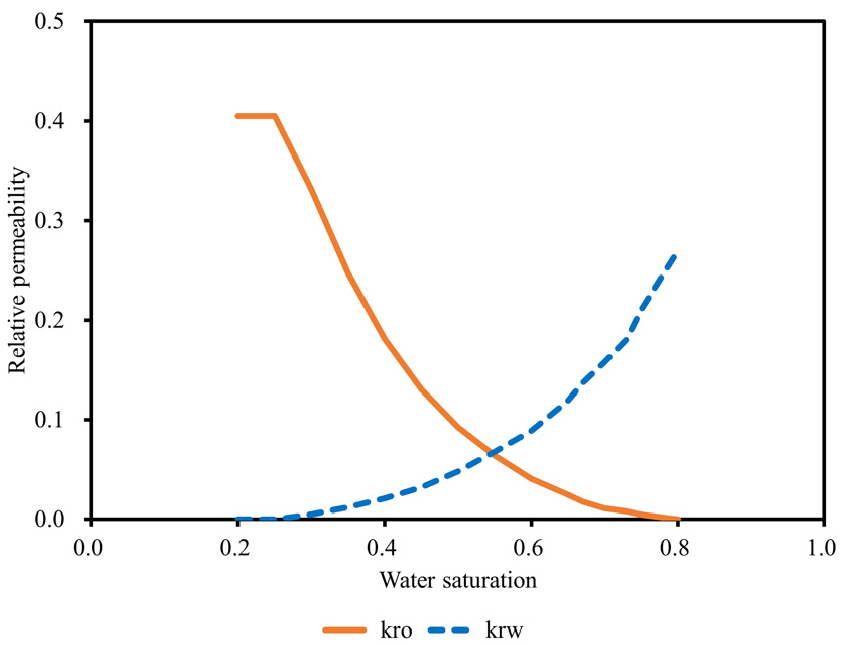
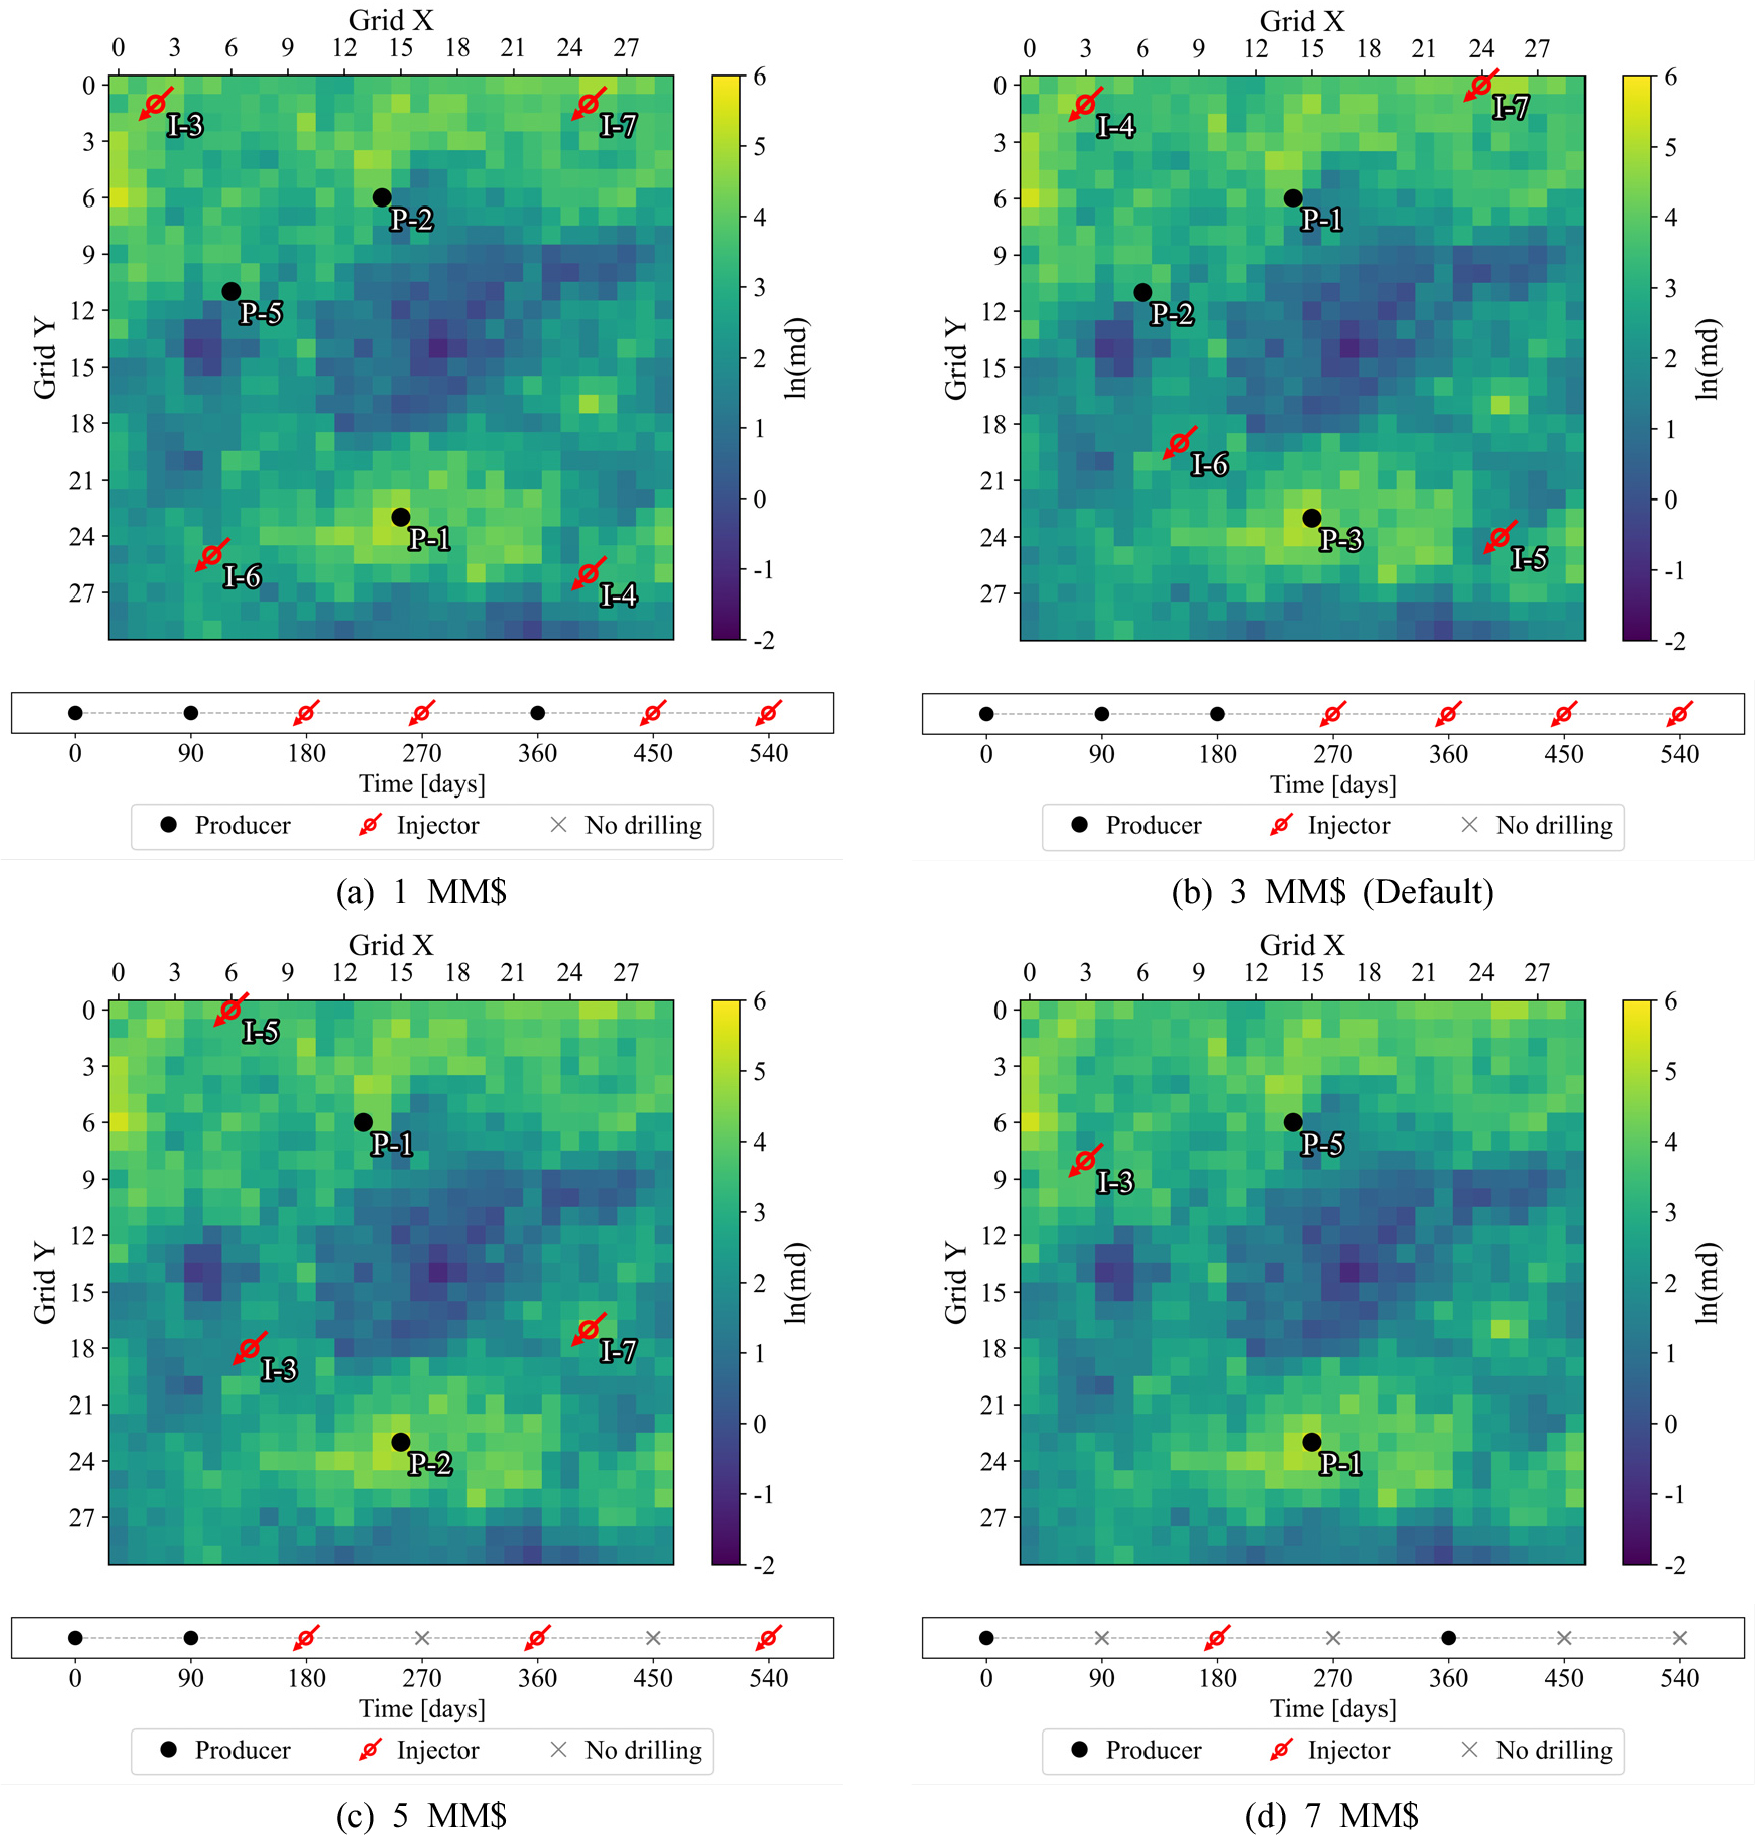
WP MDP와 WO MDP의 환경은 Fig. 2와 같은 2차원 저류층 모델을 기반으로 구성하였으며 각각 저류층 모델과, WP 최적화 이후 선정된 각 WP 후보를 모델에 적용한 것으로 정의하였다. Fig. 2는 저류층 모델의 격자 구조와 유체투과율 분포를 보여준다. 본 연구에서 사용한 저류층 모델은 가로 및 세로 방향으로 각각 30개의 격자로 이루어진다. 의사결정 시점에서의 격자별 압력과 오일포화도, 유체의 생산량 및 주입량은 CMG사의 IMEX(CMG, 2025) 프로그램을 사용하여 계산하였다. 저류층 모델의 주요 물성은 Appendix의 Table A.1과 Fig. A.1에 제시하였다.
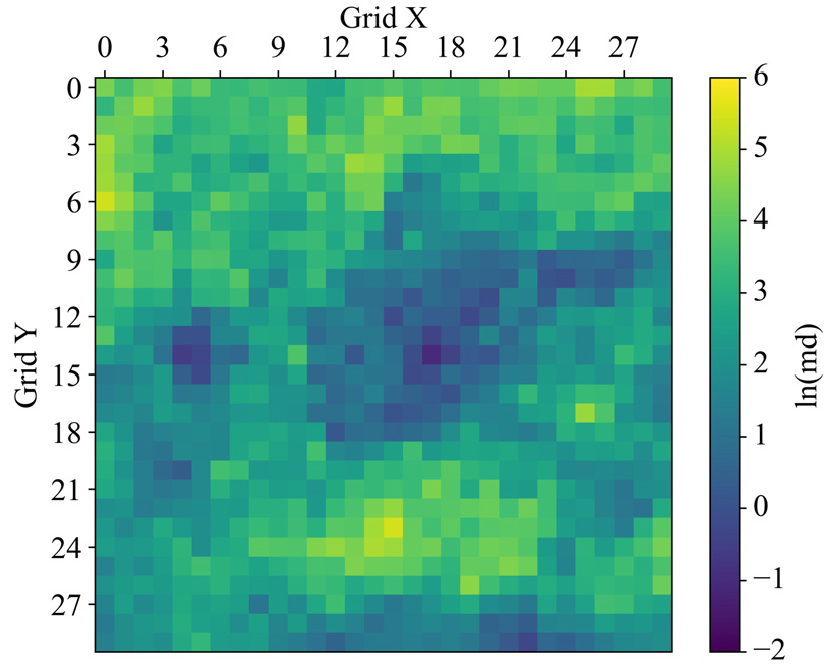
두 MDP의 상태를 구성하기 위해 저류층의 압력, 오일포화도, 로그-유체투과율, WP 정보와 위치 인코딩(Vaswani et al., 2017)을 사용하였다. WP 정보는 각 격자에서의 값으로 유정의 시추여부, 위치, 종류를 구분하도록 유정이 없는 격자를 0, 생산정과 주입정이 위치한 격자를 각각 1과 –1로 설정하였다. 위치 인코딩은 의사결정 시점에 대한 시간 정보를 상태에 반영하기 위해 사용하였으며, 각 시점에 대응하는 사인 및 코사인 함수값을 네 개의 채널로 구성하였다.
WO MDP에서는 앞서 언급한 정보를 현재 시점을 포함한 최근 4개의 의사결정 시점에 대해 구성하고, 이를 채널 방향으로 중첩하여 상태를 정의하였다. 만약 필요한 이전 시점의 정보가 부족한 경우에는 이용 가능한 정보 중 가장 이전 시점의 것을 반복하여 사용하였다. 아울러 서로 다른 WP와 각 유정의 운영정보를 상태에 함께 반영하기 위해 WP 정보를 수정하였다: 생산정이 위치한 격자에서는 water cut 값을 부여하고; 주입정이 위치한 격자에는 현재 시점까지의 누적 물 주입량을 최대 누적 물 주입량으로 나누어 정규화한 뒤 음의 부호를 부여하여 –1에서 0 사이의 값으로 표현하였다.
행동
WP MDP의 행동은 각 의사결정 시점마다 특정 격자에 생산정 또는 주입정을 시추하거나, 시추하지 않는 것으로 정의하였다. WP의 제약조건으로 선행연구를 참고하여 유정들 사이 및 생산정과 저류층 경계까지의 거리가 최소 745 ft이 되도록 설정하였다(Kim et al., 2019; Son et al., 2023). 또한 첫 번째로 시추되는 유정은 반드시 생산정으로 설정하였다. 제약조건을 만족하지 않는 행동은 행동 마스킹을 통해 선택 대상에서 제외하였다(Huang and Ontañón, 2020).
WO MDP의 행동은 생산정의 BHP와 주입정의 물 주입유량의 변화량으로 정의하였다. 이를 통해 각 의사결정마다 탐색하는 WO의 범위를 직전 시점의 WO 주변으로 제한하여 학습과정에서 행동의 탐색 부담을 줄이고자 하였다.
SAC의 액터는 각 유정에 대응하는 정규분포의 평균과 로그–표준편차를 출력한다. 이들로 정의된 정규분포에서 값을 추출하고, hyperbolic tangent 함수를 적용하여 –1에서 1 사이의 값 를 얻는다. 이어서 식 (9)의 선형변환을 에 적용하여 각 유정의 BHP 또는 물 주입유량의 변화량 를 계산한다.
여기서 과 는 생산정의 BHP 또는 물 주입유량 변화량의 하한과 상한이다. 계산된 를 직전 시점에 적용된 WO에 더하여 현재 시점에 적용할 값을 결정하며, 이 값이 WO의 허용범위를 벗어날 경우 허용범위의 최솟값 또는 최댓값으로 제한하였다. 생산정 BHP와 물 주입유량의 초기값, 변화량의 하한과 상한, 허용범위는 기본사례의 실험설정 절에서 제시한다.
보상
두 MDP의 보상은 식 (10)과 같이 NPV를 기반으로 구성하였다. WP MDP의 보상은 각 의사결정 시점과 전체 유전개발기간의 NPV를 함께 고려하도록 식 (11)과 같이 정의하였다. WO MDP의 보상은 다음 행동까지 발생한 NPV로 식 (12)와 같이 구성하였다.
여기서 는 NPV 평가시점을 나타내며, 는 -1번째부터 번째 시점까지의 NPV이다. , , 는 각각 -1번째부터 번째 시점까지의 오일 생산량, 물 생산량, 물 주입량이다. , , 는 각각 오일 가격, 물의 처리비용, 물의 주입비용이다. 은 유정의 시추비용이며, 만약 -1번째 시점에서 유정을 시추하지 않았으면 은 0이다. 는 연간 할인율이며, 는 연속된 두 시점 사이의 시간간격을 의미한다.
식 (11)과 (12)에서 는 의사결정 시점을 의미하며, 와 는 각각 WP 및 WO MDP에서 번째 행동에 따른 보상을 뜻한다. 와 는 계산된 보상의 전체 규모를 결정하는 상수이다. 𝜆는 전체 유전개발기간의 NPV가 보상에 반영되는 정도를 조절하는 계수이며, 는 마지막 NPV 평가시점이다. 본 연구에서 , , 𝜆는 각각 10-6, 0.5, 0.3으로 설정하였다. NPV 계산에 사용한 경제성 인자의 값은 이후 기본사례의 Table 1에서 제시하였다.
제안한 최적화 프레임워크의 학습과정
제안한 최적화 프레임워크에서는 WP 최적화 단계에서 수립된 WP 중 NPV 기준 상위 10개를 WP 후보로 선정한다. 이어지는 WO 최적화 단계에서는 선정된 WP 후보들을 대상으로 SAC를 학습한다. 두 최적화 단계에서는 각 의사결정 시점의 상태, 행동, 보상 및 다음 시점의 상태를 묶어 하나의 경험(experience)을 구성한다. 생성된 경험은 각 알고리즘의 재현 메모리(replay memory)에 저장되어 학습에 사용된다. SAC는 재현 메모리에 512개의 경험이 확보된 이후부터 새로운 경험 8개가 생성될 때마다 64개의 경험으로 구성된 미니배치를 추출하여 학습된다.
WP 최적화 단계에서는 3,000회의 저류층 시뮬레이션을 수행하며 DDQN을 학습하였다. WO 최적화 단계에서는 SAC를 학습할 때 각각의 WP 후보마다 150회의 저류층 시뮬레이션을 수행하였다. 이에 따라 WO 최적화 단계에서 수행된 저류층 시뮬레이션 횟수는 1,500회이다.
결 과
기본사례
실험설정
본 연구의 기본사례에서는 환경과 상태 절에서 제시한 2차원 가상 저류층 모델에서, 90일 간격으로 유정의 시추여부, 위치, 종류를 7차례 결정한다. 이후 유전개발 시작 후 720일이 되는 시점부터 180일 간격으로 WO를 결정하며 3,600일까지 유전을 개발한다. Table 1은 각 MDP의 의사결정 및 WO에 관한 설정과 경제성 인자를 요약하여 보여준다. 본 연구의 경제성 인자는 Kim et al.(2021)과 Son et al.(2023)을 참고하여 설정되었다. WO 최적화에서는 생산정의 BHP를 1,500~3,500 psi, 주입정의 물 주입유량을 0~500 STB/day의 범위에서 조절한다. 각 의사결정 시점마다 허용되는 WO의 변화량은 각각 –200~200 psi와 –50~50 STB/day이다.
Table 1.
Parameters of the WP and WO MDPs in the base case
실험결과
Fig. 3은 WP와 WO 최적화 단계에서 각 저류층 시뮬레이션마다 얻은 NPV와 이에 10회 구간의 이동평균을 적용한 결과를 보여준다. WP 최적화 단계에서는 DDQN의 학습 초기에 0 MM$ 수준이었던 NPV가 후반부에는 50 MM$ 수준까지 증가하였다. WO 최적화를 위한 WP 후보는 주로 학습 중반부터 후반부에 수립되었다. WO 최적화 단계에서도 NPV가 55 MM$에서 70 MM$ 수준으로 증가하였다. 이러한 결과는 학습이 진행되면서 DDQN과 SAC가 더 높은 NPV를 보이는 WP와 WO를 도출하였음을 보여준다.
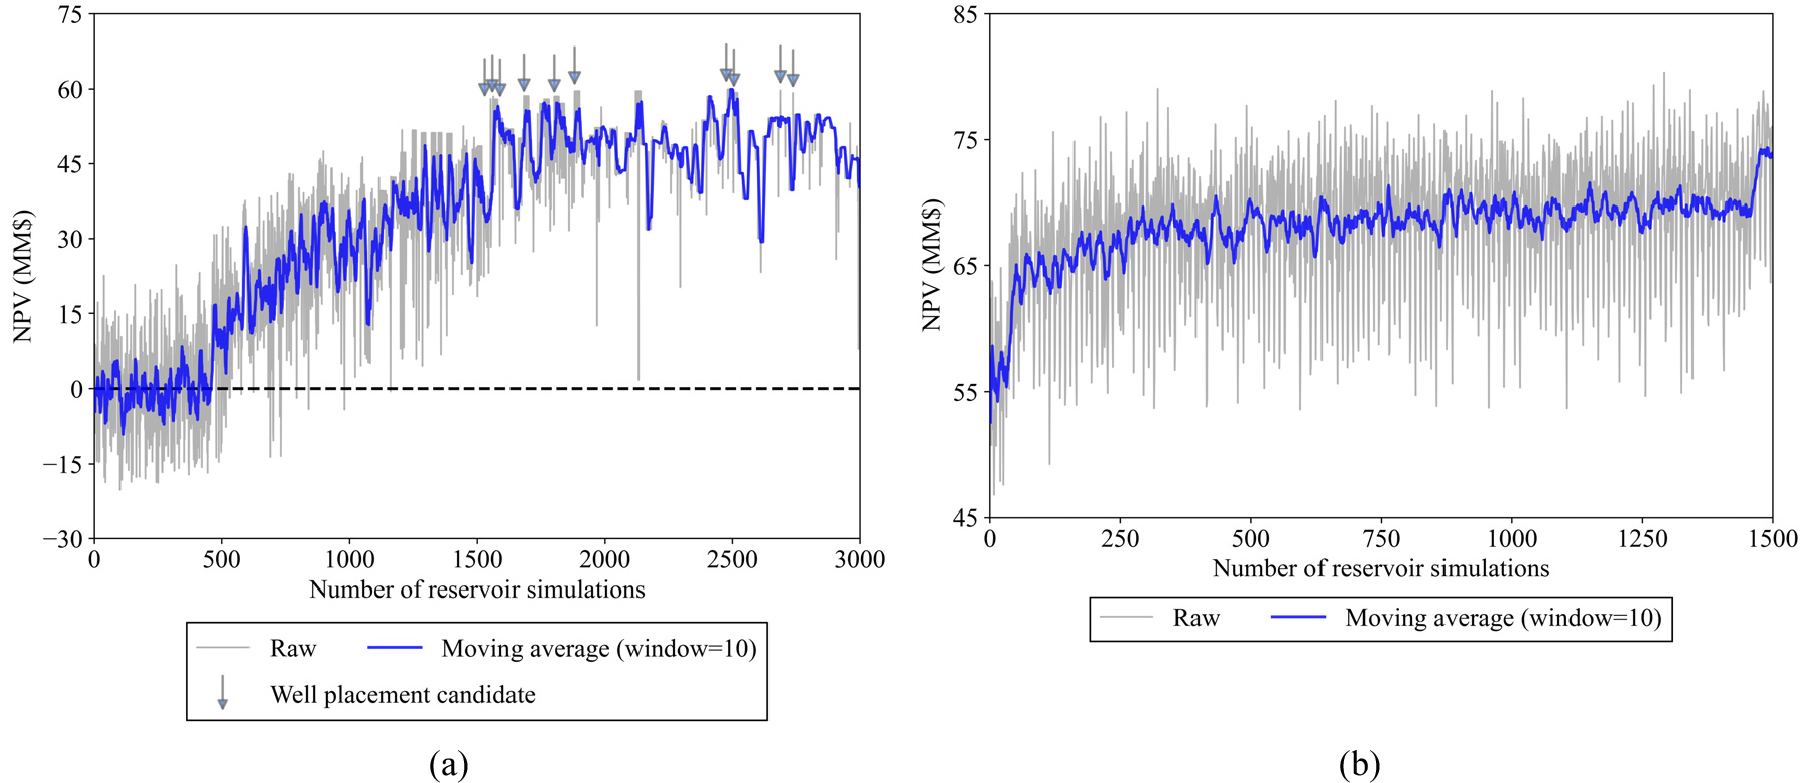
Fig. 4는 WP 최적화 이후 선정된 10개의 WP 후보에 대해 WO 최적화 전후의 NPV 분포를 비교한다. WP만 최적화한 경우(WP-only)의 NPV는 57.9~59.9 MM$인 반면 WO 최적화도 수행한 결과(WP with WO)의 NPV는 67.8~80.3 MM$로 15.7~34.6% 증가하였다. WO 최적화 이후 WP 후보들의 NPV는 평균적으로 28.3% 증가하였으며, WO 최적화 후 NPV의 최솟값도 WP-only의 최댓값보다 높았다.
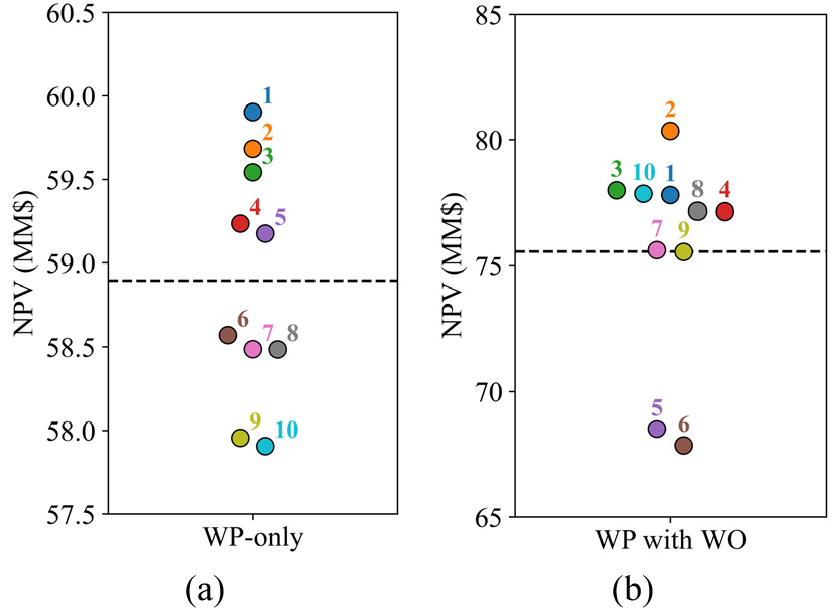
WP-only에서의 2위 후보(이하 WP rank 2)는 Fig. 4(b)에서와 같이 WP with WO에서 가장 높은 NPV인 80.3 MM$을 달성하였다. 반면 WP-only에서 1위 후보(이하 WP rank 1)는 WO 최적화 이후의 NPV가 77.8 MM$로 4위로 확인되었다.
Figs. 5, 6, 7과 Table 2는 WP rank 1과 2에 대한 WO 최적화 전후 결과를 비교한다. 먼저 Figs. 5(a)와 (c)는 두 후보의 유정배치와, WP-only에서의 유전개발 종료시점의 오일포화도 분포를 보여준다. 생산정은 검은색 마커와 P로, 주입정은 붉은색 마커와 I로 표시하였으며, 각 유정의 이름 내 숫자는 의사결정 시점을 의미한다. 두 후보 모두 3개의 생산정을 저류층의 상부, 좌측, 하부 중앙에 동일한 위치와 순서로 시추하였다. 이어서 시추된 4개의 주입정은 일부 위치와 시추순서에 차이를 보였다. 저류층 좌측 상단의 주입정은 WP rank 1에서는 4번째, WP rank 2에서는 5번째로 시추되었다. 저류층 우측 영역에서는 WP rank 1에서 I–5와 I–7이 각각 하단과 상단의 경계 부근에, WP rank 2에서 I–4와 I–7은 상대적으로 저류층 내부에 배치되었다. WP-only에서 WP rank 1과 2의 NPV는 각각 59.9 MM$와 59.7 MM$로, 0.2 MM$의 근소한 차이를 보였다.
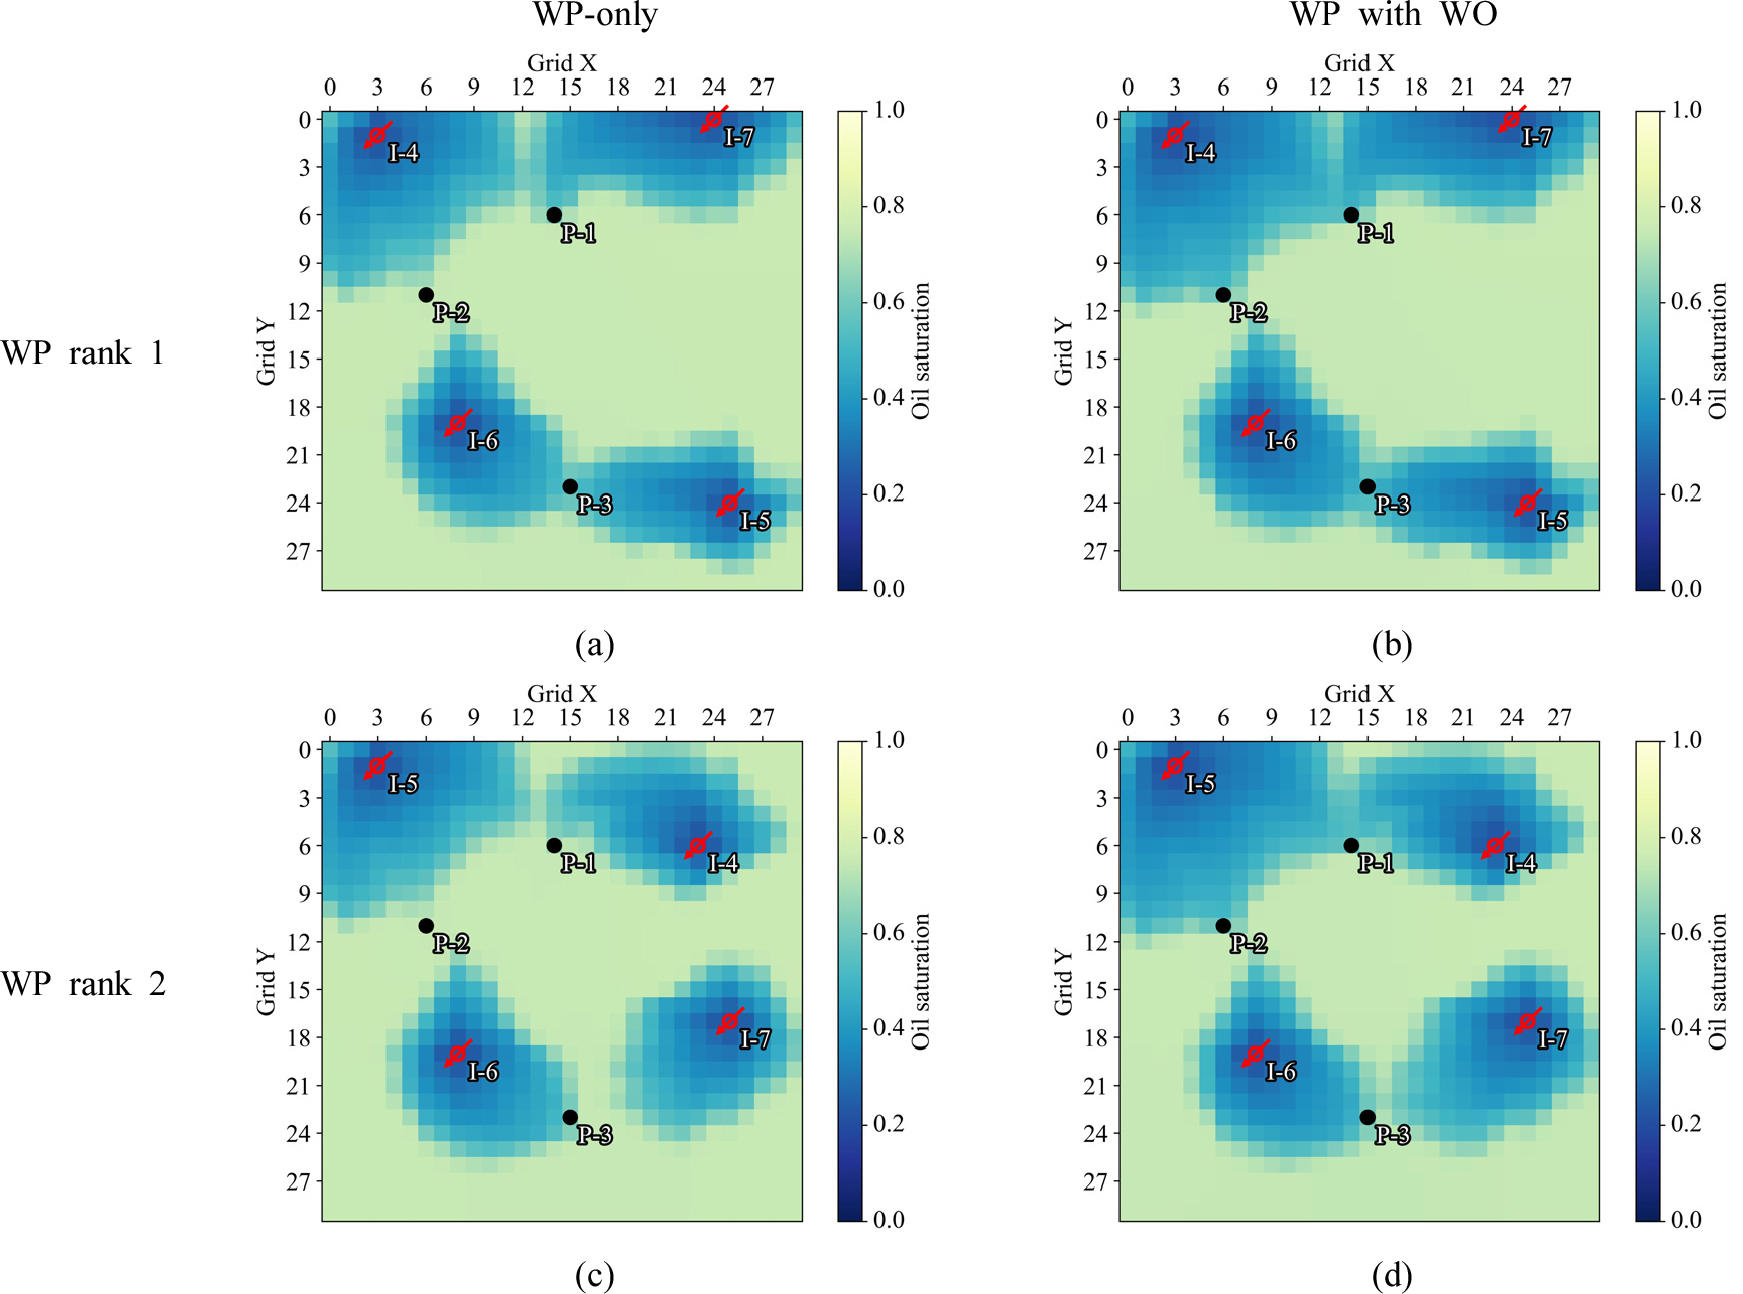
Fig. 5.
Oil saturation at the end of field development for the selected WP candidates: (a, b) before and after WO optimization, respectively, for WP rank 1; and (c, d) before and after WO optimization, respectively, for WP rank 2. P and I denote producers and injectors, respectively. Numbers in the well labels indicate the decision time indices.
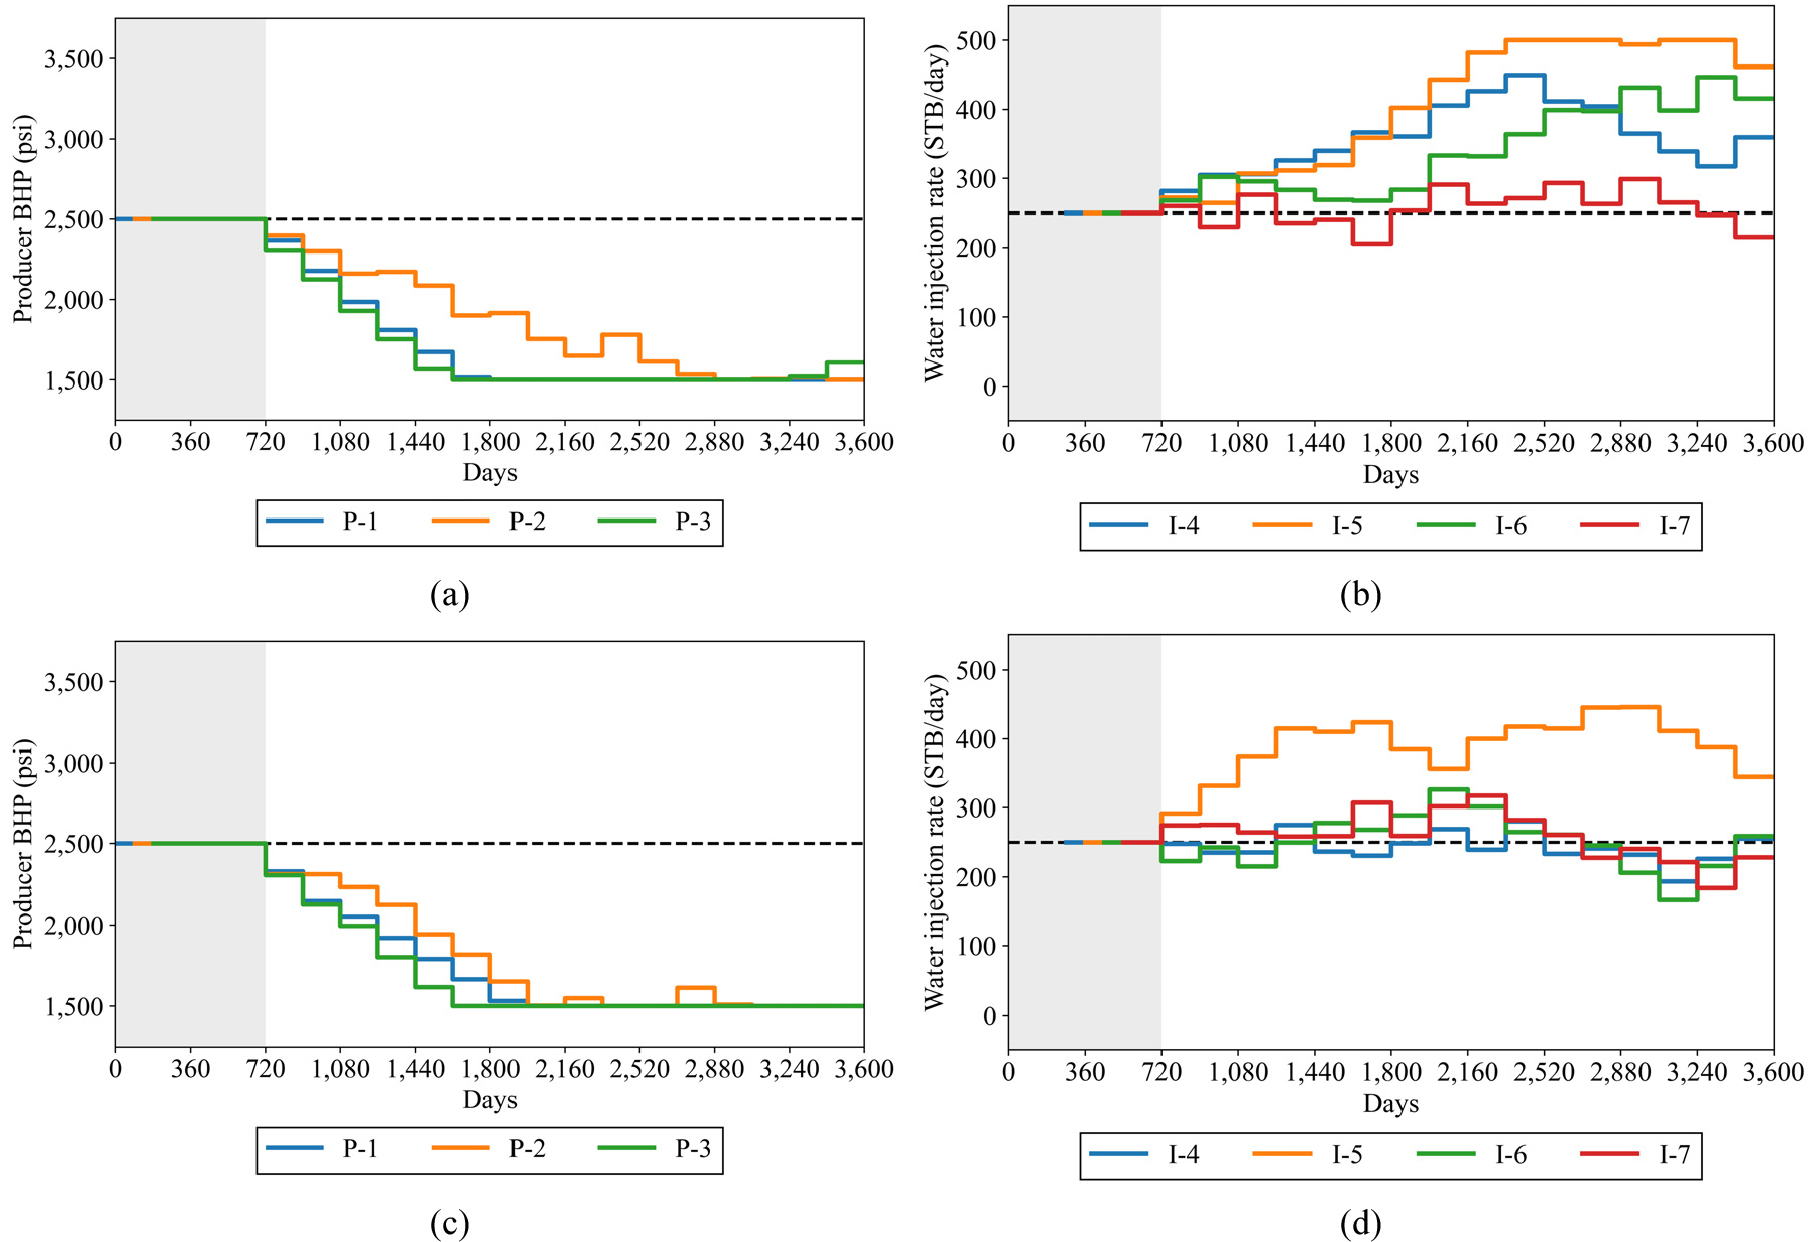
Fig. 6.
Optimized WO schedules for the selected WP candidates: (a) producer bottomhole pressure (BHP) and (b) water injection rate for WP rank 1; and (c) producer BHP and (d) water injection rate for WP rank 2. Shaded regions indicate the periods before WO adjustment begins. Black dashed lines indicate the fixed WO settings used in the WP-only.
Figs. 5(b)와 (d)는 각각 WP rank 1과 2에서 WO 최적화 후의 오일포화도 분포를 보여준다. WP-only와 비교하였을 때, 두 후보 모두 생산정 인근에서 오일포화도가 낮은 영역이 확대되었다. 이는 두 후보에 대해 SAC가 최적화한 생산정의 BHP와 주입정의 물 주입유량을 전체 유전개발기간에 걸쳐 보여주는 Fig. 6에서 설명될 수 있다.
Fig. 6에서 WP rank 1에서는 P–1과 P–3의 BHP가 비교적 빠르게 감소하여 1,620일부터 1,500 psi 정도로 유지된 반면, P–2의 BHP는 유전개발 후반부인 2,880일에 1,500 psi까지 감소하였다(Fig. 6(a)). I–4, I–5, I–6의 물 주입유량은 초기보다 전반적으로 증가하였다. 특히 I–5는 유전개발 후반부에 500 STB/day 수준의 높은 주입유량을 유지하였으며, I–7의 주입유량은 대부분의 기간 동안 초기 WO와 유사한 수준으로 다른 주입정들보다 낮게 조절되었다(Fig. 6(b)).
WP rank 2에서는 세 생산정 모두 BHP가 지속적으로 감소하여 1,800일 전후로 1,500 psi까지 도달하였다(Fig. 6(c)). I–5의 물 주입유량은 다른 주입정보다 전반적으로 높게 유지되는 모습을 보였다(Fig. 6(d)). 두 WP 후보 모두 생산정의 BHP를 낮추고 일부 주입정의 물 주입유량을 높여 Figs. 5(b)와 (d)에서와 같이 저류층 내 오일포화도가 감소하는 영역을 넓혔다. 하지만 세부적인 WO의 조절에는 차이가 있었으며, 이는 SAC가 주어진 WP와 저류층의 상태를 고려해 각 유정의 WO를 서로 다르게 조절하였음을 의미한다.
Fig. 7은 두 WP 후보의 WO 최적화 전후 오일 및 물 생산유량을 비교한다. WO 제어가 시작된 720일부터 오일 생산유량이 WP-only보다 전반적으로 높아지며, 특히 P–1과 P–3에서 차이가 두드러졌다(Figs. 7(a)와 (c)). 한편 두 후보 모두 물 생산유량도 WO 최적화 이후 증가하는 현상을 관찰하였다(Figs. 7(b)와 (d)).
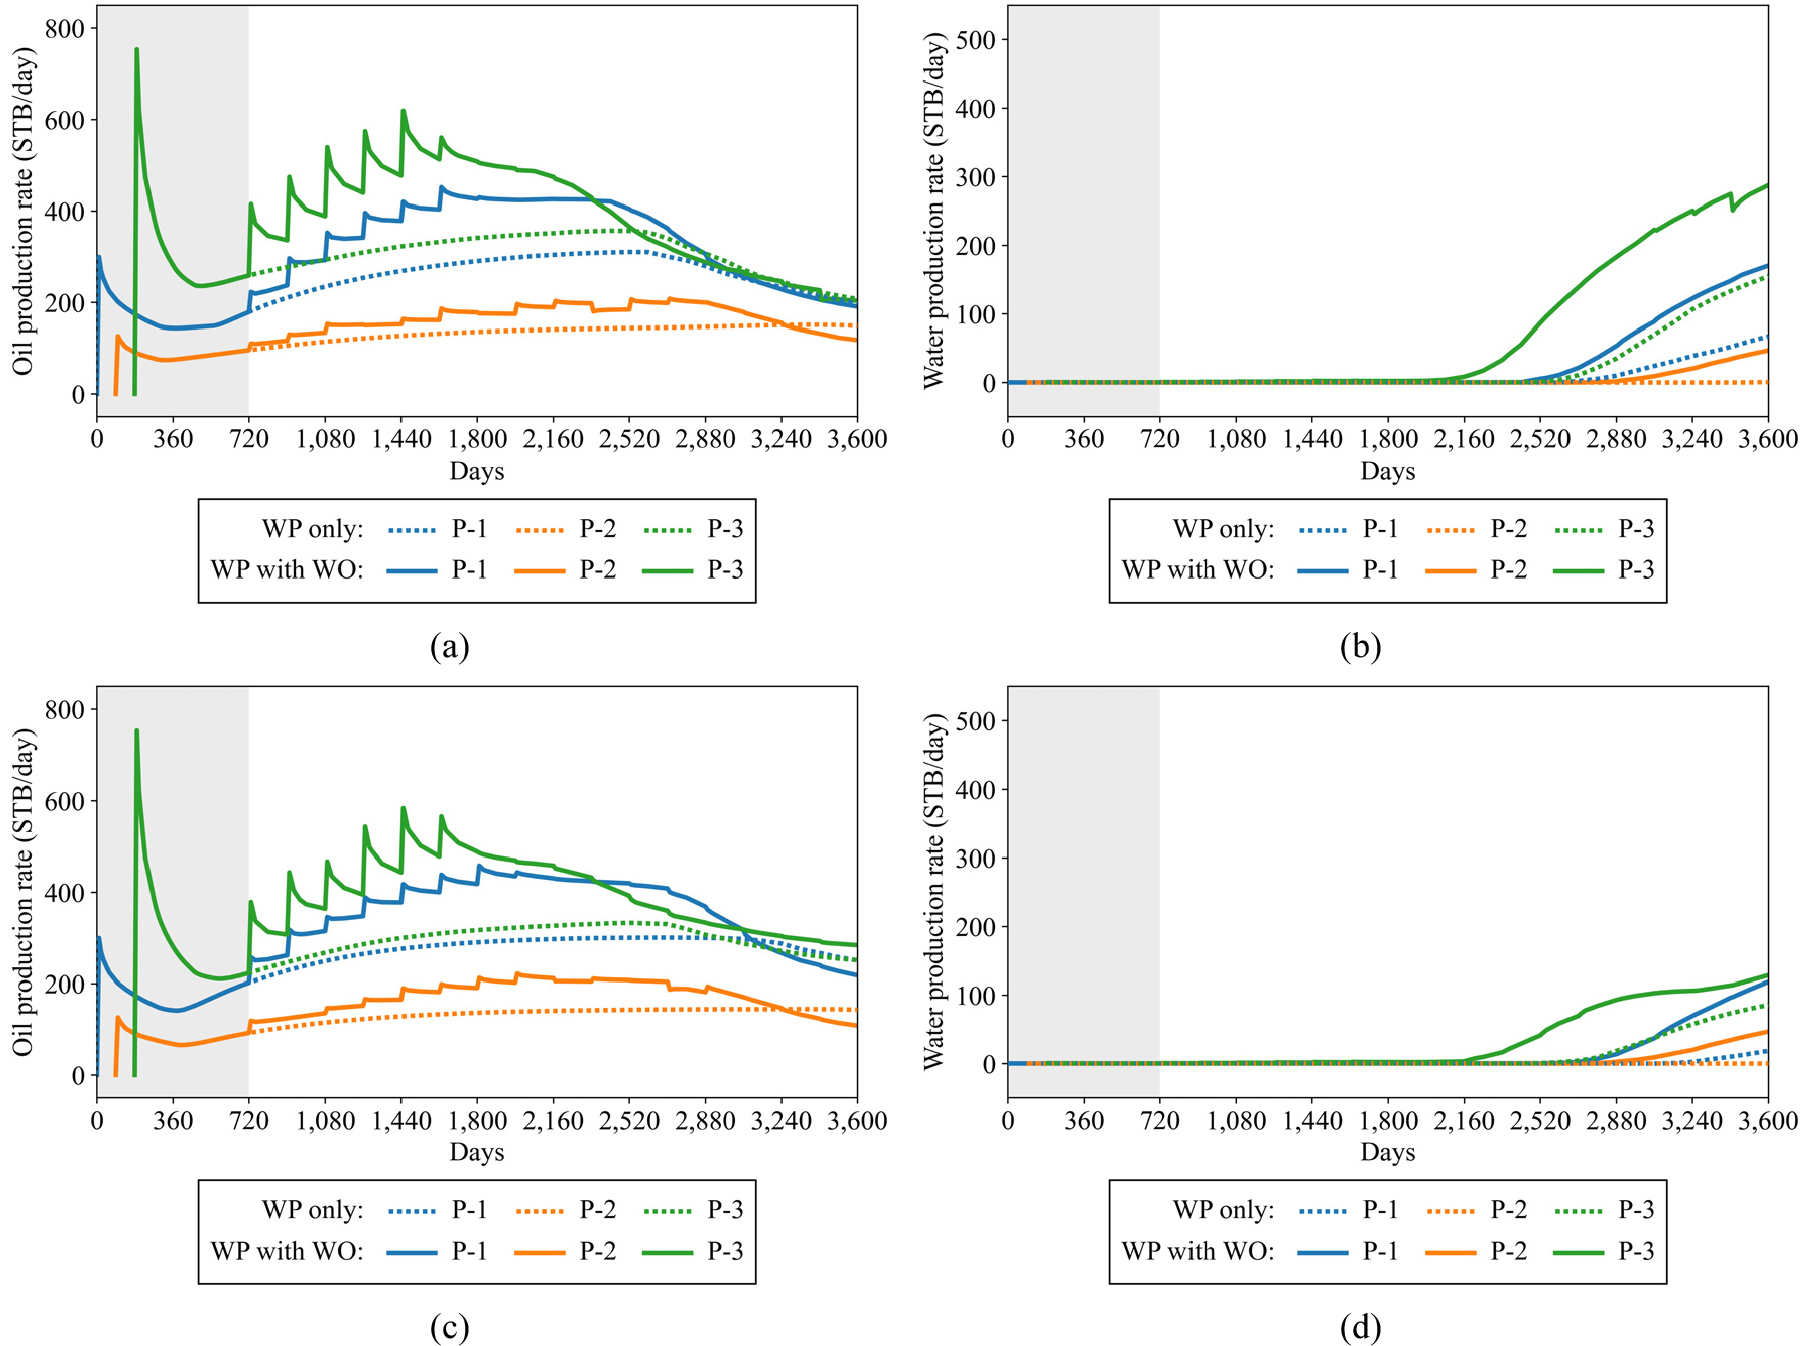
Fig. 7.
Fluid production rates before and after WO optimization: (a) oil and (b) water production rates for WP rank 1; and (c) oil and (d) water production rates for WP rank 2. Dotted and solid lines represent the WP-only and WP with WO, respectively. Shaded regions indicate the periods before WO adjustment begins.
Table 2는 두 후보의 누적 유체 생산 및 주입량과 NPV를 비교한다. WP rank 1에서는 WO 최적화 후 누적 오일 생산량이 2.37 MMSTB에서 2.89 MMSTB로 21.8% 증가하였으며, NPV는 59.9 MM$에서 77.8 MM$로 29.9% 상승하였다. WP rank 2에서도 누적 오일 생산량이 2.38 MMSTB에서 2.98 MMSTB로 25.3% 증가하였고, NPV는 59.7 MM$에서 80.3 MM$로 34.6% 개선되었다. 두 후보 모두 WO 최적화 후 물 생산량과 주입량도 증가하였으나, 증가한 오일 생산에 따른 수익이 추가적인 물 처리 및 주입비용을 상회하여 NPV가 증가하였다.
Table 2.
Cumulative fluid volumes and NPVs of WP rank 1 and 2 before and after WO optimization
본 연구에서 기본사례의 결과는 WO 최적화의 효과가 WP 후보에 따라 달라질 수 있으며, NPV가 높은 복수의 WP 후보를 대상으로 WO를 최적화한 뒤 경제성을 다시 비교할 필요성을 보여준다.
운영조건 의사결정의 시간간격 변화에 대한 학습된 SAC의 적용
기본사례에서는 유전개발 시작 후 720일부터 180일 간격으로 WO를 조절하였다. 본 연구에서는 의사결정 시간간격을 90일로 변경한 경우에도 학습된 SAC를 재사용하여 추가학습의 부담을 줄일 수 있는지 확인하고자 하였다. 이를 위해 세 가지 실험사례를 구성하였으며, 먼저 offline test(OT)는 기본사례에서 학습된 SAC를 추가 학습 없이, 기본사례의 WP 후보마다 저류층 시뮬레이션을 10회씩 수행하며 WO를 조절하였다. Training from scratch(TS)와 fine-tuning(FT)에서는 SAC의 초기 신경망을 각각 기본사례의 학습 전과 후의 신경망으로 설정하고, 기본사례에서 선정된 WP 후보들의 WO를 조절하도록 학습하였다. 의사결정의 시간간격과 횟수를 제외한 나머지 최적화 문제 설정과, TS 및 FT에서의 학습설정은 기본사례와 동일하게 유지하였다.
Fig. 8은 기본사례, TS, FT에서 학습이 진행됨에 따라 얻은 NPV와, OT에서 추가 학습 없이 반복된 저류층 시뮬레이션으로 얻은 NPV의 최댓값 추이를 보여준다. Table 3은 각 사례에서 얻은 최종 NPV를 비교한다. 모든 사례에서 NPV가 가장 높은 WO는 WP rank 2에서 도출되었다. 먼저 OT의 최종 NPV는 82.0 MM$로 기본사례보다 2.00% 높았으며, 이는 기존의 학습된 SAC를 보다 조밀한 의사결정 시간간격에서도 적용할 수 있음을 보여준다.
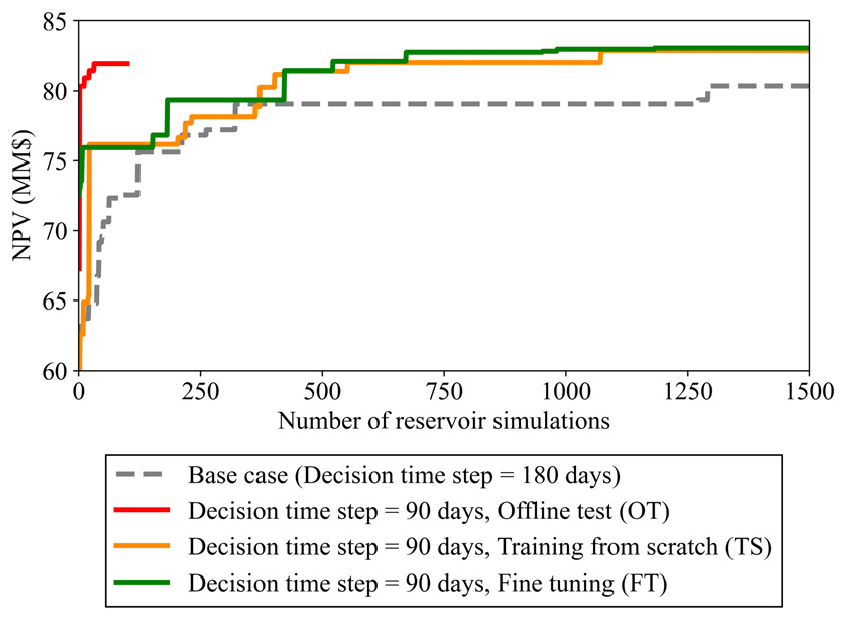
Table 3.
Highest NPVs from the base case and the experimental cases
| Case | Decision time step [days] | NPV [MM$] |
| Base case | 180 | 80.3 |
| OT | 90 | 82.0 |
| TS | 90 | 82.9 |
| FT | 90 | 83.1 |
FT의 최종 NPV는 83.1 MM$로 기본사례보다 3.40% 높았으며, TS에서도 이와 유사한 수준으로 기본사례보다 3.18% 높은 82.9 MM$를 달성하였다. 그러나 Fig. 8에서와 같이 학습 초기부터 FT는 TS보다 NPV가 높은 WO를 도출하고, OT의 최종 NPV를 더 빠르게 넘어섰다. FT와 TS에서 OT의 최종 NPV를 처음으로 넘기까지 수행한 저류층 시뮬레이션 횟수는 각각 522회와 552회였다. 이러한 결과는 기 학습된 SAC를 활용하여 학습 초기부터 높은 NPV를 달성하고, 더 높은 NPV에 빠르게 도달할 수 있음을 보여준다.
Fig. 9은 기본사례(Figs. 6(c)와 (d))와 FT에서 가장 높은 NPV를 보인 WO 중 P–2의 BHP와 I–5의 물 주입유량을 비교한다. P–2의 BHP는 FT에서 기본사례보다 더 빠르게 감소하여 하한인 1,500 psi에 일찍 도달하였다(Fig. 9(a)). I–5의 물 주입유량은 초기에는 유사하나, 그 이후 FT에서 기본사례보다 높게 조절되는 구간이 나타났다(Fig. 9(b)). 의사결정 시점마다 허용되는 WO 변화량의 범위는 동일하므로, FT에서 WO를 더 자주 조절하여 빠르게 변화시킨 의사결정이 NPV 개선에 기여했을 가능성이 있다.
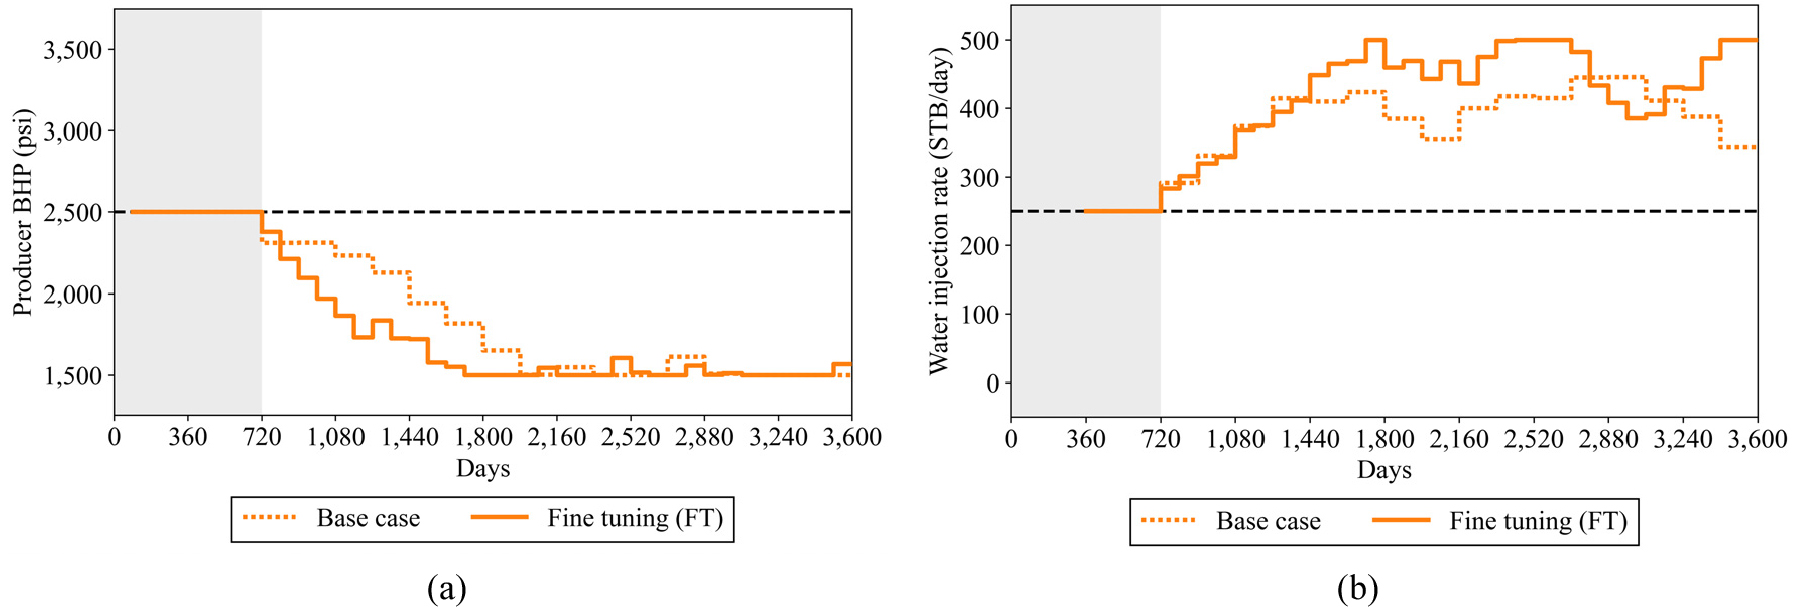
Fig. 9.
Optimized WO schedules for the base case and FT: (a) producer BHP for P-2 and (b) water injection rate for I-5. Dotted and solid lines represent the base case and FT, respectively. Shaded regions indicate the periods before WO adjustment begins. Black dashed lines indicate the fixed WO settings used in the WP-only.
위와 같은 결과들로부터 180일 간격의 WO 최적화 문제에서 학습된 SAC가 90일 간격의 문제에 추가 학습 없이 적용될 수 있으며, 이를 FT의 초기설정으로 활용하여 추가 학습의 효율을 높일 수 있는 가능성을 확인하였다.
토 의
본 연구는 육상 유전을 독립적으로 개발하는 상황을 대상으로, 기본설계 단계에서 수공법을 고려한 개발계획 내 WP와 WO를 최적화하였다. 의사결정 시간간격과 개발기간은 제안한 프레임워크의 평가를 위해 가정한 값이므로, 현장 적용을 위해서는 자료 확보 및 계획 변경에 필요한 기간과 사업의 경제성을 고려하여 조정할 필요가 있다. 아울러 시추리그의 수와 가용 일정, 설비의 처리용량과 같은 요소들을 행동과 제약조건에 반영하는 방향으로 프레임워크를 보완할 수 있다.
제안한 프레임워크의 검증을 위한 기본사례의 경제성 평가에는 현 수준 대비 보수적으로 설정한 오일 가격과 물 처리 및 주입비용이 적용되었으나, 생산설비 투자비, 고정 운영비, 폐정비용 등은 포함되지 않았다. 특히 Appendix의 시추비용 민감도분석에서는 비용이 증가할수록 시추되는 유정의 개수와 NPV가 감소하는 경향을 확인하였다. 향후 사업별 비용항목과 조세 및 계약조건을 반영하고, 유가와 물 처리 및 주입비용 등 다른 경제성 인자의 변화를 함께 검토하면, 경제성 조건이 최적화 결과에 미치는 영향을 보다 현실적으로 평가할 수 있다.
본 연구에서는 NPV를 기준으로 상위 10개의 WP 후보에 대해 WO를 최적화하였다. WO 최적화 이후 후보 간의 순위가 달라진 점을 고려하면, 선정되지 않은 WP가 최적화 이후 더 높은 NPV를 보일 가능성이 있다. 후속 연구 방향으로 WP 후보의 선정 기준과 범위에 따른 NPV를 평가하여, WP와 WO의 연계 최적화 성능을 높이는 후보 선정 방식을 모색할 수 있다.
제안한 프레임워크의 SAC는 서로 다른 WP 환경에서 학습되었으나, 저류층의 물성 분포는 동일하였다. 이에 WO 최적화의 경제성 개선 효과를 지질학적 불확실성이 있는 조건으로 일반화하는 데에는 한계가 있다. 향후 지질학적 불확실성을 대표하는 여러 저류층 모델을 고려하여, 경제성이 높은 WP와 WO를 강건하게 도출하는 프레임워크로 확장하는 것을 주요 연구 방향 중 하나로 제안한다.
본 연구에서는 저류층 모델의 물성과 시뮬레이션으로 계산된 압력 및 오일포화도를 참값으로 간주하고, 저류층 전체의 정보를 의사결정에 활용할 수 있다고 가정하였다. 관측정보의 제약과 저류층 모델의 예측오차를 고려하고, 생산자료를 이용해 모델을 갱신하는 과정도 프레임워크의 현장 적용을 위한 주요 과제이다. 후속 연구로 현장에서 확보 가능한 자료의 종류와 측정 위치 및 주기를 고려하여 상태정보를 정의하고 최적화 문제를 POMDP로 확장할 수 있다. 아울러 히스토리 매칭을 통해 갱신된 모델에서, 기존의 의사결정에 따른 후속 WP와 WO를 최적화할 수 있다. 이를 통해 개발 과정에서 확보되는 자료를 이후의 의사결정에 반영하는 폐루프 저류층 관리 구조를 구축할 수 있을 것으로 기대한다.
결 론
본 연구는 유전개발계획(FDP) 내 유정배치(WP)와 운영조건(WO)을 순차적으로 최적화하기 위한 심층강화학습(DRL) 기반의 프레임워크를 제안하였다. WP 최적화에는 이중 심층 Q-네트워크(DDQN)를 학습하여 유정의 시추여부, 위치, 종류와 같은 이산변수를 결정하고, NPV가 높은 WP 후보들을 도출하였다. 이후 NPV 기준 상위 10개의 WP 후보를 대상으로 소프트 액터–크리틱(SAC)을 학습해 생산정의 공저압력(BHP)과 주입정의 물 주입유량과 같은 연속변수를 시간에 따라 조절하였다. DDQN과 SAC 모두 학습이 진행됨에 따라 FDP의 NPV를 개선하는 방향으로 의사결정 규칙을 학습하였다.
10개의 WP 후보에 WO를 추가로 최적화하였을 때, WP 후보들의 NPV는 57.9~59.9 MM$에서 67.8~80.3 MM$로, 15.7~34.6% 개선되었다. WO 최적화에서 SAC가 시간에 따라 생산정의 BHP와 주입정의 물 주입유량을 적절히 조절하여, 동일한 WP에서도 오일포화도가 낮은 영역이 확대되고 누적 유체 생산 및 주입량이 증가함을 확인하였다. 이러한 결과는 SAC의 학습이 진행되면서 WP 후보의 경제성이 개선되었음을 보여준다.
WO 최적화에 따른 NPV 개선 정도는 WP 후보마다 다르게 나타났으며, NPV 기준 WP 후보들의 순위가 변동되었다. 따라서 WP 최적화 결과를 하나의 후보로 확정하기보다, NPV가 높은 여러 WP 후보에 WO 최적화를 수행하고 이들의 경제성을 다시 평가할 필요가 있다.
추가실험에서는 WO 의사결정의 시간간격을 180일에서 90일로 단축하고, 기 학습된 SAC의 재사용 가능성을 평가하였다. 학습된 SAC를 추가 학습 없이 적용한 경우, 초깃값으로 활용하여 추가 학습한 경우, 학습 전 신경망에서 새로 학습한 경우 모두 기본사례 대비 2.00~3.40% 높은 NPV를 달성하였다. 이로부터 기존의 학습된 SAC를 추가 학습 없이 적용하거나, 초깃값으로 활용하여 효과적인 추가 학습이 이루어질 수 있음을 확인하였다.