

서 론
이론적 배경
게이트 합성곱 신경망
변분 오토인코더
벡터양자화 변분오토인코더
생성적 적대 신경망
스타일 기반 생성적 적대 신경망
인공신경망 기반 탄성파 자료 전처리 차원확장 기법의 방법론
게이트 합성곱 GAN 기반 3차원 확장 기법
VQ-VAE 기반 3차원 확장 기법
생성형 인공신경망 기반 3차원 확장 기법
적용 결과 및 비교분석
결 론
서 론
탄성파 탐사(seismic survey)는 인공적으로 발생시킨 탄성파가 지하 매질의 음향 임피던스(acoustic impedance) 경계면에서 반사 및 굴절되어 돌아오는 신호를 기록·분석함으로써 지하의 층서 및 지질구조를 규명하는 대표적인 지구물리탐사 기법이다(Yilmaz, 2001; Chopra and Marfurt, 2007). 이는 석유·가스 탐사뿐만 아니라 이산화탄소 지중저장 부지 선정 및 유체 거동 모니터링, 토목 분야에서의 지반 조사 등으로 활용 범위가 확대되어 왔다. 복잡한 지하 구조를 더욱 세밀하게 파악하기 위해 탐사 자료의 취득 및 자료의 향상, 처리 기술 역시 고도화되고 있다.
탄성파 탐사는 자료 취득 체계와 공간적 범위에 따라 크게 2차원(2D) 탐사와 3차원(3D) 탐사로 나뉜다. 2차원 탐사는 단일 측선을 따라 송신원(source)과 수신기(receiver)를 배열하여 측선 하부의 2차원 단면 자료를 취득하는 방식이다. 이는 넓은 지역을 적은 비용으로 빠르게 조사할 수 있다는 장점이 있지만, 측선 외측에서 반사되어 들어오는 반사파나 복잡한 3차원 지질구조에 의한 파동의 3차원적 산란 효과를 올바르게 보정하기 어렵다는 본질적인 한계를 지닌다. 반면, 3차원 탐사는 면적 단위의 격자 형태로 수진기를 배치하여 탐사 대상 영역 전체에 대한 3차원 체적 자료를 취득한다.
3차원 탐사는 공간적으로 조밀한 표본화를 통해 복잡하게 변화하는 지질구조를 구속할 수 있으며, 인라인 및 크로스라인 간격 크기를 조절함으로써 해석의 신뢰도를 높일 수 있다(Brown, 2011; Ebrom et al., 1995). 그러나 3차원 탐사는 우수한 해상도와 해석 정확도의 대가로 막대한 경제적 비용과 시간적 제약을 동반한다. 복수의 수진기를 예인하는 전용 탐사선 운용에는 수개월의 시간과 고비용이 소요된다. 아울러 취득된 방대한 용량의 자료를 해석 가능한 정밀 영상으로 변환하기 위해서는 3차원 정밀 역산(inversion) 역시간 구조보정(Reverse Time Migration; RTM) 등 고도의 계산집약적 처리 과정을 거쳐야 한다(Liner, 2016).
이러한 현장 실무·경제적 한계로 인해 탄성파 탐사 현장에서는 효율적인 단계별 탐사 전략을 채택하고 있다. 즉, 초기 광역 조사 단계에서는 광범위한 지역에 대해 2차원 탐사를 우선 실시하여 전체적인 지질학적 구조를 파악하고 유망한 지역을 선별한 뒤, 정밀한 구조 파악이 필요한 국소적 영역에 한하여 고비용의 3차원 탐사를 수행하는 방식이다. 따라서 대부분의 개발 대상 지역에서는 광역 구조를 포괄하지만 공간 해상도가 낮고 측선 간 격차가 존재하는 2차원 자료와, 정밀하지만 특정 국지 영역에 국한된 3차원 자료가 혼재하는 자료 구조가 형성된다. 더욱이 과거 수십 년간 축적된 방대한 양의 2차원 자료는 여전히 정밀 해석이 요구되는 지역의 주요 기반 자료로 남아 있다.
2차원 탐사는 측선별로 취득 시기와 송신원 특성이 다르다는 특성을 지닌다. 또한 이를 처리하는 중합 및 구조보정 과정에서 오차가 누적되면, 동일 반사면에서 기원한 신호가 탄성파 탐사 자료상의 서로 다른 위치에 나타나는 미스타이(mistie)가 발생한다. 이는 다수의 측선을 통합하여 3차원 구조를 해석하고자 할 때 직접적인 장애가 된다.
2차원 탐사 자료를 종합하여 3차원 구조를 파악하고자, 여러 기법이 제안되어 왔다(Lin and Holloway, 1988; Parks, 2009; Whiteside et al., 2013). 대표적으로 구조정합보간(Structurally Conformable Interpolation, SCI) 기술은 2차원 탄성파 자료를 역구조보정(Demigration)하여 지질 구조에 맞춰 보간한 뒤, 3차원 구조보정(3D Migration)을 적용함으로써 연속적인 3차원 지질구조 볼륨을 생성하는 기법이다(O’Keefe et al., 2017). 그러나 SCI는 측선 간 위상·시간·주파수 스펙트럼의 전역적 정합이 필요하고, 층서 추적을 비롯한 정교한 해석과 전처리 과정을 전제하며, 2차원 역구조보정 및 3차원 구조보정에 막대한 계산이 수반된다. 특히 미스타이(mistie) 보정이 수작업으로 이루어지는 경우가 많아 해석자의 숙련도와 주관에 결과가 좌우된다는 한계가 있다. 크리깅(kriging)을 비롯한 지구통계 기반 보간 방법론 역시 측선 사이 영역을 추정하는 데 활용되어 왔으나(Deutsch and Journel, 1992; Chiles and Delfiner, 2012), 배리오그램 등 공간상관 모델을 사전에 설정해야 하므로 단층이나 부정합과 같은 불연속 구조를 표현하기 어렵고, 모델 설정 과정에 주관적 판단이 개입될 여지가 크다.
최근 계산 자원의 확대와 함께 기계학습 기법이 탄성파 자료처리 및 해석 전반에 폭넓게 적용되고 있다(Khosro Anjom et al., 2024). 잡음 제거(Zhang et al., 2019; Saad and Chen, 2020), 속도 추정(Fabien-Ouellet and Sarkar, 2020), 시간경과 자료처리(Jun and Cho, 2022; Lee et al., 2024), 층서 추적(Shi et al., 2020), 결측 자료 보간(Park et al., 2022; Yuan et al., 2022) 등이 대표적이다. 기계학습이라는 방법론은 기존 기법과 달리 복잡한 전처리나 해석 단계를 요구하지 않는다는 점에서 차원확장 수행에 유리하다는 장점도 존재한다.
기계학습 기반 차원확장 기법은 설계 방식에 따라 다양한 형태로 제안되어 왔다. 결측 트레이스를 복원하는 보간 과업을 3차원으로 확장한 연구(Chai et al., 2021; Lu et al., 2019)와, 2차원 신경망을 다방향으로 적용하여 3차원 자료를 다루는 연구(Abedi and Pardo, 2022) 등이 그 예이다. 이들은 주로 규칙적으로 배치된 자료의 일부가 결측된 상황을 가정하므로, 수 km 간격으로 불규칙하게 분포하는 실제 2차원 측선으로부터 체적 전체를 복원하는 과업과는 전제가 다르다.
본 연구에서는 입력 자료 및 활용 방안의 측면에서 점점 발전해온 세 기법을 비교한다. 첫 번째 기법은 원본 체적을 외부 측선 방향으로 점진적으로 확장하며, 층서 및 고주파 성분 복원에서 우수한 성능을 보이지만 초기 3차원 체적을 요구한다. 두 번째 기법은 벡터양자화 변분오토인코더(vector-quantized variational autoencoder, VQ-VAE)를 도입하여 초기 3차원 체적 없이 측선만으로 하나의 체적을 추정한다. 세 번째 기법은 VQ-VAE의 잠재공간 위에서 생성형 신경망과 적대적 학습을 수행하여 동일한 입력으로부터 복수의 타당한 구조를 생성한다.
본 연구는 세 기법을 동일한 검증 자료에 동일하게 구성된 희소 입력 조건으로 적용하고, 복셀 단위 지표와 주파수 특성, 그리고 생성 결과의 변동성을 함께 검토하여 각 기법의 적용 범위와 한계를 제시한다.
이론적 배경
게이트 합성곱 신경망
합성곱 신경망(convolutional neural network, CNN)은 국소 수용영역을 갖는 필터를 입력 전역에 공유하여 적용하는 구조로, 격자 형태로 표본화된 자료에서 공간적 패턴을 추출하는 데 효과적이다(Fig. 1). 탄성파 체적은 시간축과 두 수평축으로 구성된 3차원 격자 자료이므로 합성곱 연산을 직접 적용할 수 있다.
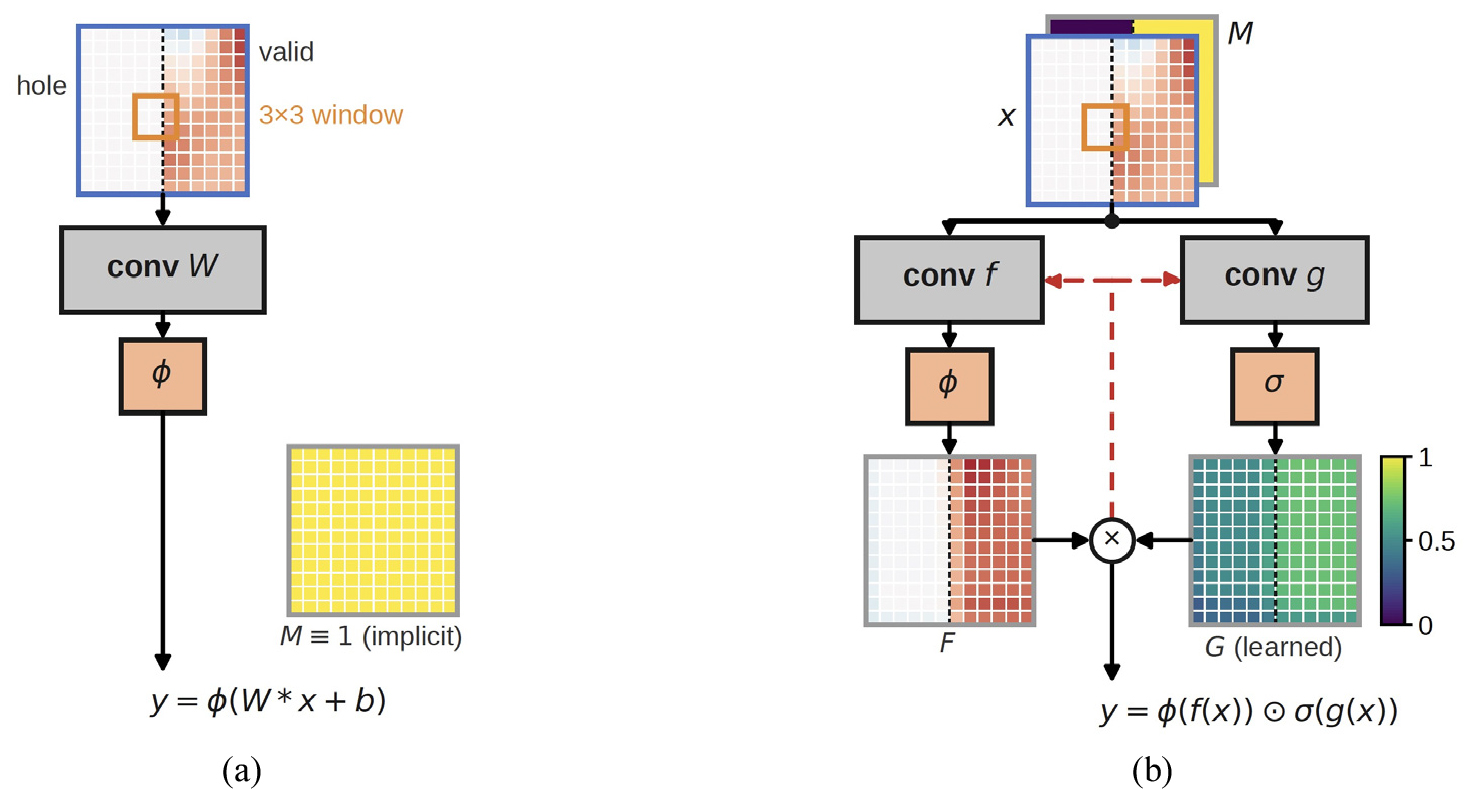
일반적인 합성곱(vanilla convolution)은 입력의 모든 화소를 동등하게 취급한다. 그러나 결손 영역을 복원하는 과정에서는 각 층의 입력이 이미 주어진 유효 화소와 아직 정확히 추정되지 않은 화소로 구성되므로, 이들을 무차별적으로 변환하면 경계에서 급격한 값 변화, 흐림, 비정상적 반응 등의 아티팩트가 발생한다(Yu et al., 2019).
게이트 합성곱(gated convolution)은 동일한 차원의 필터 두 개를 각 층에 두어 이 문제에 대응한다. 하나는 특징을 추출하고 다른 하나는 연산이 적용될 영역을 지시하는 게이팅 마스크를 생성한다. 이를 수학적으로 서술하면 아래와 같다.
이때 는 입력 텐서, 와 는 입력 데이터의 특징을 추출하고 마스크를 생성하는 가중치(weight) 행렬에 해당한다. 𝜙는 활성화 함수를, 𝜎는 시그모이드 함수를 각각 의미하며 ⊙는 요소별 곱셈 연산을 의미한다. 마스크 합성곱은 해당 영역이 이미 주어진 정보인지 아니면 추정이 필요한 영역인지를 학습한다. 따라서 신경망이 불완전하게 채워진 영역에 집중하여 연산을 수행한다. 또한, 이 방식은 마스크를 사전에 고정하지 않고 학습 과정에서 갱신한다.
변분 오토인코더
오토인코더(autoencoder)는 입력된 값을 저차원 잠재공간으로 압축한 뒤 이를 복원하도록 학습하여 자료의 압축된 표현을 획득하는 비지도 학습 구조이다. 변분 오토인코더(variational autoencoder, VAE)는 여기에 확률적 요소를 도입한 구조로(Fig. 2), 인코더가 입력을 가우시안 분포의 평균과 분산으로 사상하고 이 분포에서 표본화된 잠재공간 내 변수를 디코더가 복원하도록 한다(Kingma and Welling, 2013).
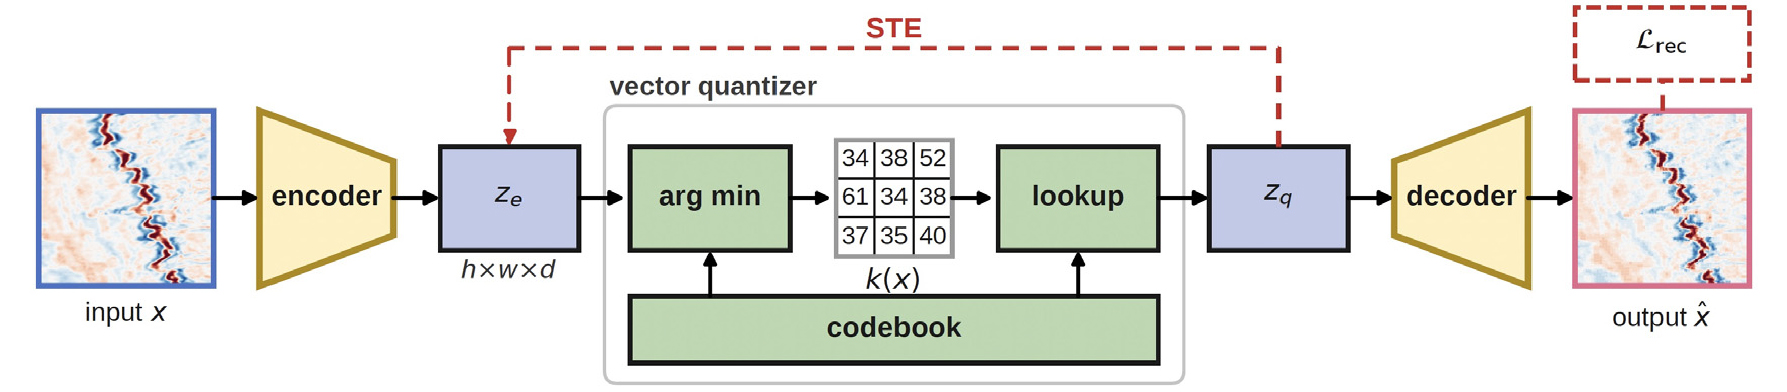
VAE의 강점은 전역적 패턴을 우선 학습한다는 점이다. 입력을 저차원 공간으로 압축하는 과정에서 자료의 광범위한 관계와 패턴이 우선적으로 보존되므로, 전역적인 구조를 주로 다루고자 할 때 유리하다. 탄성파 자료에서 이는 층서와 단층 등 구조적 의존성에 해당한다.
이러한 구조의 특성상, 오토인코더는 서로 다른 데이터 간의 유사한 특징을 잘 포착한다. 그러나 VAE는 두 가지 한계를 가진다. 잠재공간이 가우시안 분포를 따르도록 강제하는 정규화 항이 세밀한 조직적 정보의 손실을 초래하여 국부적인 부분의 복원 충실도를 떨어뜨린다. 둘째, 잠재변수가 입력의 유의미한 정보를 담지 못하고 디코더가 사전분포만을 고정적으로 사용하는 사후분포 붕괴 현상이 발생할 수 있다(Lucas et al., 2019).
벡터양자화 변분오토인코더
벡터양자화 변분오토인코더(VQ-VAE)는 연속적인 잠재분포 대신 유한한 벡터 집합, 즉 코드북(codebook)에서 선택된 이산 벡터의 나열로 잠재공간을 표현한다(van den Oord et al., 2017). 따라서 입력된 값 를 이산화되고 구조화된 잠재벡터의 집합 으로 사상하며, 이때 각 잠재벡터는 가장 가까운 코드북의 벡터로 양자화되어 표현된다. 이후 디코더는 이렇게 양자화된 코드북의 벡터를 활용하여 원본 값의 차원에 맞게 값을 복원한다.
이러한 구조는 기존 VAE가 세밀한 영역을 잘 표현하지 못했던 한계를 극복하게 한다. 동시에 거시적인 구조 자체에 대한 표현력도 잃지 않고, 코드북에 표현된 데이터의 분포만을 디코더가 복원하게 하여 입력 데이터에서 나타날 수 없는 비물리적인 값을 생성하지 않게 억제한다. 또한 양자화된 잠재공간의 특성상, 타 인공신경망 구조와의 결합이 쉽다는 장점도 함께 지닌다.
생성적 적대 신경망
생성적 적대 신경망(generative adversarial network, GAN)은 합성 자료를 생성하는 생성 신경망 모듈과 입력이 실제 자료인지 생성된 자료인지를 판별하는 판별 신경망 모듈을 경쟁적으로 학습시키는 생성 모형이다(Fig. 3, Goodfellow et al., 2014). 생성 신경망 모듈의 역할은 실제 데이터와 유사한 값을 생성하는 것이며, 반대로 판별 신경망 모듈의 역할은 그것이 실제인지 가짜인지를 구분하는 것이다. 생성 신경망 모듈은 판별 신경망 모듈을 속이도록, 판별 신경망 모듈은 둘을 구분하도록 번갈아 최적화되며, 이 과정에서 생성 신경망 모듈은 학습 자료의 분포를 학습하게 된다.
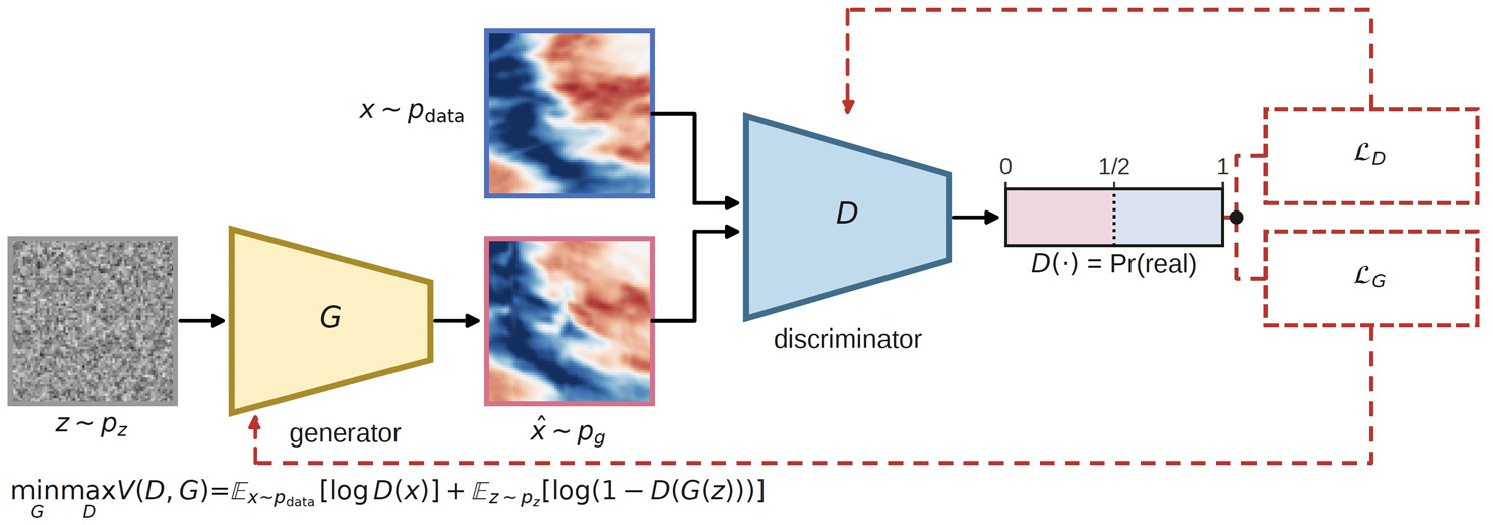
명시적인 확률을 모델링하지 않고도 높은 표현력의 자료를 다양하게 생성할 수 있기에, GAN은 고해상도 이미지를 다루는 용도로 널리 사용된다. 이는 판별 신경망 모듈의 특성 때문에 기인한다. 판별 신경망 모듈에서 계산되는 목적함수는 고주파 특징에 민감하게 작용하여, 생성되는 자료의 선명도를 향상한다.
스타일 기반 생성적 적대 신경망
스타일 기반 생성적 적대 신경망(StyleGAN)은 생성적 적대 신경망이 변형된 구조로, 기존 GAN과 달리 생성 과정에서 특정한 특징에 대한 표현을 보다 제어 가능하도록 설계된 구조이다(Karras et al., 2019). StyleGAN은 잠재부호를 생성 신경망 모듈에 직접 입력하는 대신, 사상 네트워크를 활용하여 스타일 벡터를 생성한 후, 이를 생성 과정 내에 반영하는 방식이다.
이렇게 변환된 벡터는 생성되는 데이터의 거시적인 구조 및 미시적인 특성을 잘 구분하고, 이는 해당 구조의 ‘스타일’을 미세하게 조정하는 역할을 한다. 이미지의 전반적인 구조와 세부적인 특성을 보다 잘 분리해 표현하도록 유도하는 것이다.
생성 과정에서 스타일 인자가 지속적으로 사용되고, 이를 통해 세부적인 특징이 조정된다. 저해상도 생성 단계에서는 전역적인 구조가 주로 생성되며, 고해상도 생성 단계에서는 국소적인 특징이 주로 다뤄진다. 따라서 생성하고자 하는 데이터 내의 다양한 계층의 특성들이 표현되고, 결론적으로 사실감이 향상되는 효과를 낳는다.
인공신경망 기반 탄성파 자료 전처리 차원확장 기법의 방법론
게이트 합성곱 GAN 기반 3차원 확장 기법
게이트 합성곱 GAN 기반 3차원 확장 기법(GC-GAN 기법)은 기존 3차원 체적의 일부가 주어진 상태에서 이를 외부 측선 방향으로 점진적으로 확장하는 방식으로 정의된다(Fig. 4, Lee et al., 2025a). 이때 원본 체적을 포함한 타 3차원 탄성파 자료가 모두 학습에 사용된다. 원본 체적은 확장 대상 영역과 지질학적 특성 및 탄성파 전파 특성을 가장 직접적으로 공유하므로 확장 결과의 정합성을 높인다. 또한 체적 외삽은 본질적으로 출발점이 되는 체적을 필요로 하므로 이를 학습에 반영하는 것이 실제 적용 상황과 부합한다.
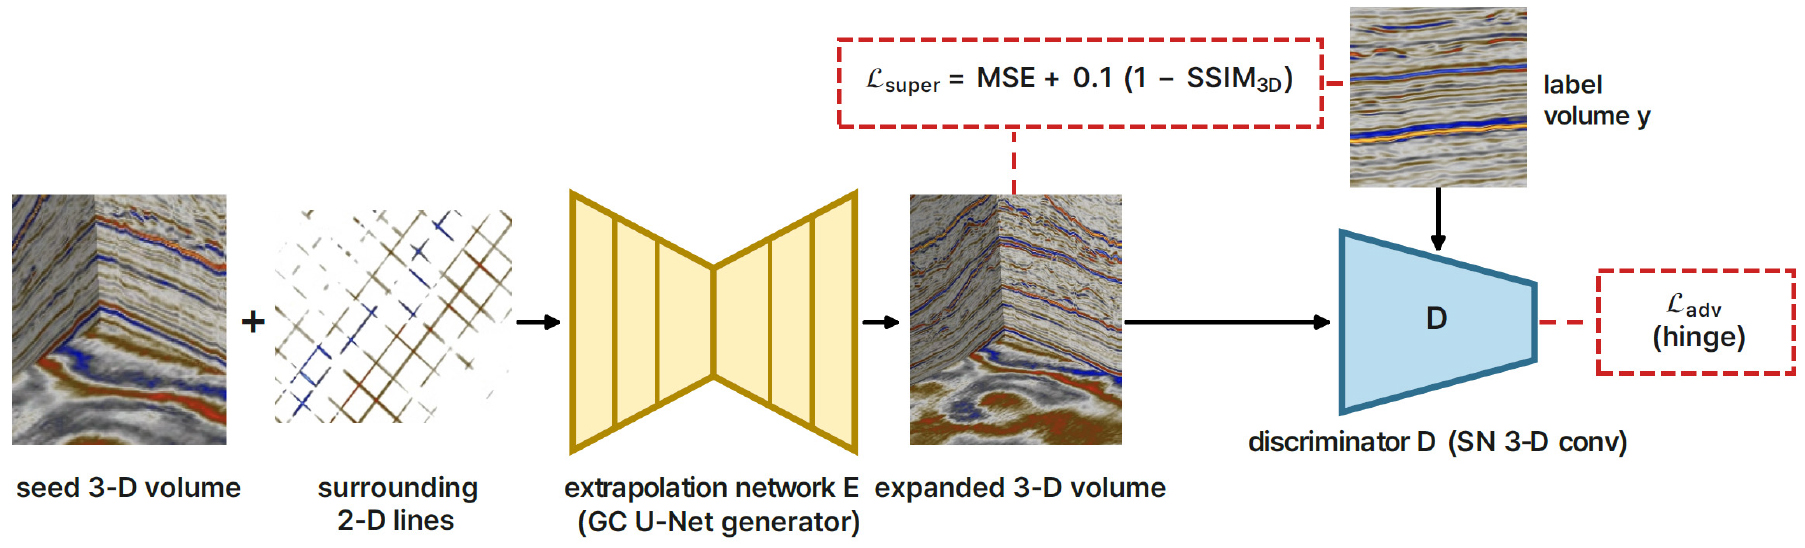
외삽망의 입력은 결손 체적, 측선 체적, 시간 좌표 체적, 그리고 결손 체적과 측선 체적 각각에 대응하는 마스크로 구성된다. 결손 체적은 라벨 체적의 한두 모서리를 뮤팅하여 외삽 대상 영역을 비워 둔 것이며, 시간 좌표 체적은 최상부 복셀에서 –1, 최하부 복셀에서 1의 값을 갖도록 정의되어 심도에 따른 탄성파 특성 변화를 신경망이 반영할 수 있게 한다.
체적 내 임의 위치에 놓인 측선 자료를 인접 트레이스의 보간을 거쳐 추출한 뒤, 이를 지정된 복셀 격자에 재할당하는 방식으로 체적이 생성된다. 재할당 시 측선 상의 점 간격이 격자보다 조밀하면 여러 점이 동일 화소에 대응할 수 있으므로, 측선 점과 인접 격자점의 상대 위치로부터 유도한 가중치를 이용한 가중평균을 적용한다.
결손 영역을 복원하는 과정에서 일반적인 합성곱은 주어진 값과 추정되는 값을 명확히 구분하지 않고 동일한 변환을 적용한다는 한계점이 존재하지만, 본 기법에 사용되는 게이트 합성곱은 각 층에 동일한 크기의 필터를 두 개 두어 이 문제를 해결한다(Fig. 5). 하나는 통상적인 특징 추출을 담당하고, 다른 하나는 연산이 적용될 영역을 지시하는 마스크를 생성한다.
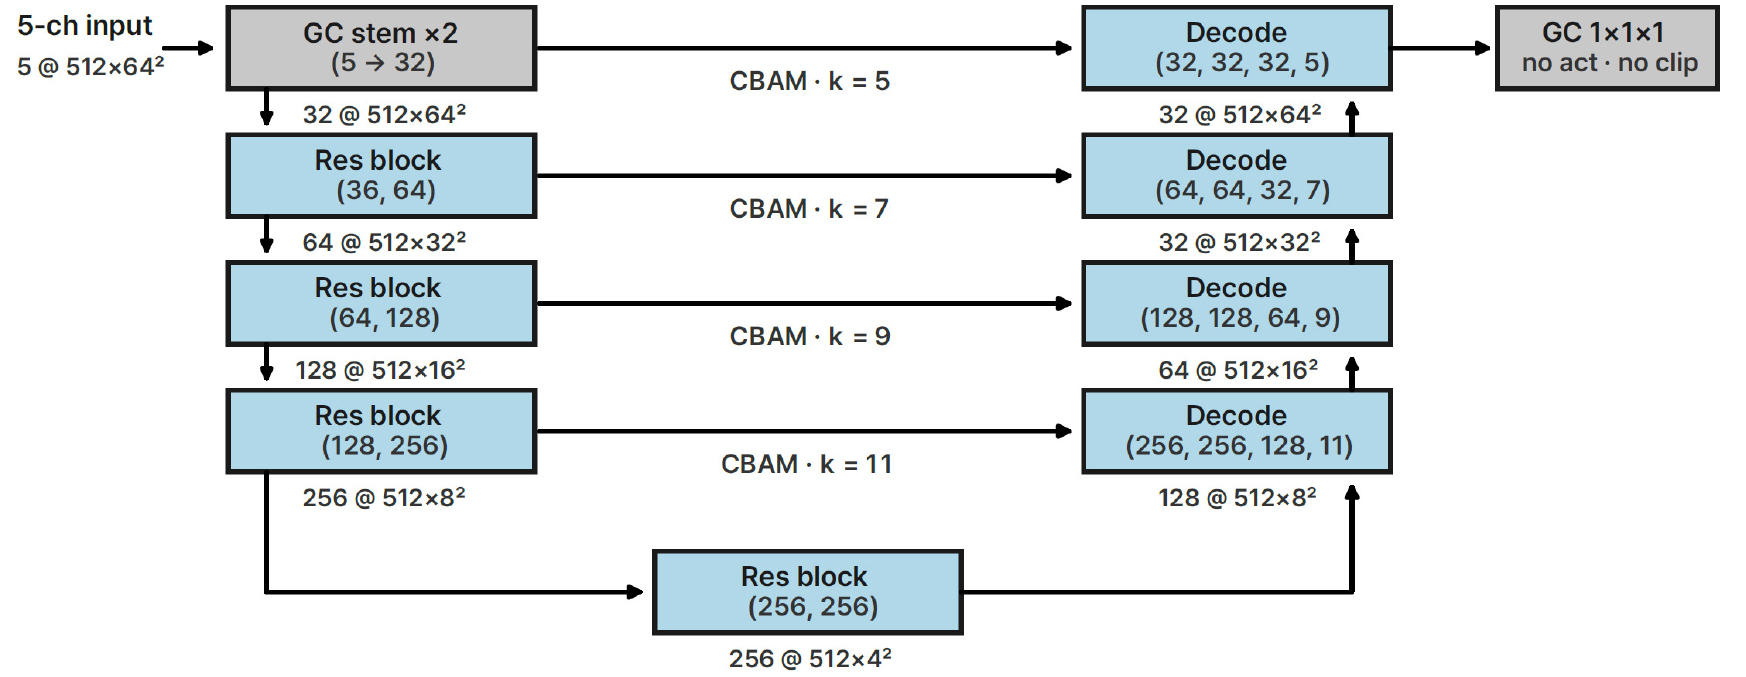
외삽망은 U-Net(Ronneberger et al., 2015) 구조를 기반으로 하되, 인코더 블록은 잔차 방식으로 출력을 계산하고 디코더 블록은 인코더에서 전달된 정보를 게이트 합성곱으로 처리한다. 건너뛰기 연결에는 CBAM(Woo et al., 2018)을 배치하여 적은 연산 부담으로 광역 특징을 다룬다. 기본 연산은 게이트 합성곱, 인스턴스 정규화로 구성되며, 상향 및 하향표본화는 수평 방향에만 적용한다. 최종 층에서는 –1에서 1 범위를 벗어나는 출력을 절단하여 라벨 체적의 분포 범위에 부합하게 한다.
보조망은 심층 합성곱 GAN의 판별 신경망 모듈 구조를 따르며, 각 준위가 스펙트럴 정규화(Miyato et al., 2018)를 적용한 일반 합성곱, Swish 활성화, CBAM으로 구성된다. 외삽망과 보조망 모두 측선 체적, 마스크 체적, 시간 좌표 체적을 첫 층과 단위 블록의 추가 입력 채널로 받아 보강된다.
학습은 감독 손실 과 적대 손실 의 조합으로 이루어진다. 감독 손실은 외삽 결과와 라벨 체적의 차이를 계산하여 피드백하는 데에 이용되는 항으로, 복셀 단위의 진폭 차이를 측정하는 항과 국소 창 내의 구조 유사도를 측정하는 3차원 유사도지수(SSIM) 항을 결합한 형태를 취한다(Wang et al., 2004). 진폭 차이만을 최소화하면 오차는 줄어들지만 반사면의 기하가 흐려지는 경향이 있으므로, 구조유사도 항이 이를 보완한다.
적대 손실은 보조망이 제공하는 피드백이다. 보조망은 라벨 체적과 외삽 체적을 구분하도록 학습되고, 외삽망은 그 구분을 어렵게 만들도록 학습된다. 이 경쟁 과정에서 외삽 결과는 라벨 체적이 갖는 특징에 점점 가까워진다. 보조망의 손실함수로는 힌지 손실을 사용하였는데, 이는 출력이 일정한 여백을 확보하면 더 이상 피드백을 적용하지 않는 형태이므로 보조망이 지나치게 강해져 학습이 불안정해지는 것을 억제한다(Lim and Ye, 2017).
외삽은 원본 체적에서 출발하여 외삽하고자 하는 자료의 경계에 도달할 때까지 진행된다. 학습된 신경망이 한 모서리 또는 두 모서리가 결손된 체적을 대상으로 하므로, 외삽은 모서리와 변에 대해 교대로 수행된다. 모서리의 경우 고정 차원 내에서 직접 외삽이 가능하나, 변의 경우 한 수평 차원이 입력 차원을 초과할 수 있으므로 슬라이딩 윈도우 기법을 적용하여 수행된다.
VQ-VAE 기반 3차원 확장 기법
VQ-VAE 기반 3차원 확장 기법(VQ-VAE 기법)은 입력 자료로 3차원 체적이 필요하지 않으며, 불규칙하게 배치된 2차원 측선만으로 3차원 체적을 직접 추정하는 기법이다(Lee et al., 2025b). 입력은 측선 자료를 3차원 격자에 배치하여 만든 희소한 체적과 그 체적 안에서 자료가 어디에 존재하는지를 나타내는 마스크이며, 출력은 격자 전체가 채워진 체적이다.
본 기법에서 다루는 탄성파 자료는 크게 두 가지 의존성을 가지는데, 하나는 층서나 단층과 같이 자료 전반에 걸친 구조적 의존성이고 다른 하나는 주파수 특성이나 송신원 서명처럼 좁은 범위에 나타나는 조직적 의존성이다. 조직적 의존성에 민감한 기법은 미스타이와 특성 불일치에서 비롯된 국소 변동을 출력에 그대로 옮겨 놓아 구조 해석을 방해하므로, 구조적 의존성에 집중하는 보간 방식이 적합하다.
VQ-VAE 기반 인공신경망은 이러한 보간 전략에 적합한 구조이다. 이 구조는 입력을 저차원 잠재공간으로 압축한 뒤 이를 다시 복원하도록 학습한다. 압축 과정에서 세부 정보는 손실되고 자료의 전반적인 패턴이 우선적으로 보존되므로, 전역 구조가 중요한 보간에 유리한 성질을 갖는다. 이러한 구조는 광범위한 관계와 패턴을 담은 압축 표현을 학습하므로 구조적 의존성을 추종하는 데 효과적이다.
본 기법은 잡음치환 벡터양자화라는 전략을 채택하여 실제 양자화 오차를 같은 분포에서 뽑은 잡음으로 대체하여 기울기 기반의 연산이 끊어지고 역전파를 통한 학습이 성립하지 않는 변분 오토인코더의 근본적인 한계를 극복한다(Vali and Bäckström, 2022). 이 양자화 오차 를 수학적으로 표현하면 아래와 같다.
이때 와 는 각각 인코더의 출력과 그에 상응하는 코드북 벡터를 의미하며, 는 정규분포에서 표본추출한 잡음을 나타낸다. 이 식은 원래의 양자화 오차를 임의의 방향으로 회전시킨 것으로 해석할 수 있다. 이는 양자화의 기울기가 항등이 되어 역전파가 자연스럽게 성립하며, 효율적으로 계산할 수 있다는 장점을 지닌다.
본 기법의 신경망 구조는 3차원 합성곱과 활성화 함수, 그룹 정규화로 구성된 완전 합성곱 구조이다(Fig. 6). 완전 합성곱 구조를 채택한 것은 학습 단계와 추론 단계의 입력 크기가 다르기 때문이며, 이 구조는 입력 차원에 대한 제약이 없으므로 두 단계에서 동일한 신경망을 사용할 수 있다. GC-GAN 기법과 마찬가지로 인코더, 디코더 두 연산 모두 수평 방향에만 적용된다.
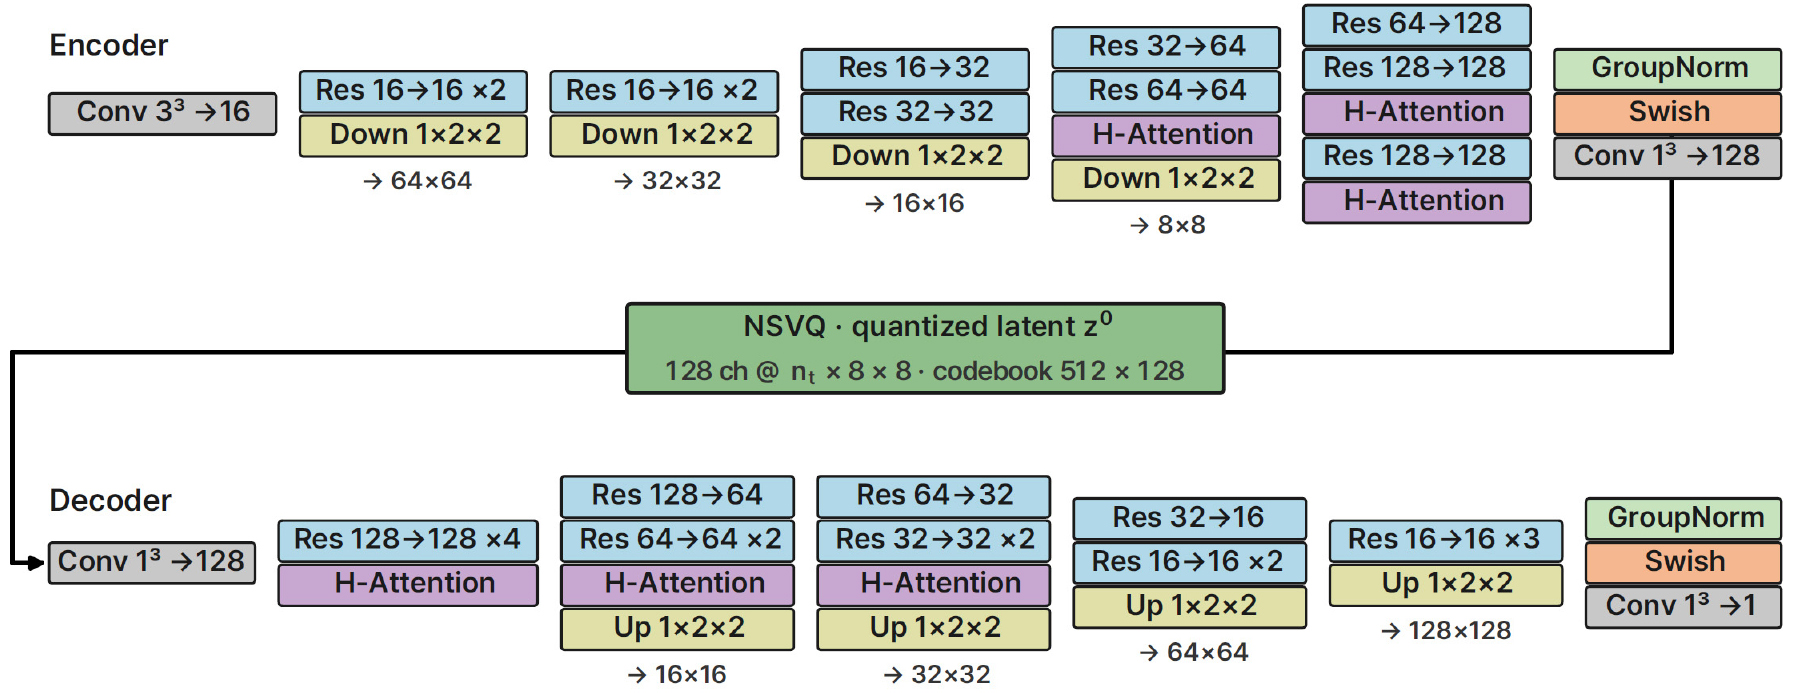
여기에 광역 층서 구조를 포착하기 위해 어텐션 모듈이 도입되었다(Vaswani et al., 2017). 학습 과정과 예측 과정에서 입력받은 자료의 시간축 길이가 다를 경우를 대비하여, 어텐션 모듈을 적용할 때 시간축을 제외하여 수평 방향의 장거리 의존성만을 포착하도록 하였다. 시간축의 자료 특징은 예측 과정에서 시간축 방향으로 작은 커널을 활용하여 반영된다.
본 기법의 학습 단계는 Fig. 7과 같다. 학습 첫 단계에서는 VQ-VAE가 라벨 체적과 시간 좌표를 입력받아 라벨 체적 자체를 복원하도록 학습한다. 이 단계의 목적은 신경망이 탄성파 자료의 특성을 파악하고, 코드북이 층서 구조와 반사면 패턴을 담아내도록 하는 데 있다. 두 번째 단계에서는 희소한 2차원 평면 입력으로부터 3차원 체적을 추정할 수 있도록 한다.
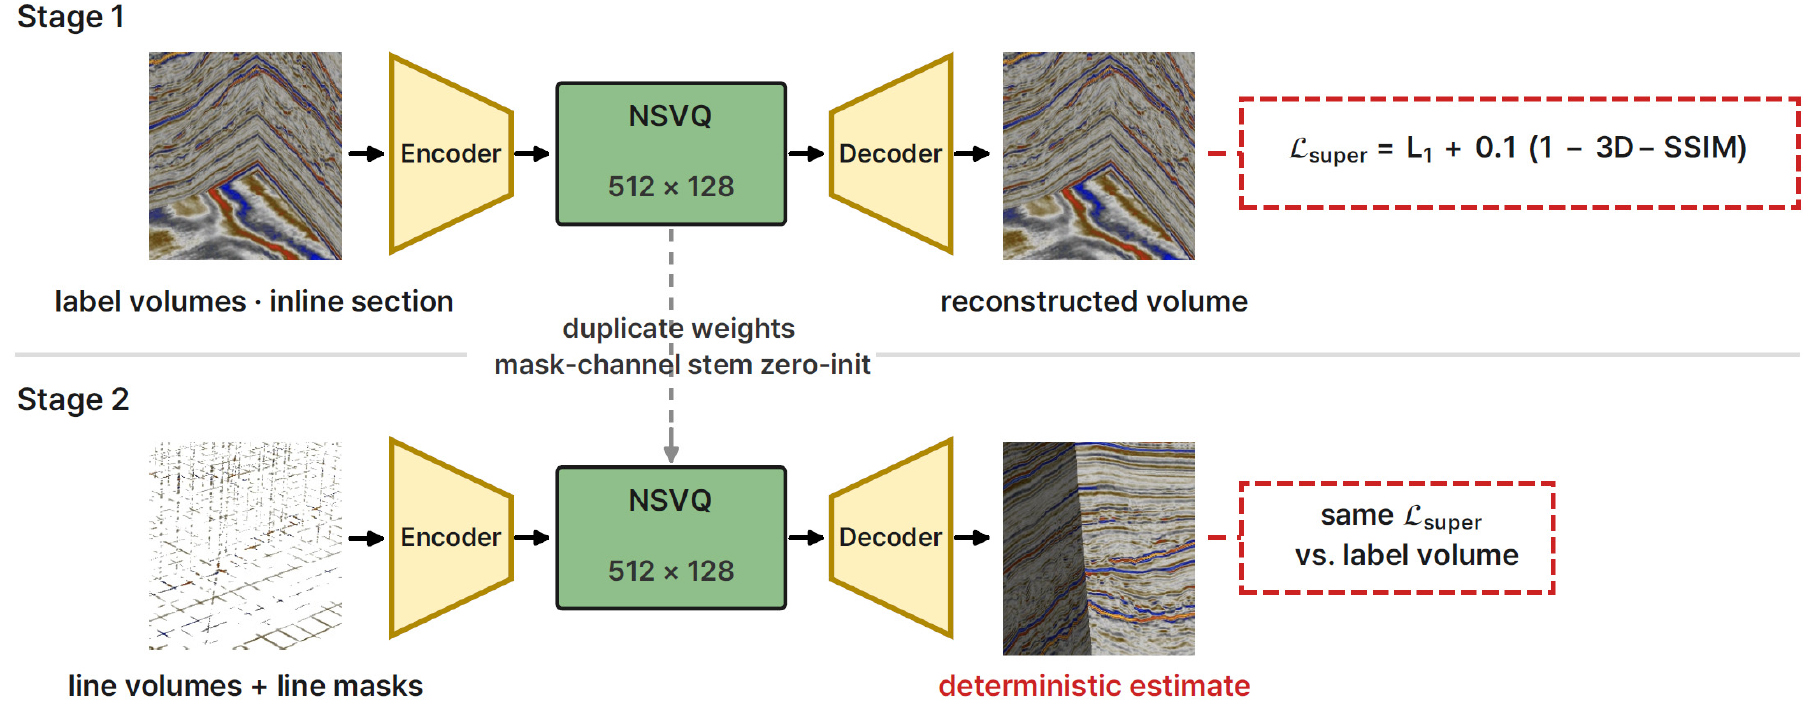
두 번째 단계의 신경망은 첫 단계의 최종 모형을 그대로 복제하여 초기화하되, 새로 추가되는 측선 마스크 채널의 가중치만은 무작위 초기화 대신 0으로 설정한다. 이렇게 하면 미세조정 초기에 새 채널이 학습을 교란하지 않고, 학습이 진행되면서 점차 그 기여가 커진다. 또한 양자화 모듈의 학습 가능한 값들을 단계적으로 적용하는 방식으로 급격한 변화를 억제한다.
생성형 인공신경망 기반 3차원 확장 기법
지하 구조의 해석은 본질적으로 불확실성을 내포한다. 측선이 수 km씩 떨어져 있으면 단층의 위치, 지층의 경사, 층서의 배열이 서로 다른 여러 구조가 동일한 관측을 설명할 수 있기 때문이다. 측선 간격의 두 배보다 짧은 측방 파장을 갖는 구조는 공간적으로 과소표본화되어 관측만으로는 유일하게 결정되지 않으며, 간격이 넓어질수록 이러한 비유일성은 심화된다.
결정론 기반 기법은 이 상황에서 여러 가능성 중 하나의 값만을 반환한다. 복셀 단위 손실로 학습된 기법은 가능한 정답들의 평균에 해당하는 값을 산출하므로, 경쟁하는 구조들이 서로 다른 극성의 진폭값을 가질 경우 그 평균은 상쇄되는 경향을 보인다. 그 결과 측선 사이의 넓은 구간에서 진폭이 뚜렷한 패턴을 보이지 못한다.
확률적 접근은 이 문제에 대응할 수 있다. 동일한 희소 입력에 대해서도 서로 다른 잠재변수를 넣으면 서로 다른 결과가 나오므로, 학습된 해 공간을 탐색할 수 있게 된다. 여러 결과로부터 복셀별 평균과 표준편차를 계산하여 불확실성 분석 또한 수행할 수 있다.
생성형 인공신경망 기반 3차원 확장 기법(GenAI 기법)은 VQ-VAE 기법에서 확보한 잠재공간 위에 생성 모형을 결합하는 방식으로 설계되었다. 전체 구조는 잡음치환 벡터양자화 기반의 VQ-VAE에 StyleGAN의 스타일 변조 기법을 결합한 형태이며, 크게 인코더, 양자화 모듈, 스타일 변조 모듈, 판별 신경망으로 이루어진다.
여기서 핵심이 되는 발상은 다양성을 진폭 영역이 아니라 잠재공간에서 만들어 낸다는 것이다. 진폭 영역에서 직접 무작위성을 도입하면 반사면이 끊기거나 지질학적으로 타당하지 않은 경사 변화가 나타나기 쉽다. 반면 VQ-VAE 기법에서 학습된 잠재공간은 대역 제한적이고 측방으로 연속적인 반사면 패턴만을 담고 있으므로, 이 공간 안에서 변이를 만들고 그 결과를 기존 디코더로 되돌리면 생성되는 모든 결과가 학습된 패턴의 범위 안에 머무르게 된다. 즉 코드북과 디코더가 학습하는 자료인 탄성파 자료의 구조적 특성을 따르도록 유도하는 셈이다. 실제로 생성 신경망 모듈과 판별 신경망 모듈은 모두 양자화 이전의 연속적인 특징을 다루고, 코드북 양자화는 생성된 잠재를 체적으로 되돌릴 때에만 적용되는데, 이 복호 시점의 양자화가 모든 결과를 학습된 이산 표현 위로 끌어당기는 역할을 한다.
생성 신경망 모듈은 사상 네트워크와 합성 모듈로 구성된다. 사상 네트워크는 정규분포에서 뽑은 무작위 벡터를 여러 층의 완전연결 신경망을 거쳐 스타일 벡터로 변환하고, 합성 모듈은 이 스타일 벡터를 이용하여 인코더가 산출한 특징의 통계량을 조절한다. 이때 사용되는 것이 적응적 인스턴스 정규화(AdaIN)이며, 아래와 같이 정의된다(Huang and Belongie, 2017).
여기서 와 는 특징의 채널별 평균과 표준편차를 의미하며, 와 는 스타일 벡터 로부터 유도할 수 있는 변환 계수이다.
입력 자료는 측선 자료가 배치된 희소한 체적, 각 측선이 각 복셀에 얼마나 기여하는지를 0과 1 사이의 연속값으로 나타낸 밀도 체적, 그리고 각 표본의 심도 위치를 담은 체적으로 구성된다. 밀도 체적은 완전히 관측된 영역과 일부만 관측된 영역, 전혀 관측되지 않은 영역을 구분할 수 있게 하여, 복원이 미관측 영역에 집중되도록 유도한다.
판별 신경망 모듈은 일반적인 생성적 적대 신경망과 달리 완성된 체적이 아니라 잠재 표현을 대상으로 판별을 수행한다. 이는 계산 부담을 크게 줄여 줄 뿐 아니라, 구조화된 잠재공간이 보다 안정적인 피드백을 제공한다는 이점이 있다.
본 기법의 전체적인 구조 및 훈련 체계는 Fig. 8과 같다. 첫 단계에서는 완전한 3차원 체적을 입력과 출력에 모두 배치하여 VQ-VAE가 탄성파 자료의 패턴을 학습하도록 한다. 이 과정에서 인코더는 연속적인 체적을 이산적인 잠재 표현으로 압축하는 방법을, 디코더는 그 표현으로부터 원본 체적을 되살리는 방법을 익힌다. 이 단계를 거치면 대역 제한적인 주파수 특성과 측방으로 연속적인 반사면, 지질학적으로 타당한 진폭 분포가 코드북과 디코더에 내재화된다. 학습이 끝나면 VQ-VAE는 동결되어 이후 단계에서는 목표 잠재 표현을 제공하고 생성된 잠재를 체적으로 되돌리는 역할만 수행한다.
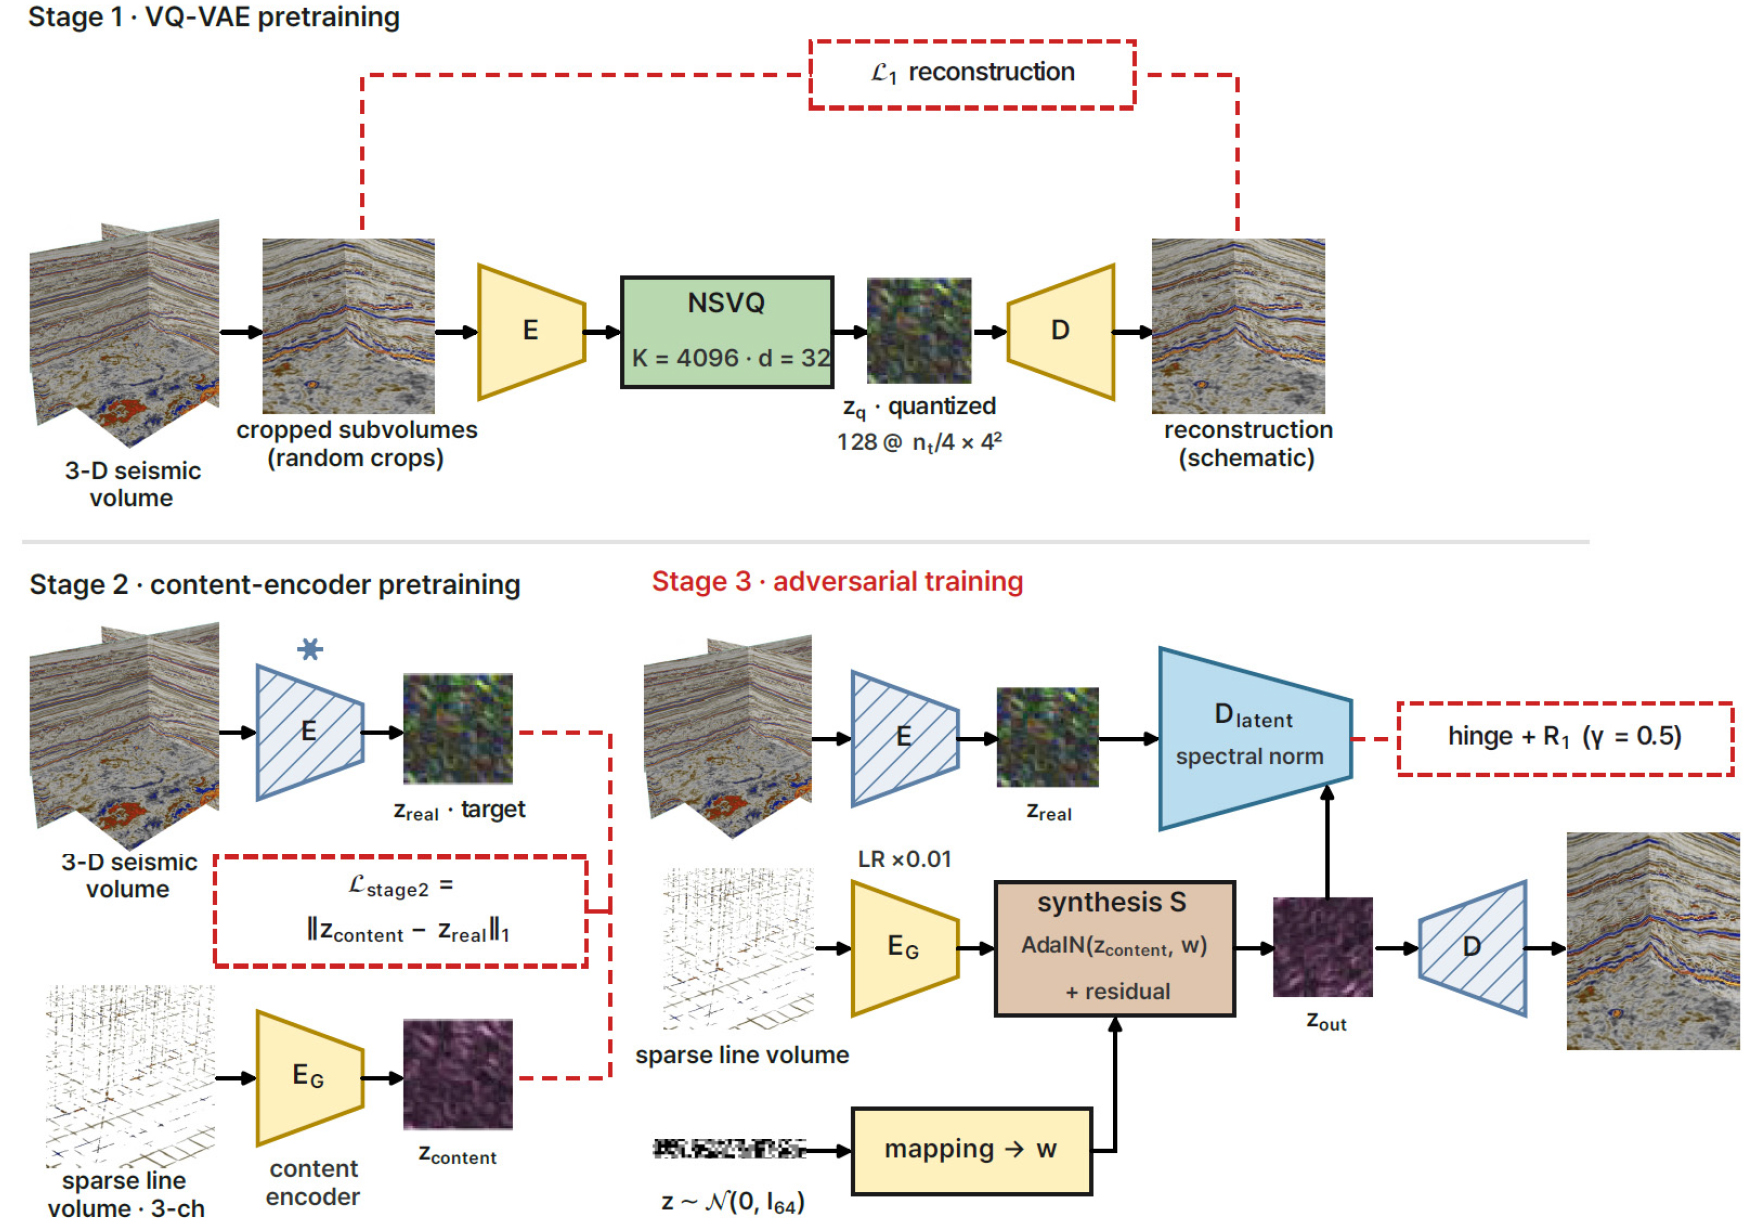
두 번째 단계에서는 희소한 측선 체적으로부터 완전한 체적에 대응하는 잠재 표현을 만들어 내도록 생성 신경망 모듈을 학습한다. 이때 목적 함수는 체적 영역이 아니라 잠재 공간에서 정의된다. 동결된 디코더가 잠재를 체적으로 되돌리는 역할을 전담하므로, 생성 신경망 모듈은 측선을 잠재 표현으로 사상하는 역할만 수행한다. 이 단계에는 측선 간격을 점진적으로 넓히는 커리큘럼이 적용되어, 처음에는 조밀한 입력으로 시작해 점차 희소한 구성을 입력한다. 난이도가 높은 재구성 작업에 신경망을 서서히 노출시켜 학습을 안정화하고 간격별로 유동적인 대응 방식을 유도하기 위함이다.
세 번째 단계에서는 확률적 요소가 도입된다. 매 반복마다 새로운 잡음 벡터를 뽑아 사상 네트워크에 통과시키고, 그 결과로 생성된 스타일 벡터가 생성 신경망 모듈의 특징을 변조한다. 판별 신경망 모듈은 이렇게 생성된 잠재 공간과 실제 체적으로부터 부호화된 잠재 공간을 구분하도록 학습되고, 생성 신경망 모듈은 그 구분을 어렵게 만들도록 학습된다. 매 반복마다 다른 스타일이 적용되므로 생성 신경망 모듈은 하나의 결정론적 해로 수렴하는 대신 가능한 결과들의 분포를 학습하게 된다.
적용 결과 및 비교분석
상술한 세 기법에 대한 검증 자료로는 모두 공통적으로 오스트레일리아 북서부 Browse 분지에서 취득된 Poseidon 3차원 해상 탐사 자료를 사용하였다(ConocoPhillips, 2012). GC-GAN 기법은 검증에 활용할 해당 자료의 일부분만을 학습하였고, VQ-VAE 기법 및 GenAI 기법은 이 자료를 학습에 전혀 사용하지 않았다. 따라서 해당 자료로 학습 자료와 지질 환경이 다른 지역에 대한 일반화 성능을 평가할 수 있다.
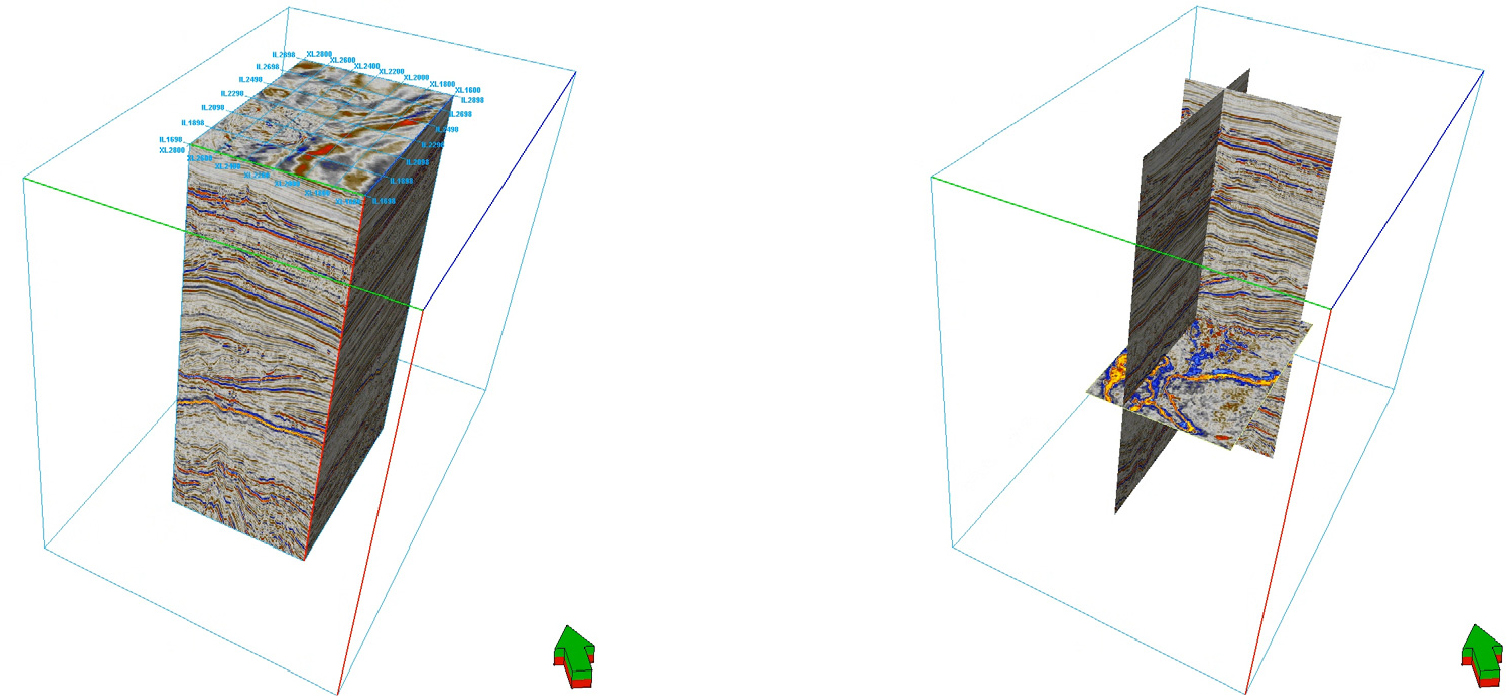
GC-GAN 기법의 검증을 위하여, 검증용 탄성파 체적 자료 일부를 사용하였다. 원본 체적의 중앙부만 남긴 채 가장자리 부분을 모두 잘라내었다. Fig. 9는 GC-GAN 기법의 검증에 활용되는 입력 자료를 직관적으로 도시한다. 가운데 위치한 작은 탄성파 자료를 바깥쪽 테두리로 구획된 범위까지 확장하는 것이 골자이다.
확장된 결과는 Fig. 10 및 11과 같다. 정답 체적과 비교했을 때 전반적으로 상당한 유사성이 관측된다. 입력 체적에 인접한 영역에서는 반사면의 연속성과 층서 구조가 원본과 거의 구분되지 않는 수준으로 재현되며, 단층으로 경계 지어진 구조나 국지적인 습곡 형태도 함께 복원된다. 이는 입력 체적이 확장 대상 영역과 지질학적인 특징 및 탄성파 성을 직접 공유하고 있어, 신경망이 참조할 수 있는 조건이 충분하기 때문이다.

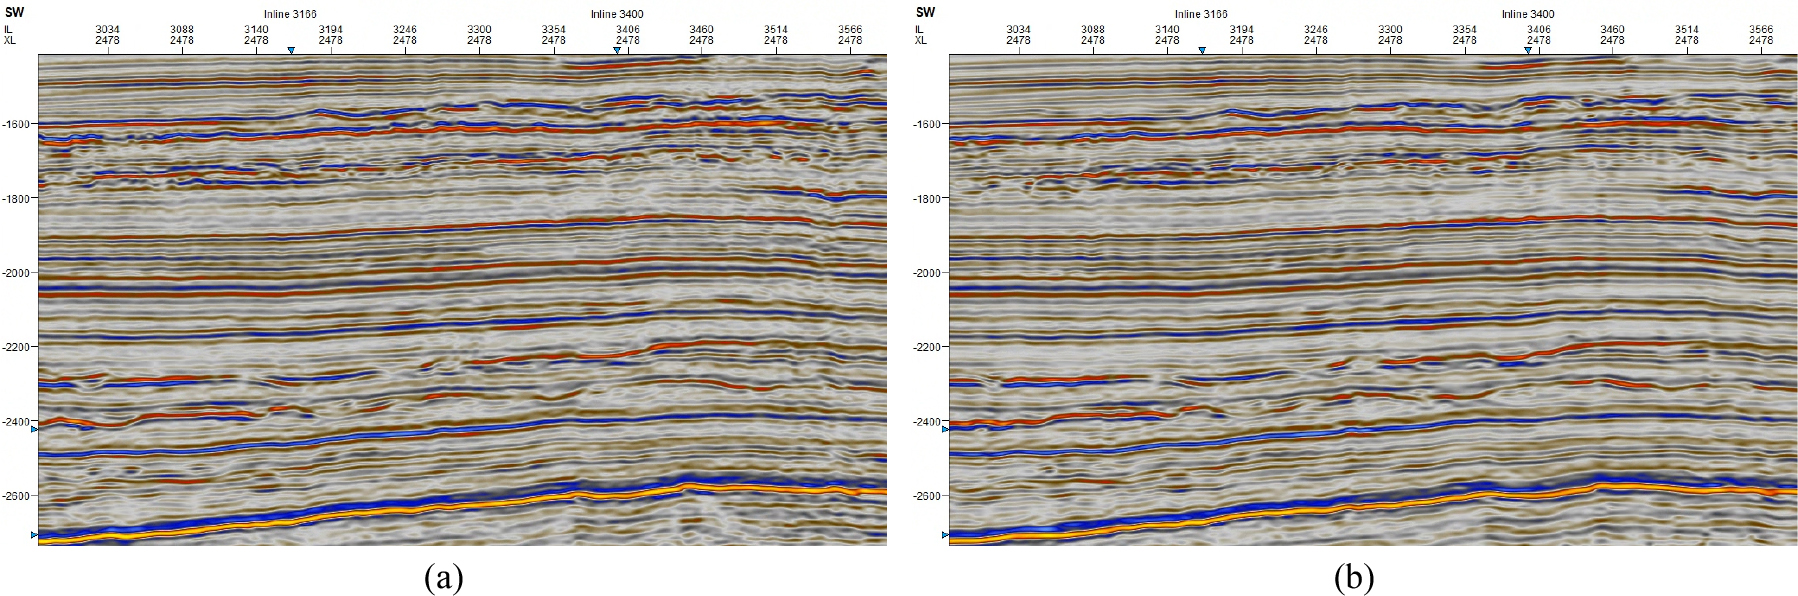
다만 입력 체적과 먼 영역에서는, 시간축을 따라 이어지는 세로 방향의 줄무늬나 지나치게 평활한 층서 구조 등이 관측된다. 본 기법은 한 번에 전체 체적을 재구성하는 것이 아니라 모서리와 변에 대해 교대로 확장을 반복하며, 각 단계의 출력이 다음 단계의 입력이 된다. 따라서 초기 단계에서 발생한 미세한 오차가 이후 단계로 전달되고, 확장이 거듭될수록 그 영향이 축적된다. 관측되는 오차는 이러한 영향에 기인했다고 해석된다.
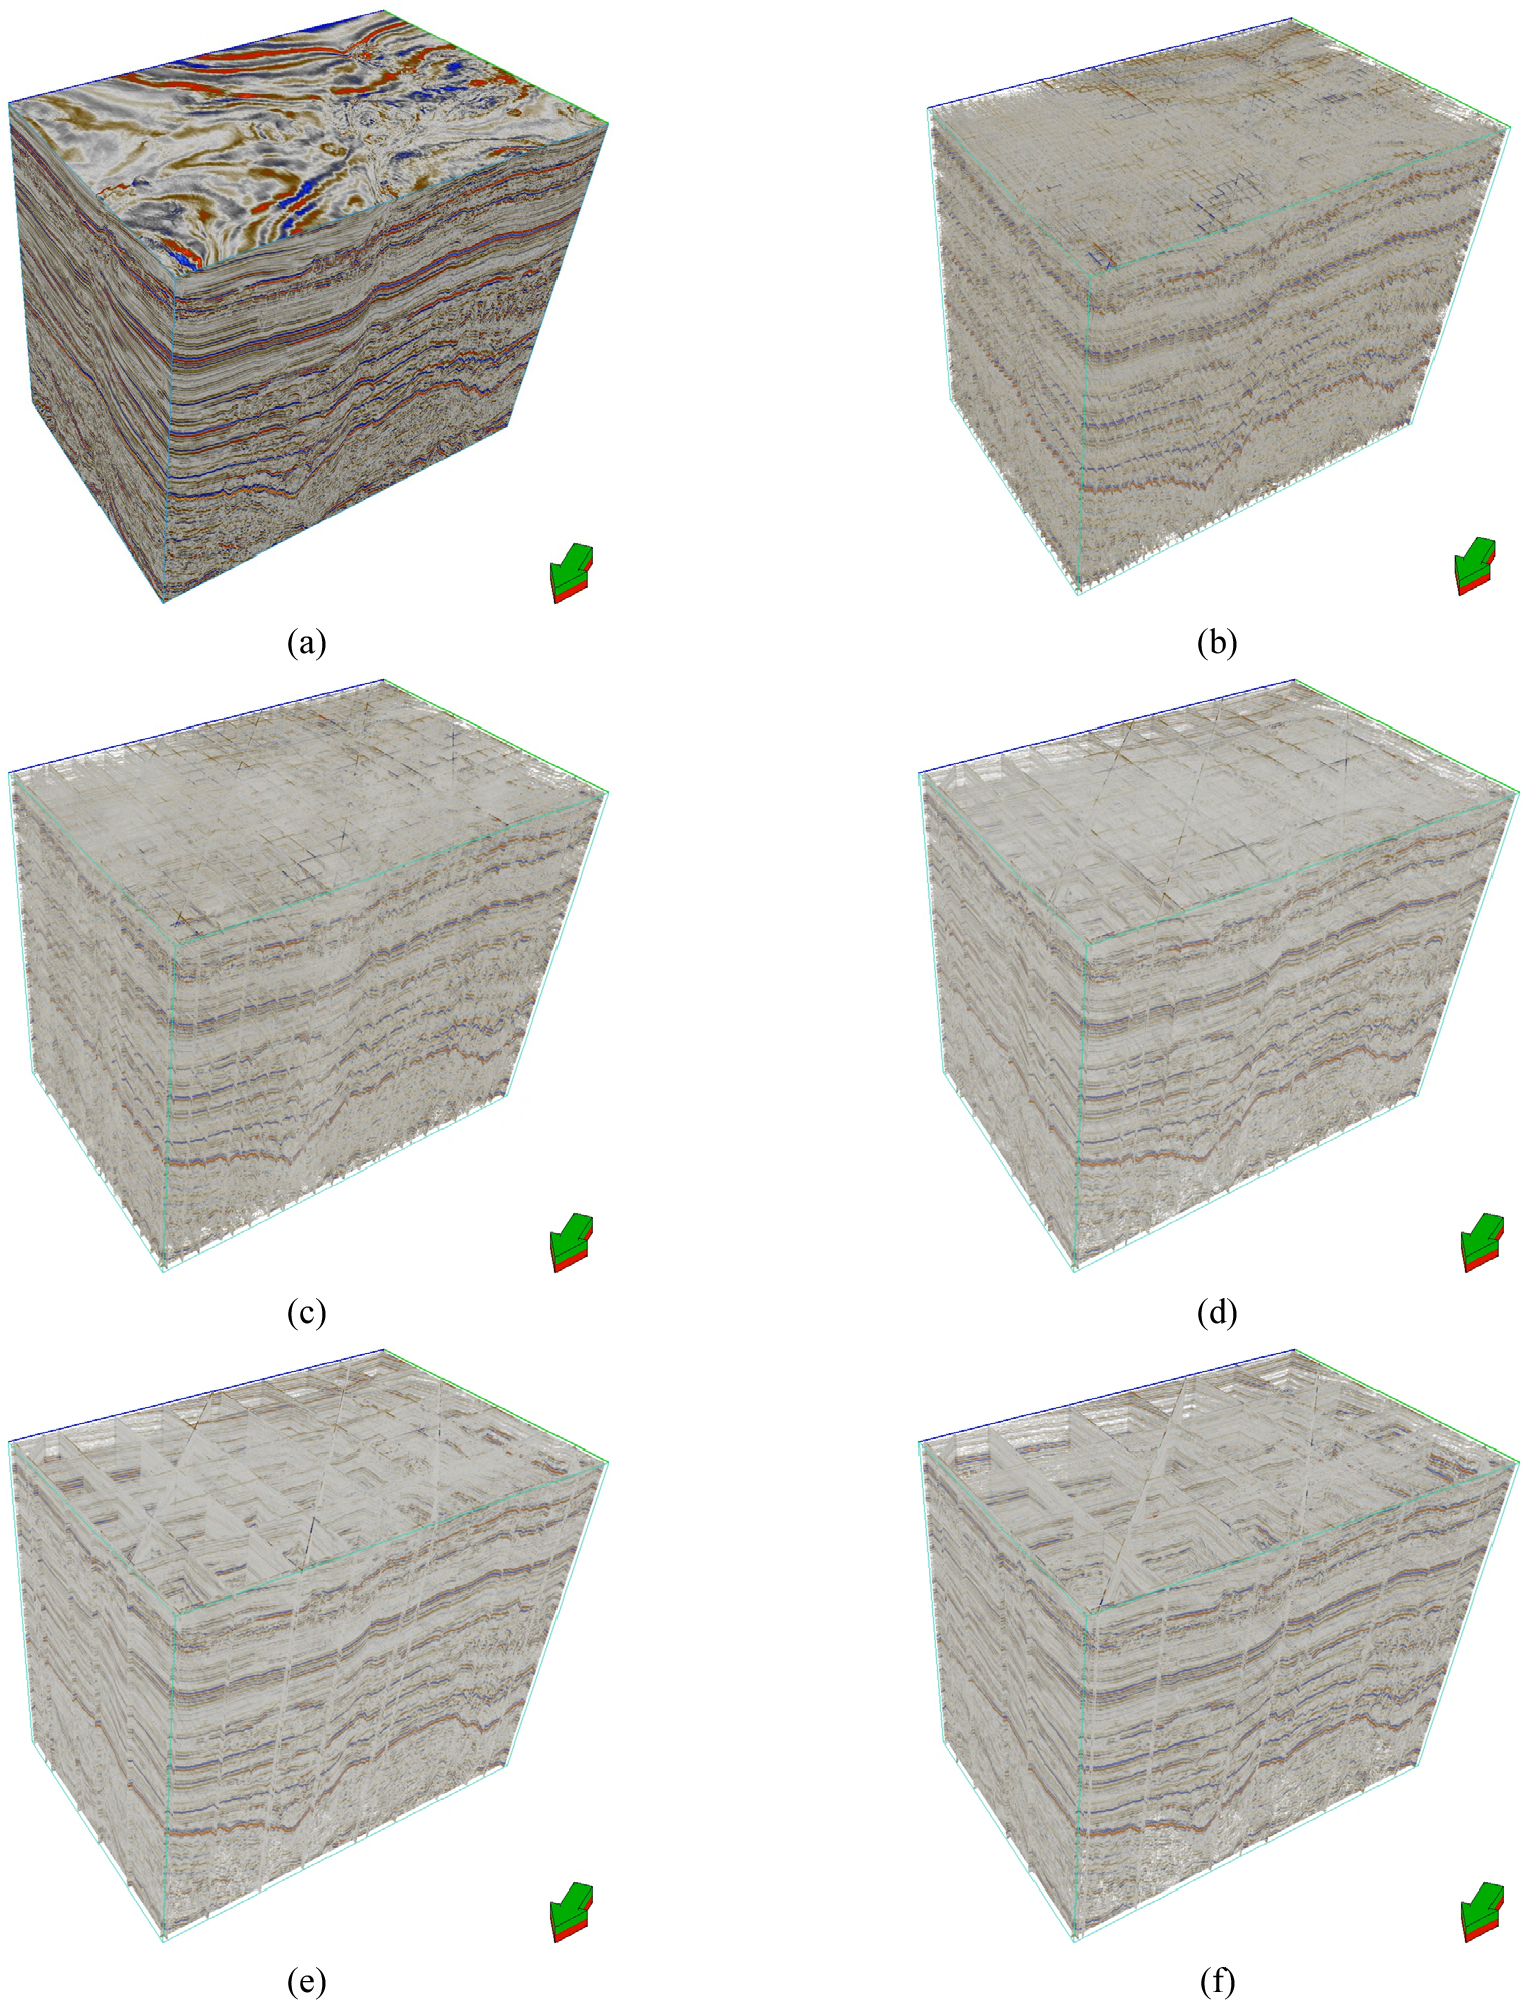
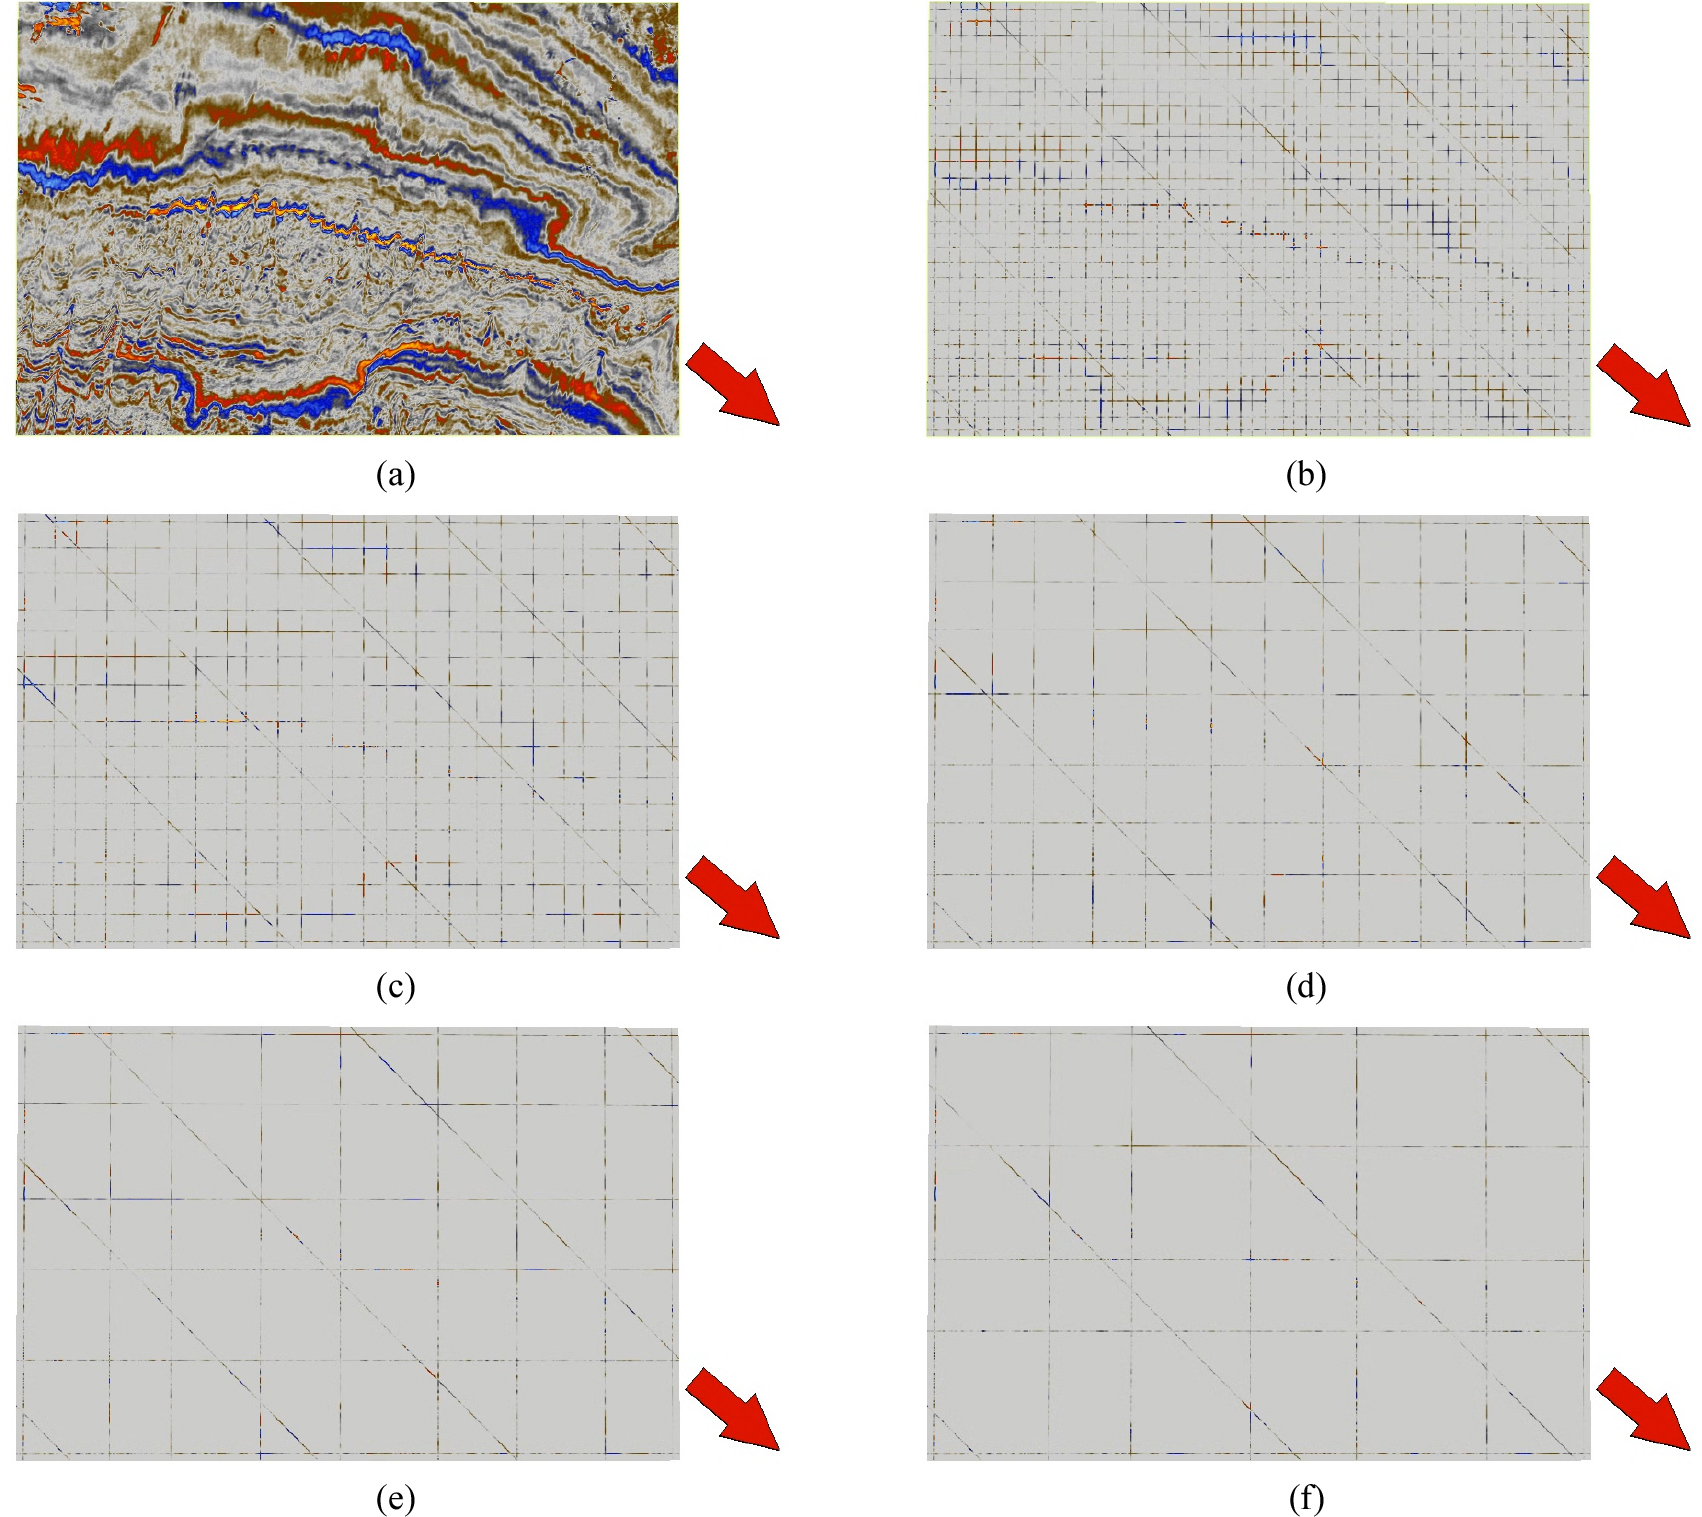
VQ-VAE 기법 및 GenAI 기법에 입력할 희소 입력은 실제 2차원 탐사 조건을 모사하도록 구성하였다. 규칙적인 격자 대신 측선의 방위와 간격을 불규칙하게 설정하였고, 45° 방향의 사선을 일정 비율 포함하였으며, 인접한 측선의 간격이 서로 같지 않도록 위치를 교란하였다. 평균 간격은 1, 2, 4, 6, 8 km로 설정하였다.
원본 검증용 체적과 다섯 가지 입력 간격에 대한 입력용 체적은 Fig. 12 및 13에 도시되어 있다. Fig. 12는 해당 입력 체적에 투명도를 주어 3차원으로 도시하였으며, Fig. 13은 입력 체적의 시간 단면을 도시하였다.
해당 입력 자료에 VQ-VAE 기법을 적용한 결과는 Fig. 14 및 15와 같다. 2차원 탄성파 평면만으로 체적을 추정한다는 점에서 적용 범위가 크게 확장되었으나, 측선 간격에 따른 성능 변화가 뚜렷하게 나타난다.
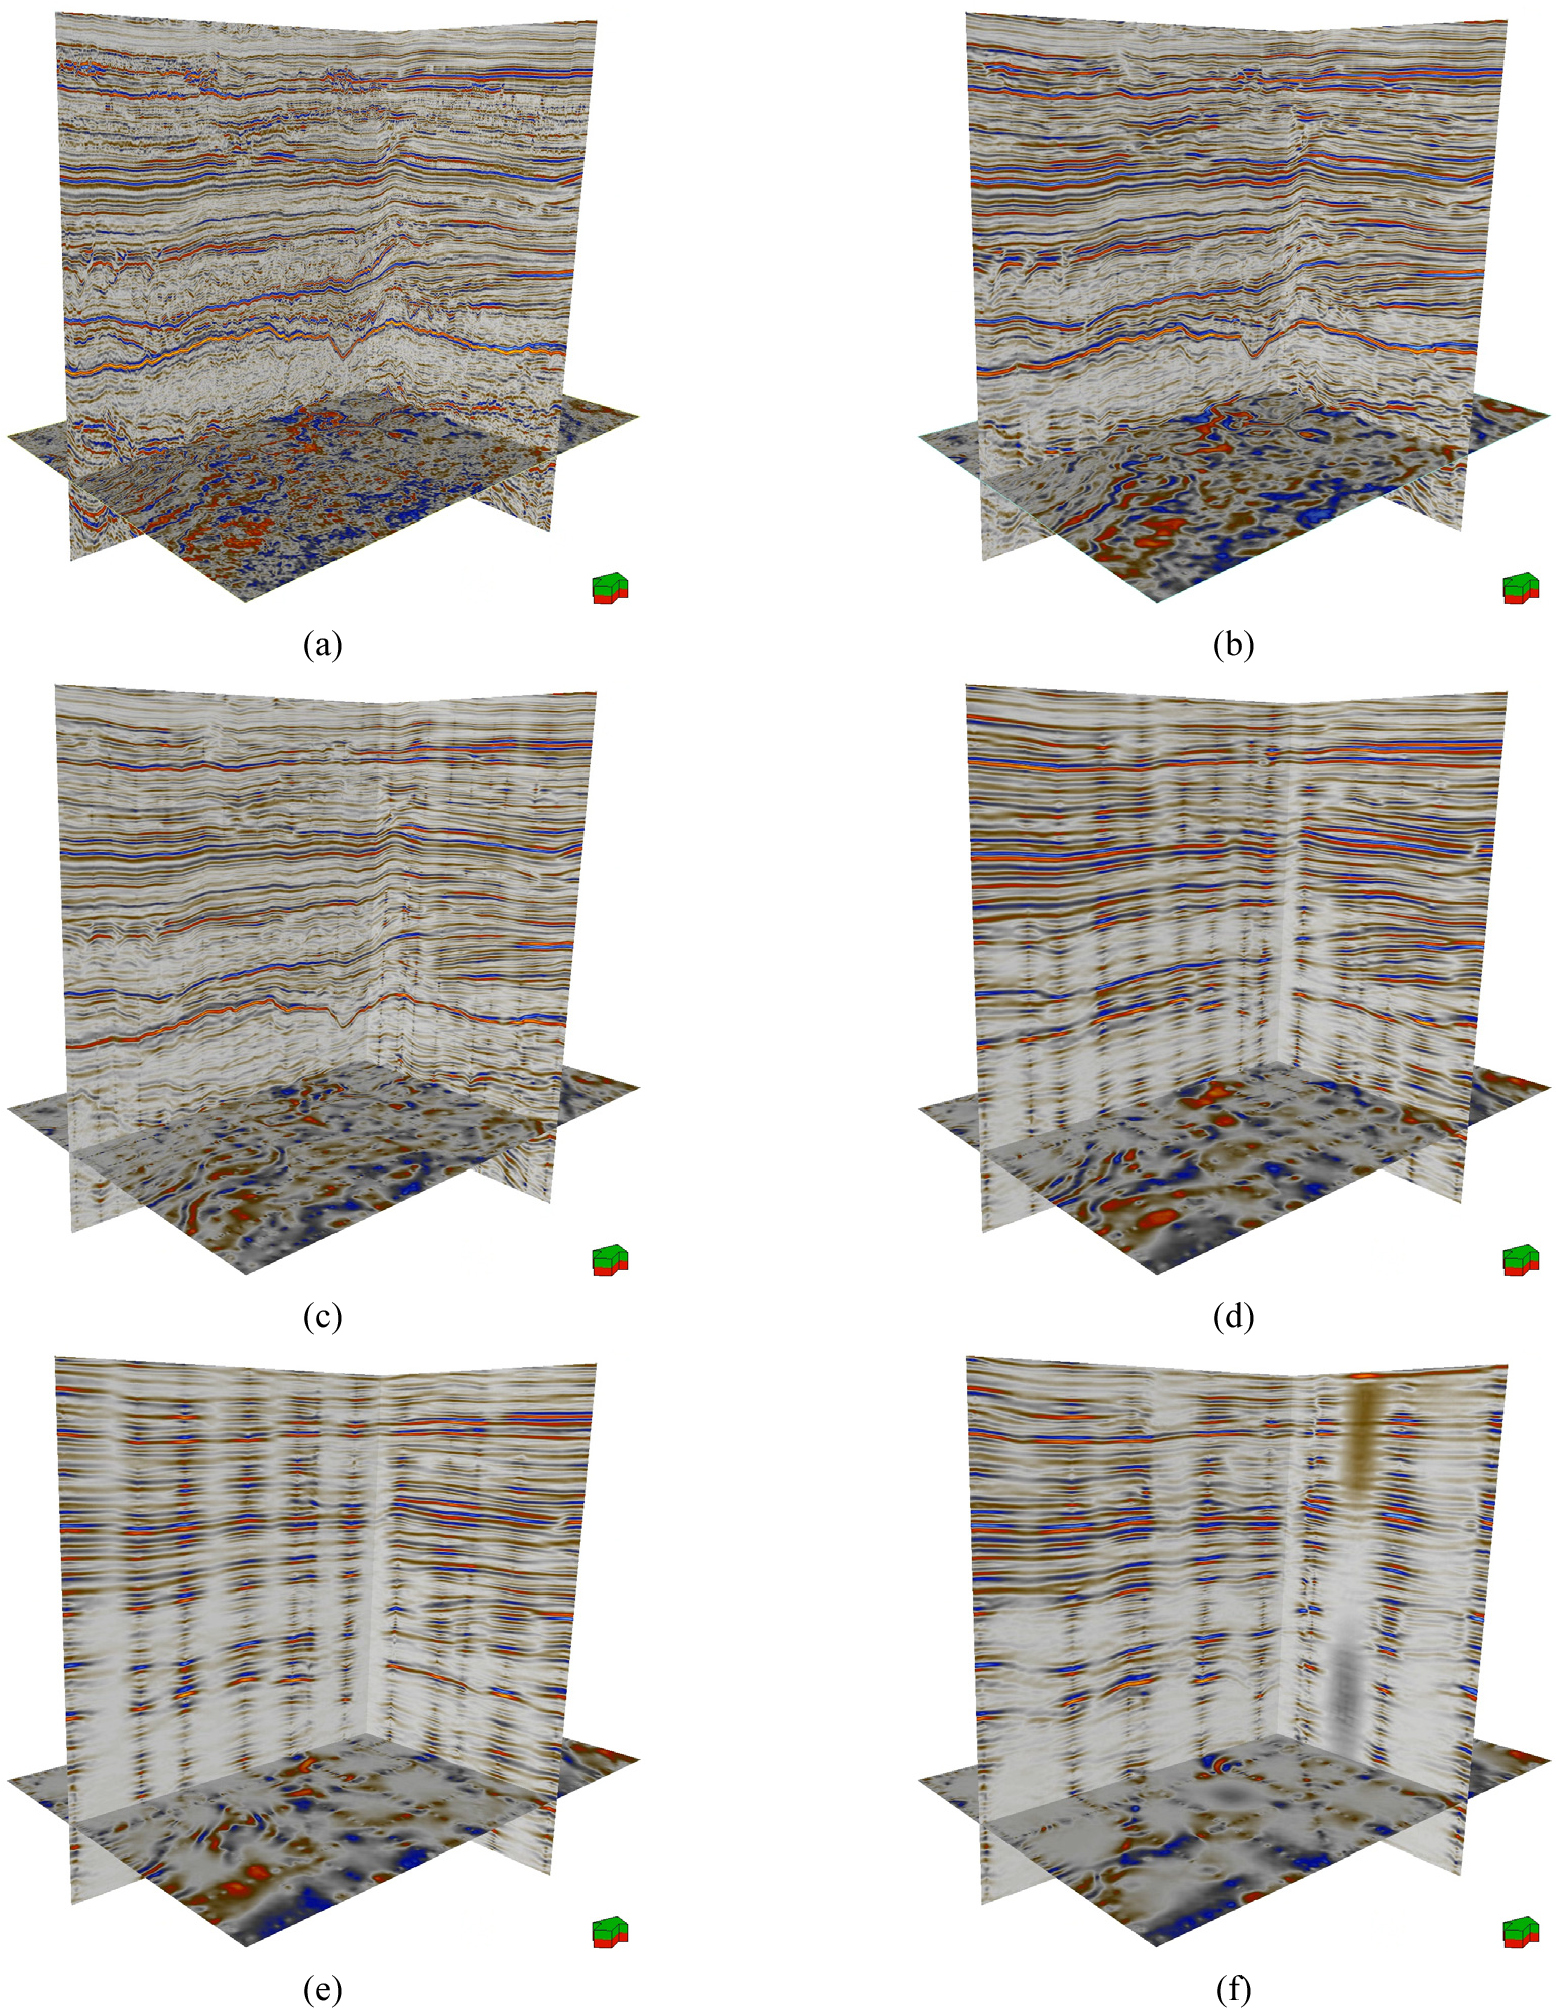
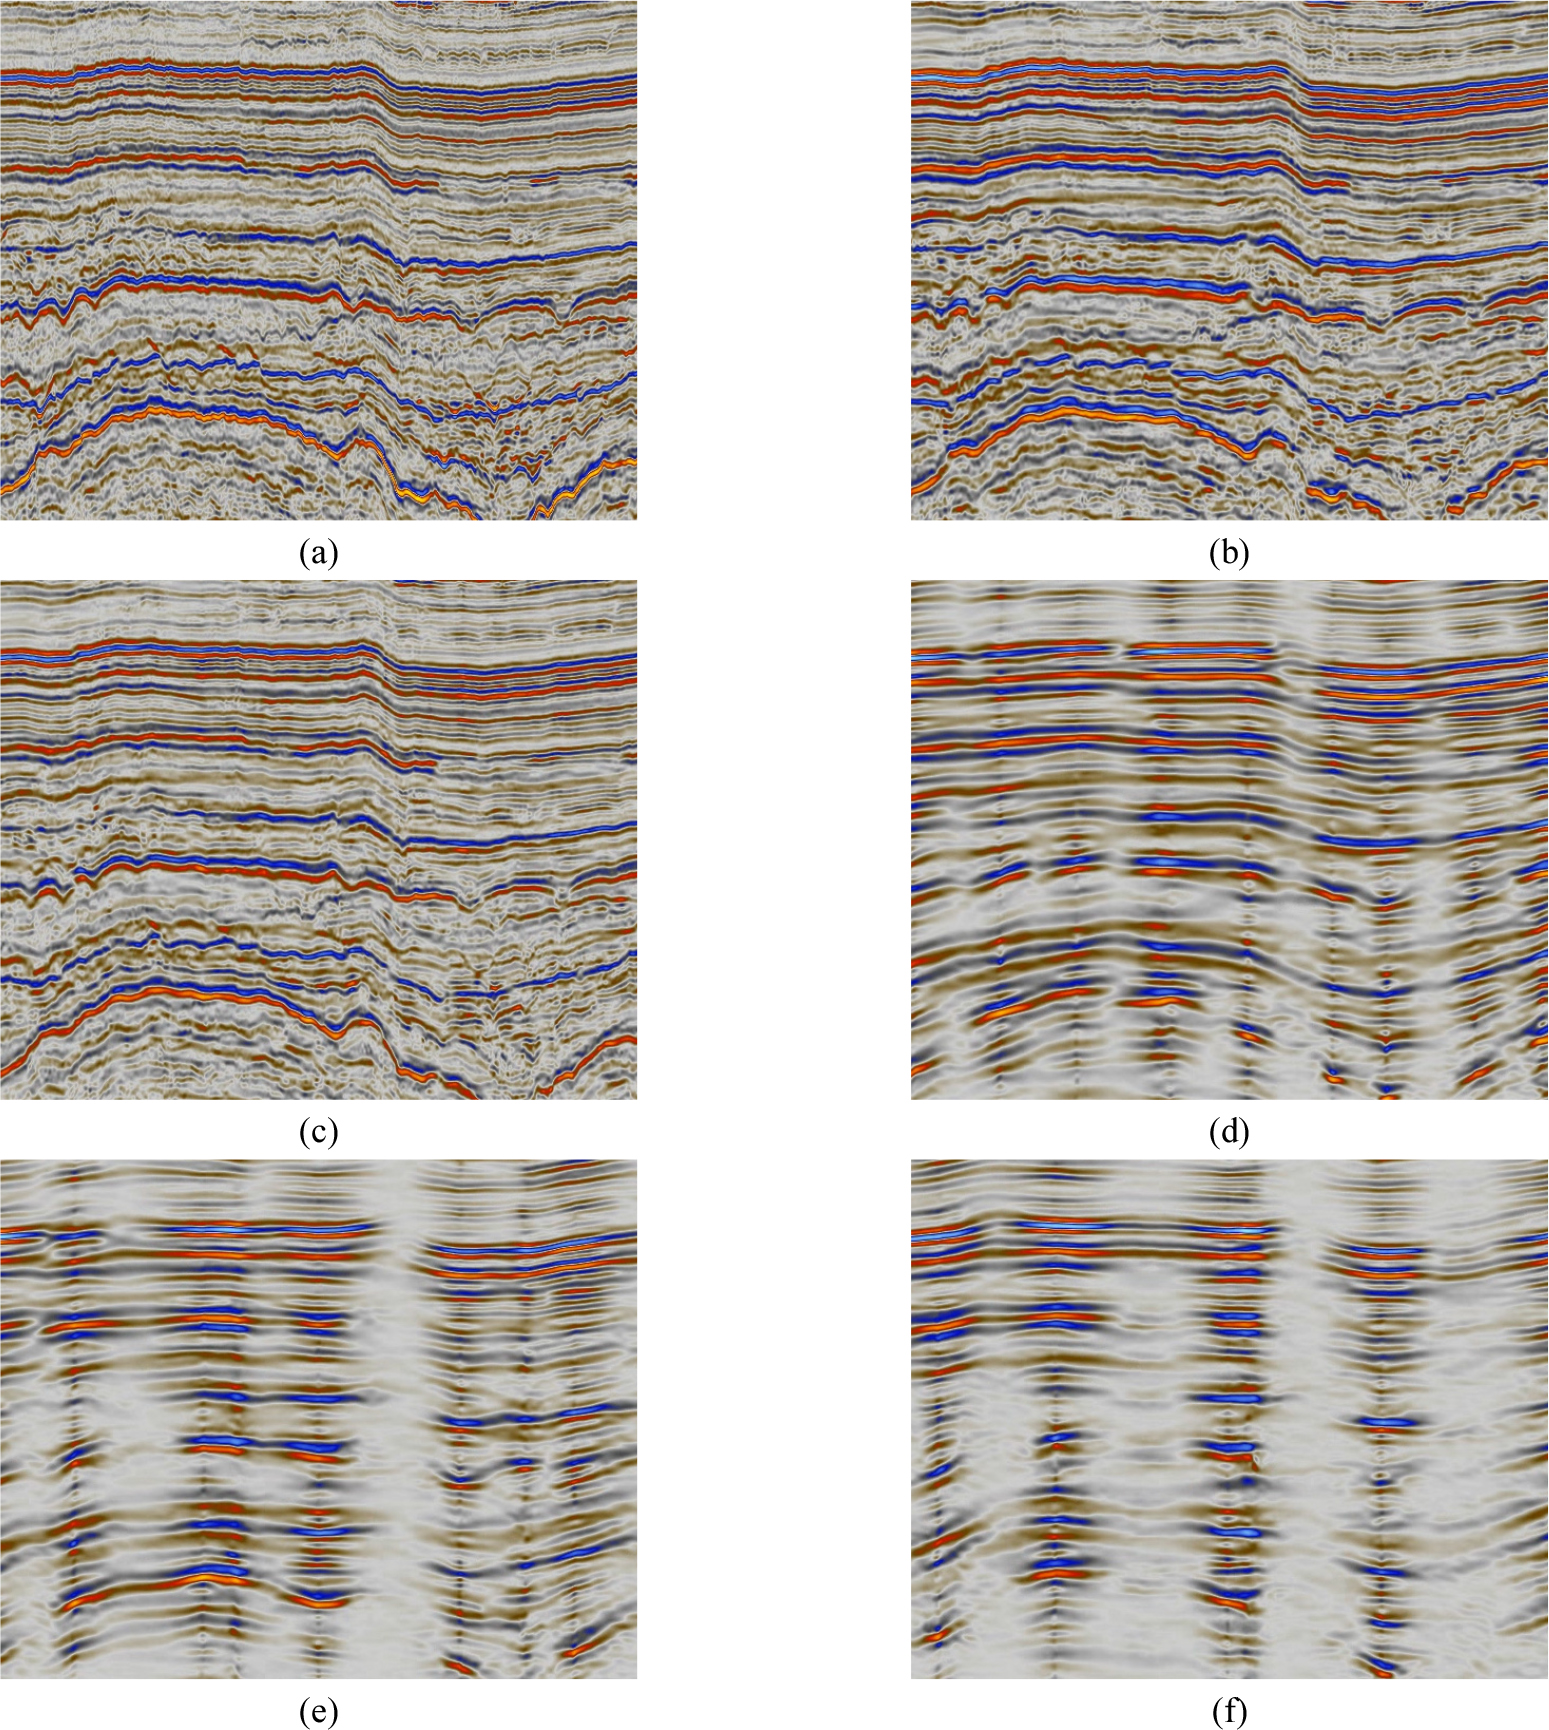
입력 간격이 1 km 및 2 km 내외인 경우 복원 결과는 상당히 양호하다. 층서의 연속성이 유지되고 주요 단층의 위치와 변위 방향이 식별 가능하며, 시간 단면에서도 구조의 평면적 분포를 읽어 낼 수 있는 수준의 결과가 산출된다. 이는 추가 탐사 대상 구역을 선별하는 데 활용할 수 있는 정보를 제공한다.
다만 간격이 4 km를 넘어서면 결과의 성격이 달라진다. 측선 사이의 넓은 영역에서 진폭이 크게 감쇠하여 사실상 비어 있는 것처럼 보이는 구간이 나타나고, 반사면은 측선이 지나가는 위치를 따라 가느다란 띠 형태로만 남는다. 시간 단면에서는 이 현상이 특히 시각적으로 뚜렷한데, 측선이 교차하는 격자 형태의 구조만이 남고 그 사이의 넓은 영역은 진폭이 0에 가까워져 붕괴하는 현상을 보인다.
복셀 단위 손실로 학습된 결정론적 모형은 주어진 입력에 대해 오차의 기댓값을 최소화하는 하나의 값을 반환한다. 측선 간격이 넓어 측선 사이의 구조가 관측만으로 결정되지 않는 상황에서는 여러 개의 서로 다른 구조가 동일한 관측을 설명할 수 있는데, 이때 모형이 반환하는 값은 그 가능한 구조들의 평균에 해당한다. 탄성파 자료는 양과 음의 진폭을 함께 갖기에, 양의 진폭값과 음의 진폭값을 모두 가질 수 있는 영역에서의 평균은 0에 가까운 값으로 수렴한다.
입력 자료의 측선 간격이 넓어질수록 빈 공간을 재구성할 수 있는 정답 시나리오의 범위는 점점 더 넓어진다. 따라서 결정론적 모형이 안정적으로 복원할 수 있는 것은 파장이 긴 대규모 층서로 한정된다. 실제로 4 km 이상의 넓은 간격의 입력 자료에서 재구성된 결과에서, 단순한 상부 층서와 대규모 단층 등의 대규모 구조는 잘 재구성되는 반면, 심부의 복잡한 구조나 소규모 단층 등은 대부분 누락된다. 정답 자료인 Fig. 15(a)와 4 km 입력자료로부터 재구성된 Fig. 15(d)를 비교해 보았을 때 관측되는 층서 구조의 과도한 평활화는 이러한 구조적 특성에 기인한다.
동일한 입력 자료에 GenAI 기법을 적용한 결과는 Fig. 16 및 17과 같다. 1 km와 2 km 간격에서는 층서 경계 구조가 원본과 유사하게 재현되며, 간격이 넓어질수록 미세한 기복과 소규모 단층의 변위가 다소 약해지지만 일차적인 층서 골격과 주요 단층의 위치는 안정적으로 유지된다. 다만 이 조건에서 복원된 단면을 VQ-VAE 기법의 결과(Fig. 15(b), (c))와 나란히 비교하면, GenAI 기법의 결과가 전반적으로 더 평활하며 정답 체적에 대한 근접도 역시 낮게 나타난다. 이는 두 기법의 설계 차이에서 비롯된 결과이다.
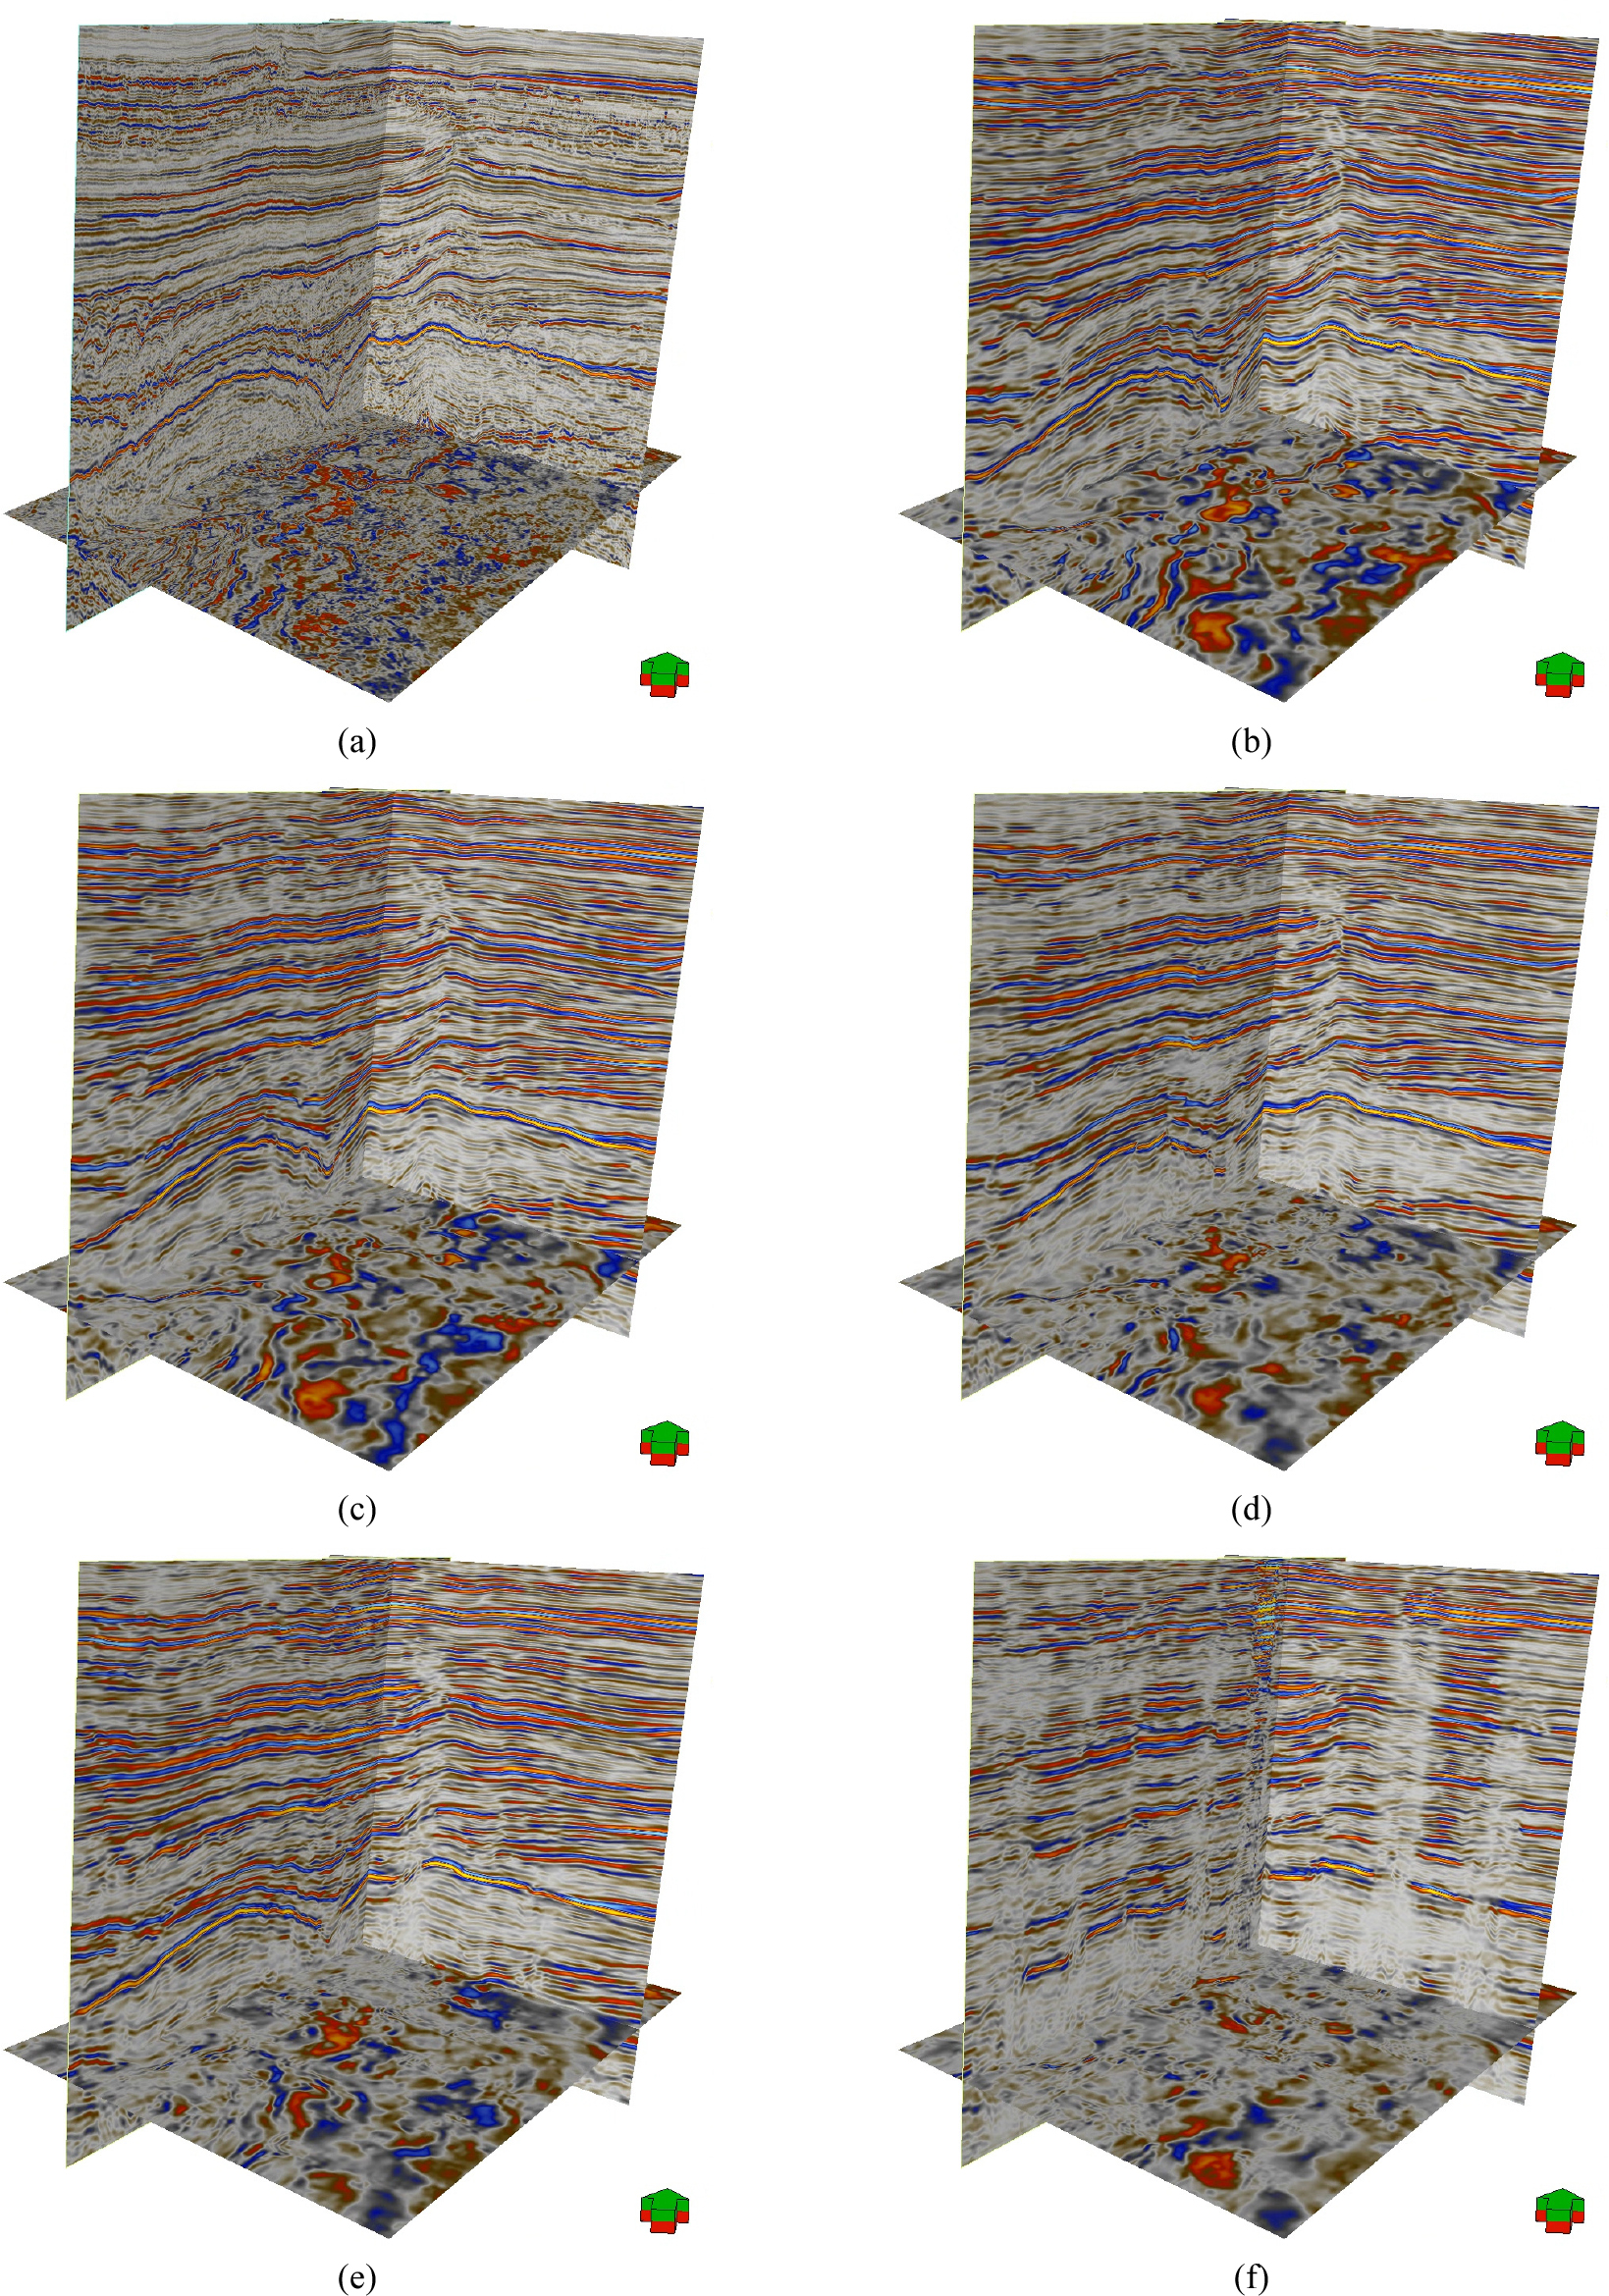
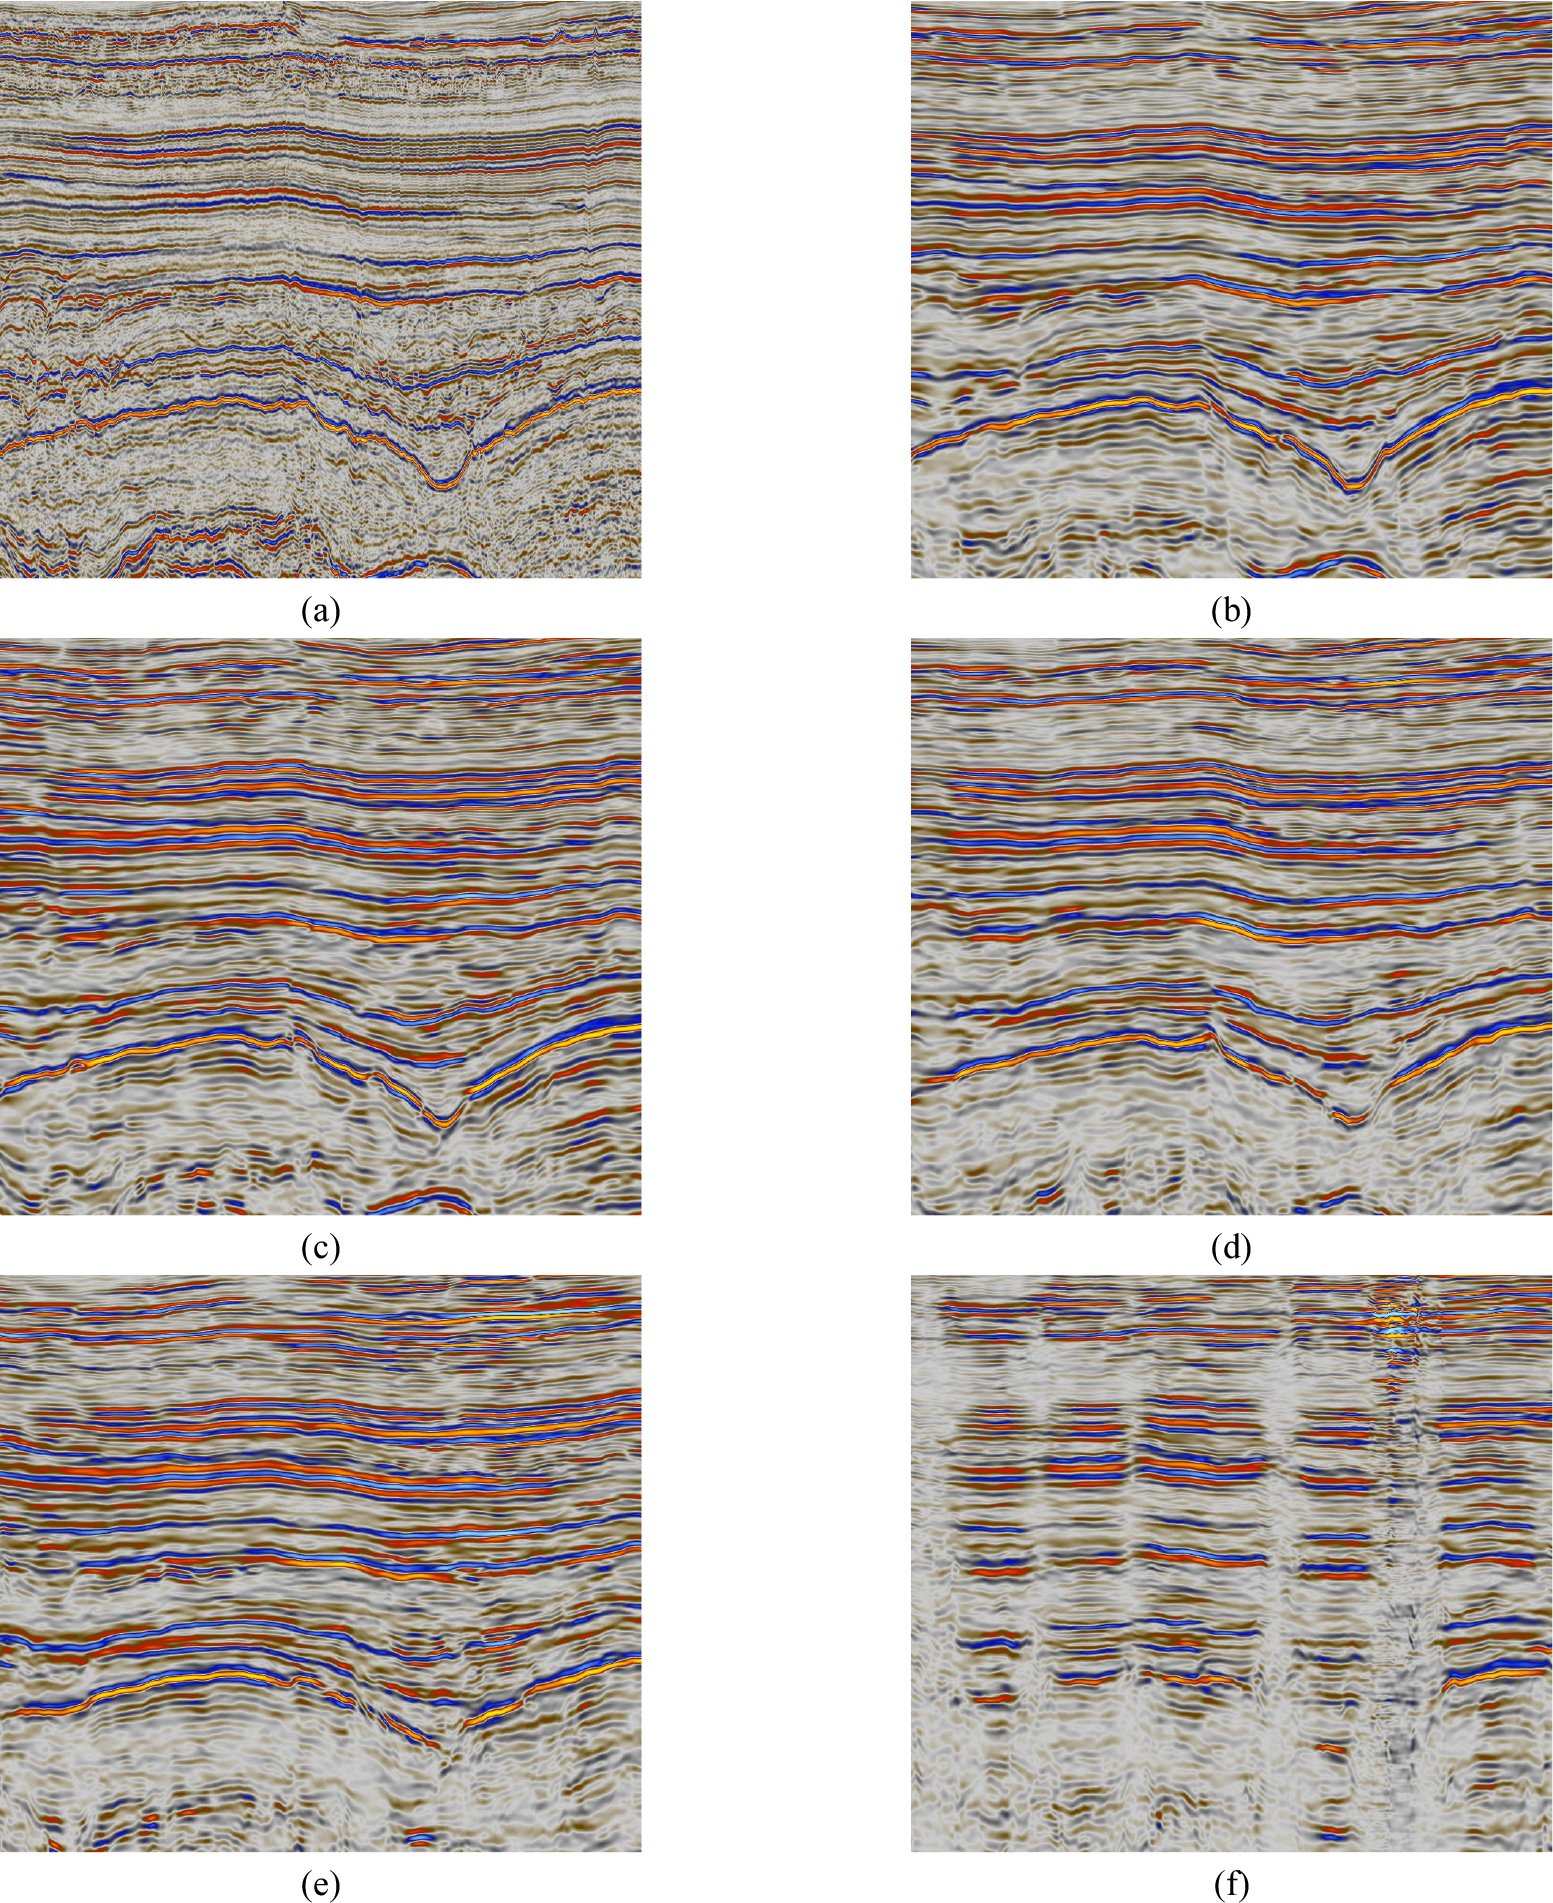
VQ-VAE 기법의 결과와 비교했을 때, 주목할 만한 차이는 4 km와 6 km 간격에서 나타난다. GenAI 기법은 측선 사이의 넓은 영역에서도 연속적인 반사면 등 거시적인 지하 구조를 복원해 낸다. 단층대 내부의 복잡한 양상이 상당 부분 단순화되기는 하나, 광역 층서의 배열과 주요 구조의 존재는 명확히 식별된다. GenAI 기법은 결정론적 기법이 붕괴되는 조건에서 해석 가능한 구조를 되살려 냈음을 보인다.
다만 재구성된 자료는 전반적으로 평활화되어 보임을 확인할 수 있다. 잠재 공간에서 재구성되는 본 기법의 특성상, 잠재 공간 내 단일 복셀(voxel)이 재구성하는 체적 영역보다 작은 영역은 입력 자료로부터 직접 복원되기보다 디코더가 학습한 일반적인 패턴으로 대체되는 경향을 보인다. 또한 본 기법의 네트워크는 학습 자료의 분포에 부합하는 여러 가능한 구조 중 상대적으로 보수적인 형태를 생성하는 경향을 보인다.
8 km 간격의 조건에서는 GenAI 기법으로 재구성된 체적 역시 결과를 신뢰하기 어려운 수준으로 붕괴하는 모습을 관찰할 수 있다. 진폭이 전반적으로 억제되고 반사면의 연속성이 끊기며, 측선 위치 부근에 국한된 수직 방향의 강한 진폭값이 나타나기 시작한다. 이러한 8 km 이상에서 나타나는 붕괴는 신경망 구조에 기인하는 것으로 분석된다. 합성곱 연산은 유한한 크기의 커널을 통해 정보를 전달하므로 한 번에 참조할 수 있는 공간적 범위에 한계가 있는데, 측선 간격이 이 범위를 넘어서면 신경망은 양쪽 측선을 동시에 보면서 그 사이로 정합적인 구조를 이어 나갈 수 없게 된다. 결과적으로 VQ-VAE와 GAN 구조에 기반한 본 기법은 측선에 고정된 특징을 증폭하는 방향으로 퇴행하며, 이것이 수직 줄무늬의 형태로 나타난다.
조밀한 조건의 입력자료를 재구성할 때는 GenAI 기법이 열세를 보이는데, 이는 우선 두 기법의 목적함수가 다르다는 점에서 기인한다. VQ-VAE 기법은 복셀 단위 손실만으로 최적화되므로 복셀 단위 지표에서 조건부 평균을 직접 겨냥한다. 반면 GenAI 기법의 목적함수는 복원항과 적대항의 가중합으로 구성되며, 적대항은 생성 결과가 완전한 체적의 분포를 따르도록 유도하는 대신 복셀 단위 정확도를 일부 감소한다.
더 본질적인 요인은 VQ-VAE의 동결 여부이다. VQ-VAE 기법은 인코더와 코드북, 디코더를 측선에서 체적을 추정하도록 체적 자체를 미세조정한다. 반면 GenAI 기법은 완전한 체적으로 학습된 VQ-VAE를 동결한 채 생성 신경망 모듈이 잠재 표현만을 생성하도록 설계되었다. 따라서 GenAI 기법의 복원 충실도는 입력 희소성과 무관하게 VQ-VAE 자체의 부호화 성능을 상한으로 갖는다. 입력이 조밀할수록 희소성에 의한 오차가 작아져 이 상한에 의해 두 기법의 격차가 커진다. 또한, 다양한 결과를 생성하는 GenAI 기법의 스타일 변조 모듈 자체가 정량적 분석에서 낮은 성능을 보인다. 스타일 벡터에 따른 미세한 변동은 정답 자료와의 복셀 단위 차이를 키우는 방향으로 작용하기 때문이다.
이러한 분석이 복원 품질 자체의 열세를 의미하지는 않는다. 4 km 이상의 간격을 가지는 입력 자료를 재구성했을 때, VQ-VAE 기법은 측선 사이 영역의 진폭이 소멸하여 구조를 읽어 낼 수 없는 반면, GenAI 기법은 연속적인 반사면과 거시적 구조를 유지한다. VQ-VAE 기법은 다양한 결과를 기대할 수 있는 영역에서 평균값을 산출하는 성격을 가지지만, GenAI 기법은 그럴듯한 구조를 생성하는 성격을 갖기 때문이다.
또한 VQ-VAE 기법과 GenAI 기법 모두 재구성된 3차원 체적에서 고주파 성분의 평활화 경향이 관찰된다. 인코더가 입력을 저차원으로 압축하는 과정과 유한한 개수의 코드북 벡터로 연속적인 신호를 표현하는 양자화 과정에서 세부 정보가 손실되기 때문이다. 정답 체적과 재구성된 체적의 공간 평균 진폭 스펙트럼을 비교하여 이를 정량적으로 분석하였고, 그 결과는 Fig. 18과 같다. 두 체적의 절대 진폭 축척이 다르므로 각 스펙트럼을 전체 면적으로 정규화하여 에너지 분포의 형상만을 비교하였으며, 최대 진폭의 절반에 해당하는 -6 dB 기준으로 유효 대역폭을 산출하였다.
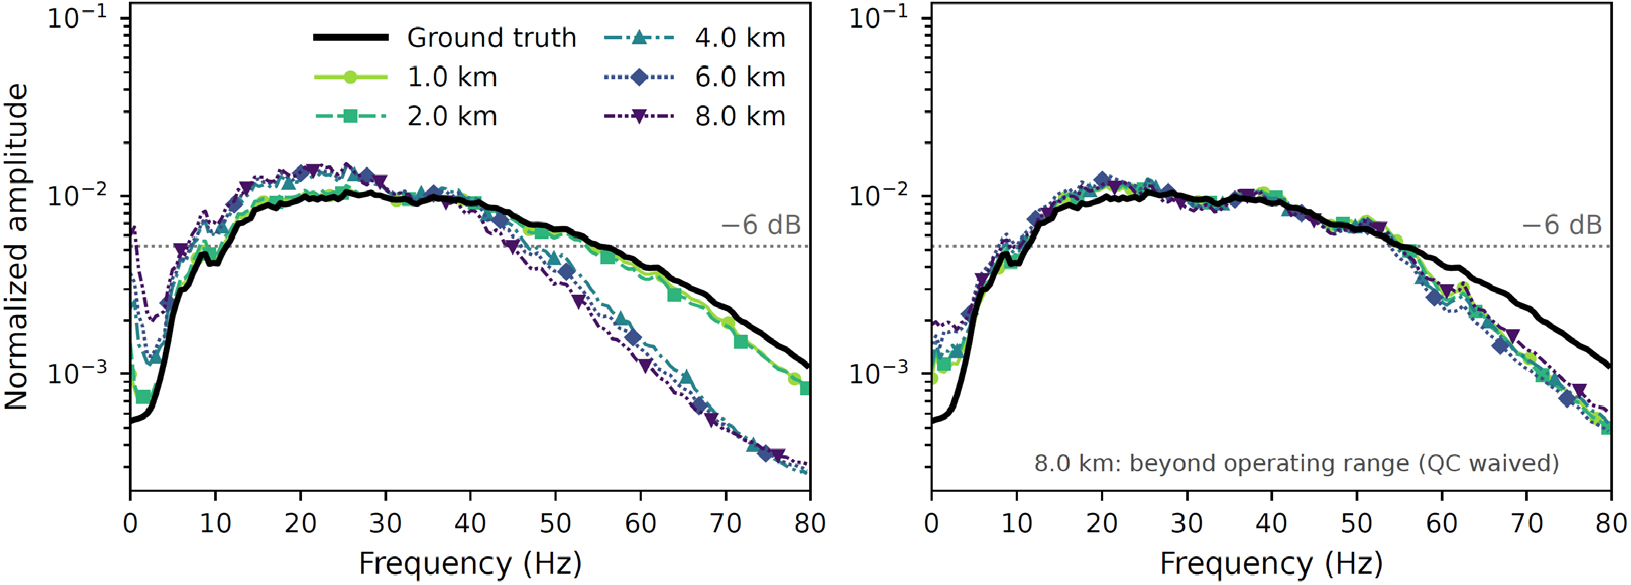
정답 체적의 -6 dB 유효 대역폭은 11.3~55.1 Hz 구간의 43.8 Hz이다. VQ-VAE 기법의 유효 대역폭은 입력 자료 간격 1 km에서 42.6 Hz, 2 km에서 41.2 Hz로 정답에 근접하지만, 4 km에서 32.4 Hz, 6 km에서 30.8 Hz, 8 km에서 30.3 Hz로 급격히 축소된다. 특히 넓은 입력 자료 간격에서는 고주파 에너지의 절반가량이 소실된다. 반대로 10 Hz 이하 저주파 대역의 비중은 1.10에서 2.10으로 증가하는데, 이는 저주파 에너지가 절대적으로 증폭되었기 때문이 아니라 고주파 성분이 줄어든 데 따른 상대적인 결과이다.
반면 GenAI 기법은 간격이 넓어져도 대역폭을 비교적 잘 유지하는 양상을 보인다. 유효 대역폭은 1 km에서 42.4 Hz, 2 km에서 42.4 Hz, 4 km에서 41.3 Hz로 거의 변화가 없으며, 6 km에서 35.0 Hz로 감소한다. 고주파 대역의 비중도 0.90에서 0.80 범위에 머물러, 같은 조건의 VQ-VAE 기법에 비해 훨씬 완만한 감소폭을 보인다. 특히 4 km 조건에서 두 기법의 유효 대역폭은 각각 32.4 Hz와 41.3 Hz로 9 Hz 가까운 차이를 보인다.
이러한 차이는 두 기법의 학습 방식에서 비롯된다. VQ-VAE 기법은 측선 사이 가능한 구조들의 평균을 산출하며, 위상이 조금씩 어긋난 세부 반사면들이 이 과정에서 상쇄된다. 이 상쇄는 파장이 짧은 성분일수록 심하게 작용하므로 고주파 대역의 감쇠로 나타난다. 반면 GenAI 기법은 기법 특성상 잠재 공간의 분포를 따르도록 유도하므로, 생성 결과가 과도하게 평활해지는 것을 억제한다. 다만 두 기법 모두 정답 체적의 대역폭을 완전히 회복하지는 못한다는 후속 과제를 남긴다.
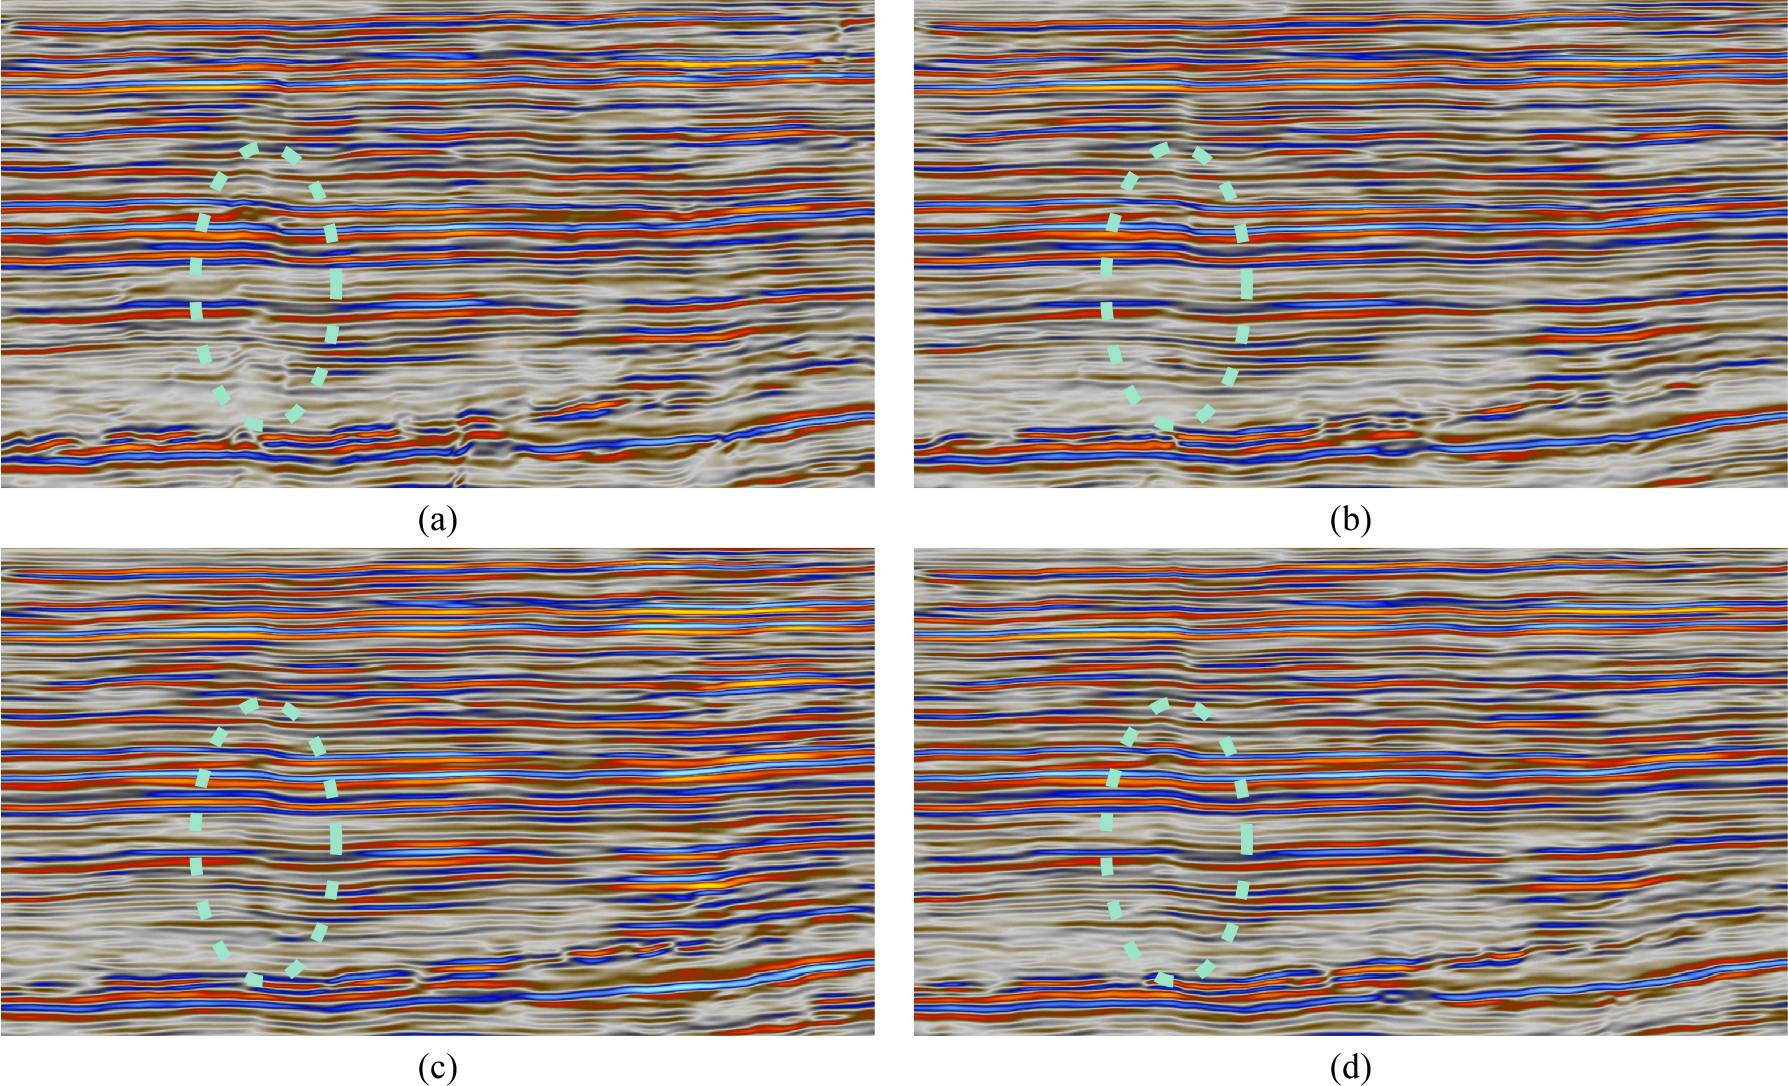
GenAI 기법에서, 동일한 4 km 간격의 입력자료에 대해, 무작위한 잡음이 입력에 함께 추가되어 상이하게 재구성된 4개의 체적의 단면은 각각 Fig. 19 및 20과 같다. 이들은 전반적으로 유사한 층서 구조를 공유하지만, 세부적인 부분에서는 각 Figure 내 녹색 표시된 부분과 같이 상이한 결과를 보인다. 이는 사상 네트워크에 잡음이 함께 입력되는 GenAI 기법의 구조에 기인한다. 결론적으로, 사용자가 지정할 수 있는 잡음의 정도는 재구성되는 결과들의 다양성과 보수적인 접근 간의 트레이드오프를 유발한다. 즉, 결과를 이용하는 목적에 따라 보수적인 요약과 폭넓은 시나리오 탐색 사이에서 선택이 가능하다는 함의를 갖는다. 다만 개별 결과가 여러 결과의 평균보다 더 많은 고주파 성분을 보존한다는 점에 유의해야 한다. 평균을 취하는 과정에서 결과마다 위치가 조금씩 다른 세부 구조가 상쇄되기 때문이며, 따라서 안정적인 요약이 필요할 때는 평균을, 세부 구조를 살펴보고자 할 때는 개별 결과를 사용하는 것이 적절하다.
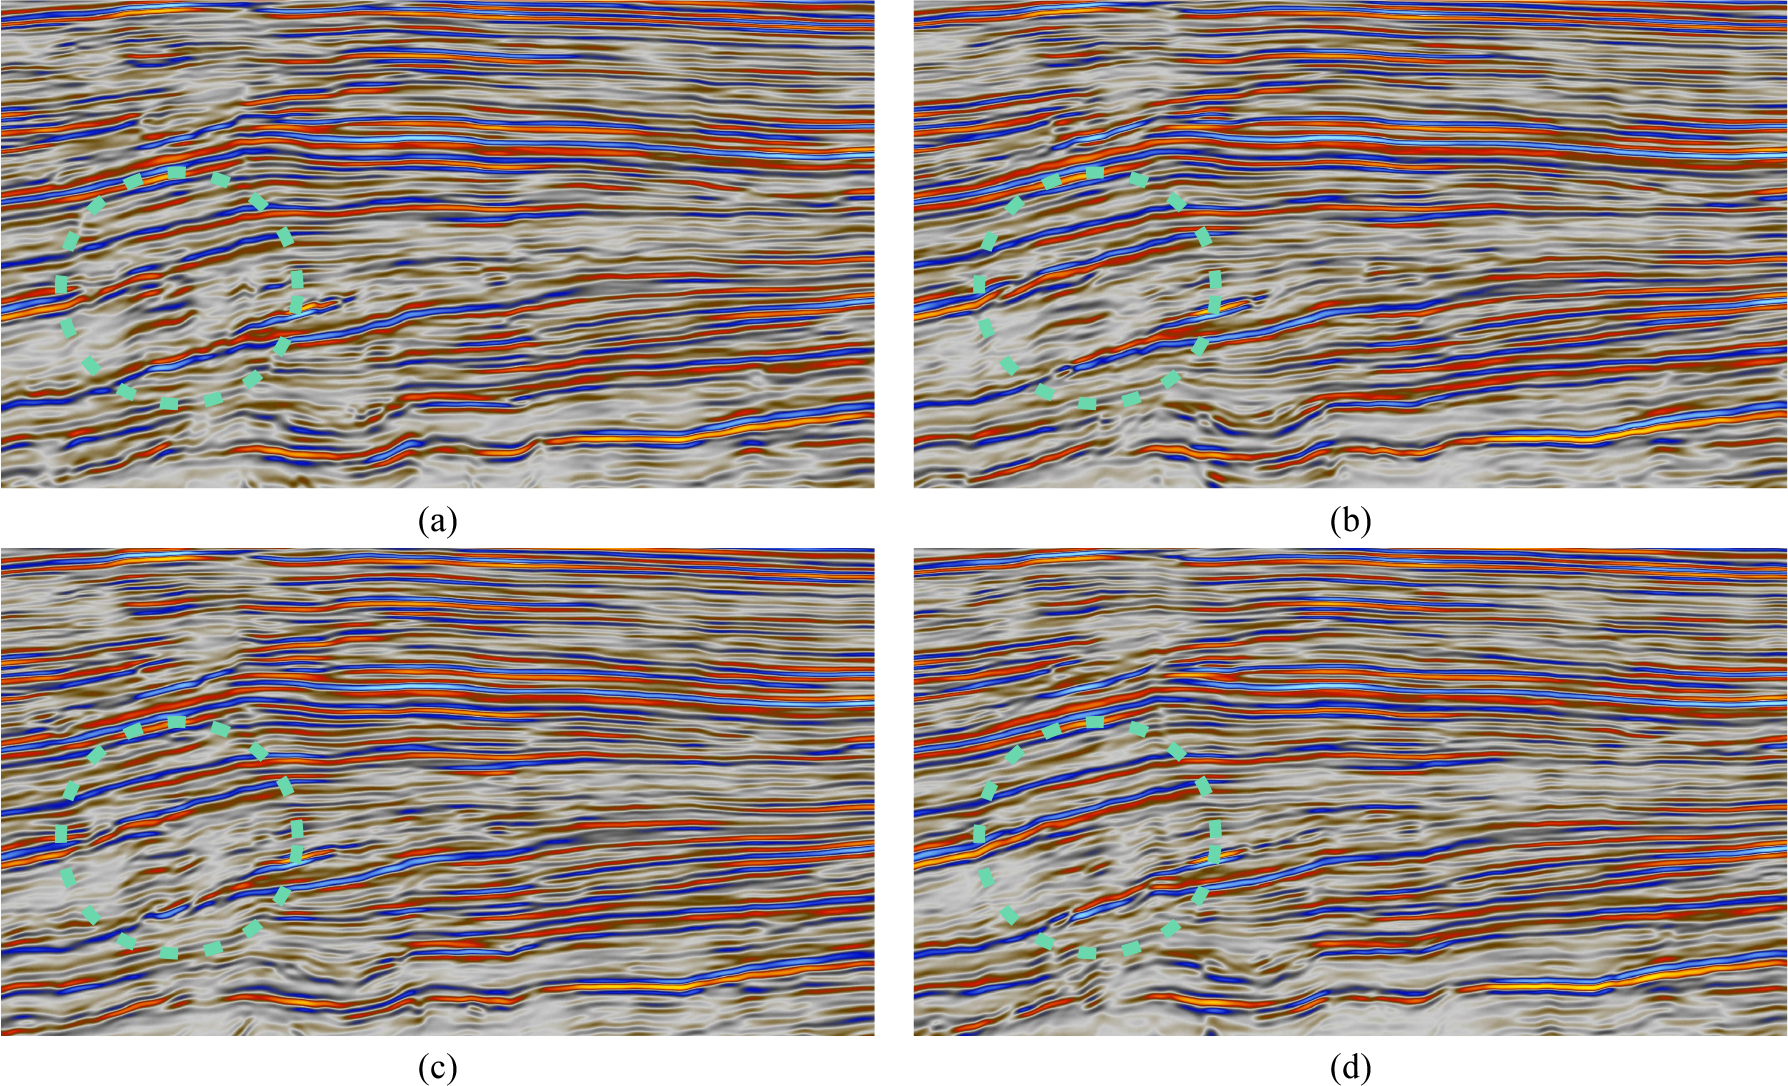
세부적으로는 단층이 밀집한 구간이나 심부의 복잡한 구조 영역에서 변동이 크게 나타나는 모습을 확인할 수 있다. 반면 층서가 단순하게 이어지는 영역은 잡음 스케일을 높게 설정하였을 때에도 공통적으로 유지된다. 이는 본 기법이 스타일 변조가 가해져도 결과가 크게 달라질 여지가 없는 구역과 여러 타당한 배치가 공존하므로 스타일에 따라 서로 다른 구조를 선택할 수 있는 구역을 제시할 수 있음을 보인다. 잡음 크기를 과도하게 높이면 신경망에 적용되는 변동이 체적 전반으로 확산되어 불안정한 재구성 성능을 보이므로, 잡음 스케일의 과도한 설정은 바람직하지 않다.
잠재 벡터의 잡음 스케일이 결과의 다양성에 미치는 영향을 정량적으로 확인하기 위해, 측선 간격 4.0 km 입력에 대해 잡음 스케일을 20, 50, 100, 150, 200으로 바꾸어 각각 10개의 실현값을 생성하고 복셀별 표준편차를 계산하였다(Fig. 21). 표준편차는 잡음 크기가 커질수록 단조 증가하여, 정규화 진폭 기준 평균값이 0.017에서 0.048로 약 2.8배 증가하였다. 잡음 크기가 클수록 국소적으로 표준편차가 큰 영역이 뚜렷해졌으며, 이는 사용자가 잡음 크기를 조정하며 다양성과 충실성 간 균형을 조절할 수 있음을 보인다.
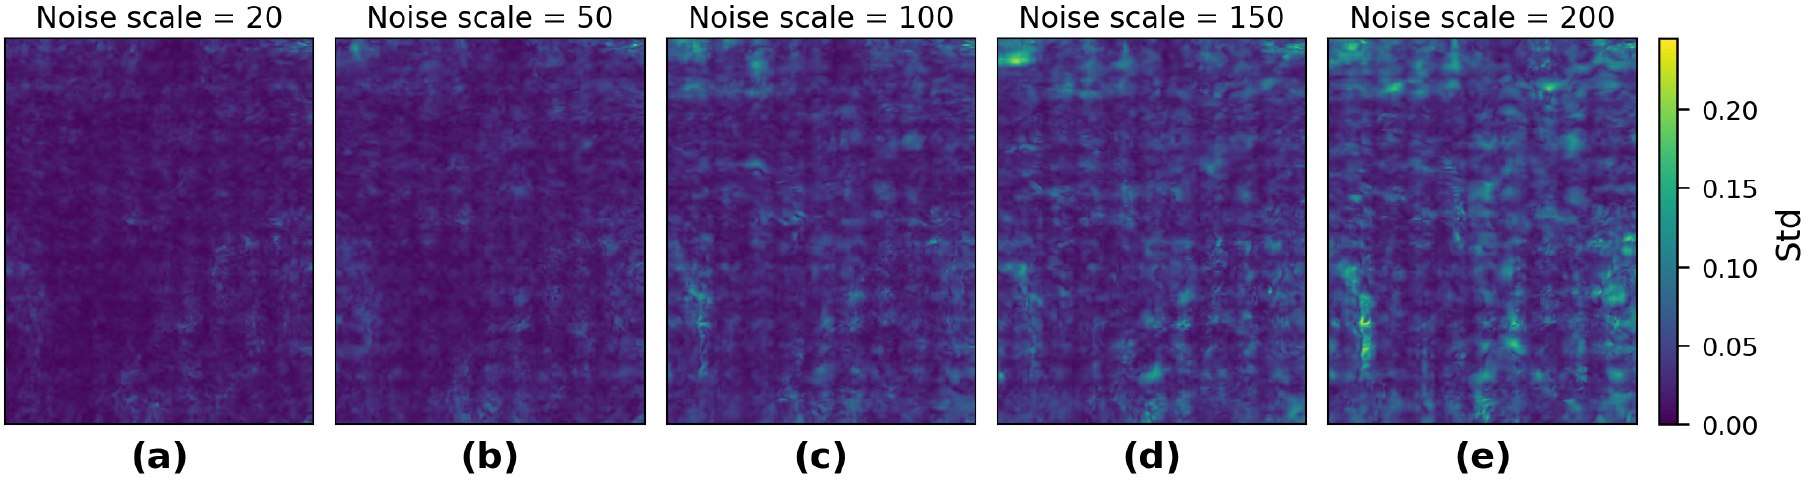
한편 표준편차 분포에는 격자 형태 패턴을 확인할 수 있고, 이는 3차원 확장시 사용한 슬라이딩 윈도우의 이동 간격과 일치한다. 제안 기법은 각 윈도우에 독립적인 잡음 벡터를 적용한 뒤 중첩 영역을 코사인 가중 평균으로 결합하므로, 여러 윈도우가 겹치는 영역에서는 독립적인 결과가 평균되어 표준편차가 감소하고 윈도우 중심부에서는 상대적으로 크게 나타난다.
세 기법의 적용 결과를 종합한 결과는 Fig. 22 및 23, Table 1과 같다. GC-GAN 기법의 입력은 연속된 3차원 입력 체적이고 VQ-VAE 기법 및 GenAI 기법의 입력은 희소한 2차원 측선이므로, 두 행 사이의 비교는 입력 조건이 다르다는 점을 전제로 해석하여야 한다. GC-GAN 기법의 결과는 입력 체적의 경계를 가로질러 반사면의 기하와 진폭 특성을 원본과 거의 같은 수준으로 재현하며, 경계에서의 불연속이나 진폭 변화가 관찰되지 않는다. 입력 체적이 확장 대상 영역과 탄성파 특성을 직접 공유하고 참조 측선이 동일 체적에서 추출되었기 때문이다. VQ-VAE 기법의 결과는 상부의 수평에 가까운 층서 골격을 유지하지만, 측선 위치에서만 진폭이 유지되고 측선 사이 영역에서는 반사면이 수평 방향으로 번지며 진폭이 감쇠하여 수직 줄무늬 형태가 나타난다. GenAI 기법의 결과는 같은 입력으로부터 거시적인 층서 구조를 원본과 유사하게 회복한다. 특히 입력 자료의 측선 간격이 4.0 km에서 6.0 km로 넓어질 때 VQ-VAE 기법의 결과는 층서 구조를 제대로 회복하지 못하는 반면 GenAI 기법의 결과는 층서 골격과 반사면의 연속성을 유지하므로, GenAI 기법이 넓은 측선 간격에서 실질적인 적용 범위를 확장함을 확인할 수 있다. 이는 다양한 잠재공간을 생성하고 코드북과 디코더가 이를 학습된 반사면 패턴의 범위 안으로 되돌리는 본 기법의 구조가 넓은 측선 간격에서도 지질학적으로 타당한 구조를 유지함을 보여 준다.
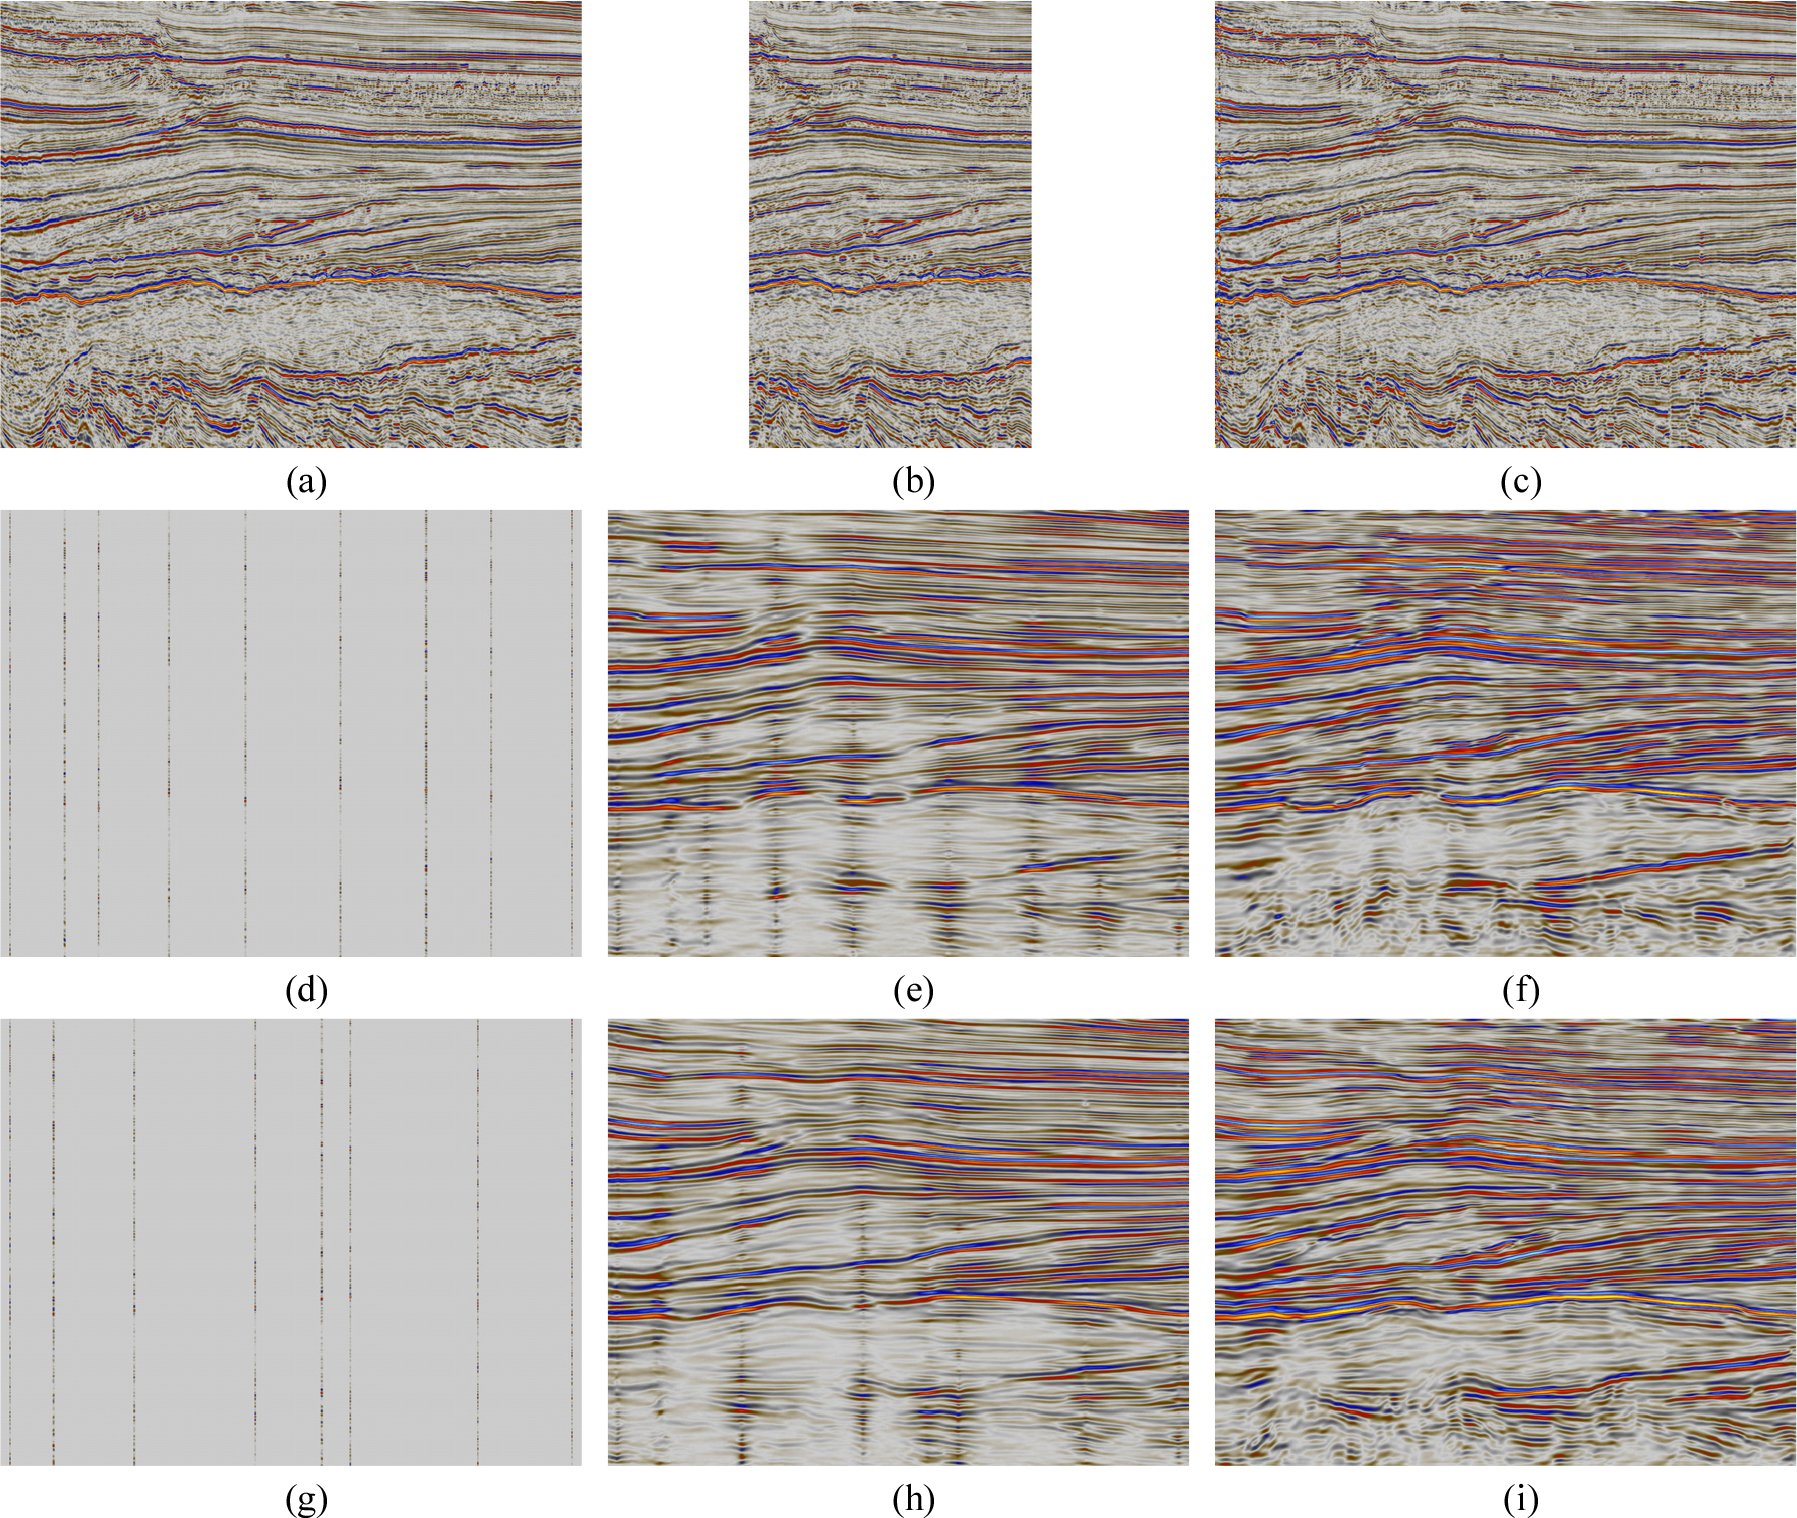
Fig. 22.
Summary of results from applying the three methods. (a) 2D section of the ground-truth volume. (b) 2D section of the input volume for the GC-GAN method. (c) 2D section of the result extrapolated using the GC-GAN method. (d) Sparse input volume with 4 km spacing. (e) 2D section of the result reconstructed using the VQ-VAE method. (f) 2D section of the result reconstructed using the GenAI method. (g) Sparse input volume with 6 km spacing. (h) 2D section of the result reconstructed using the VQ-VAE method. (i) 2D section of the result reconstructed using the GenAI method.
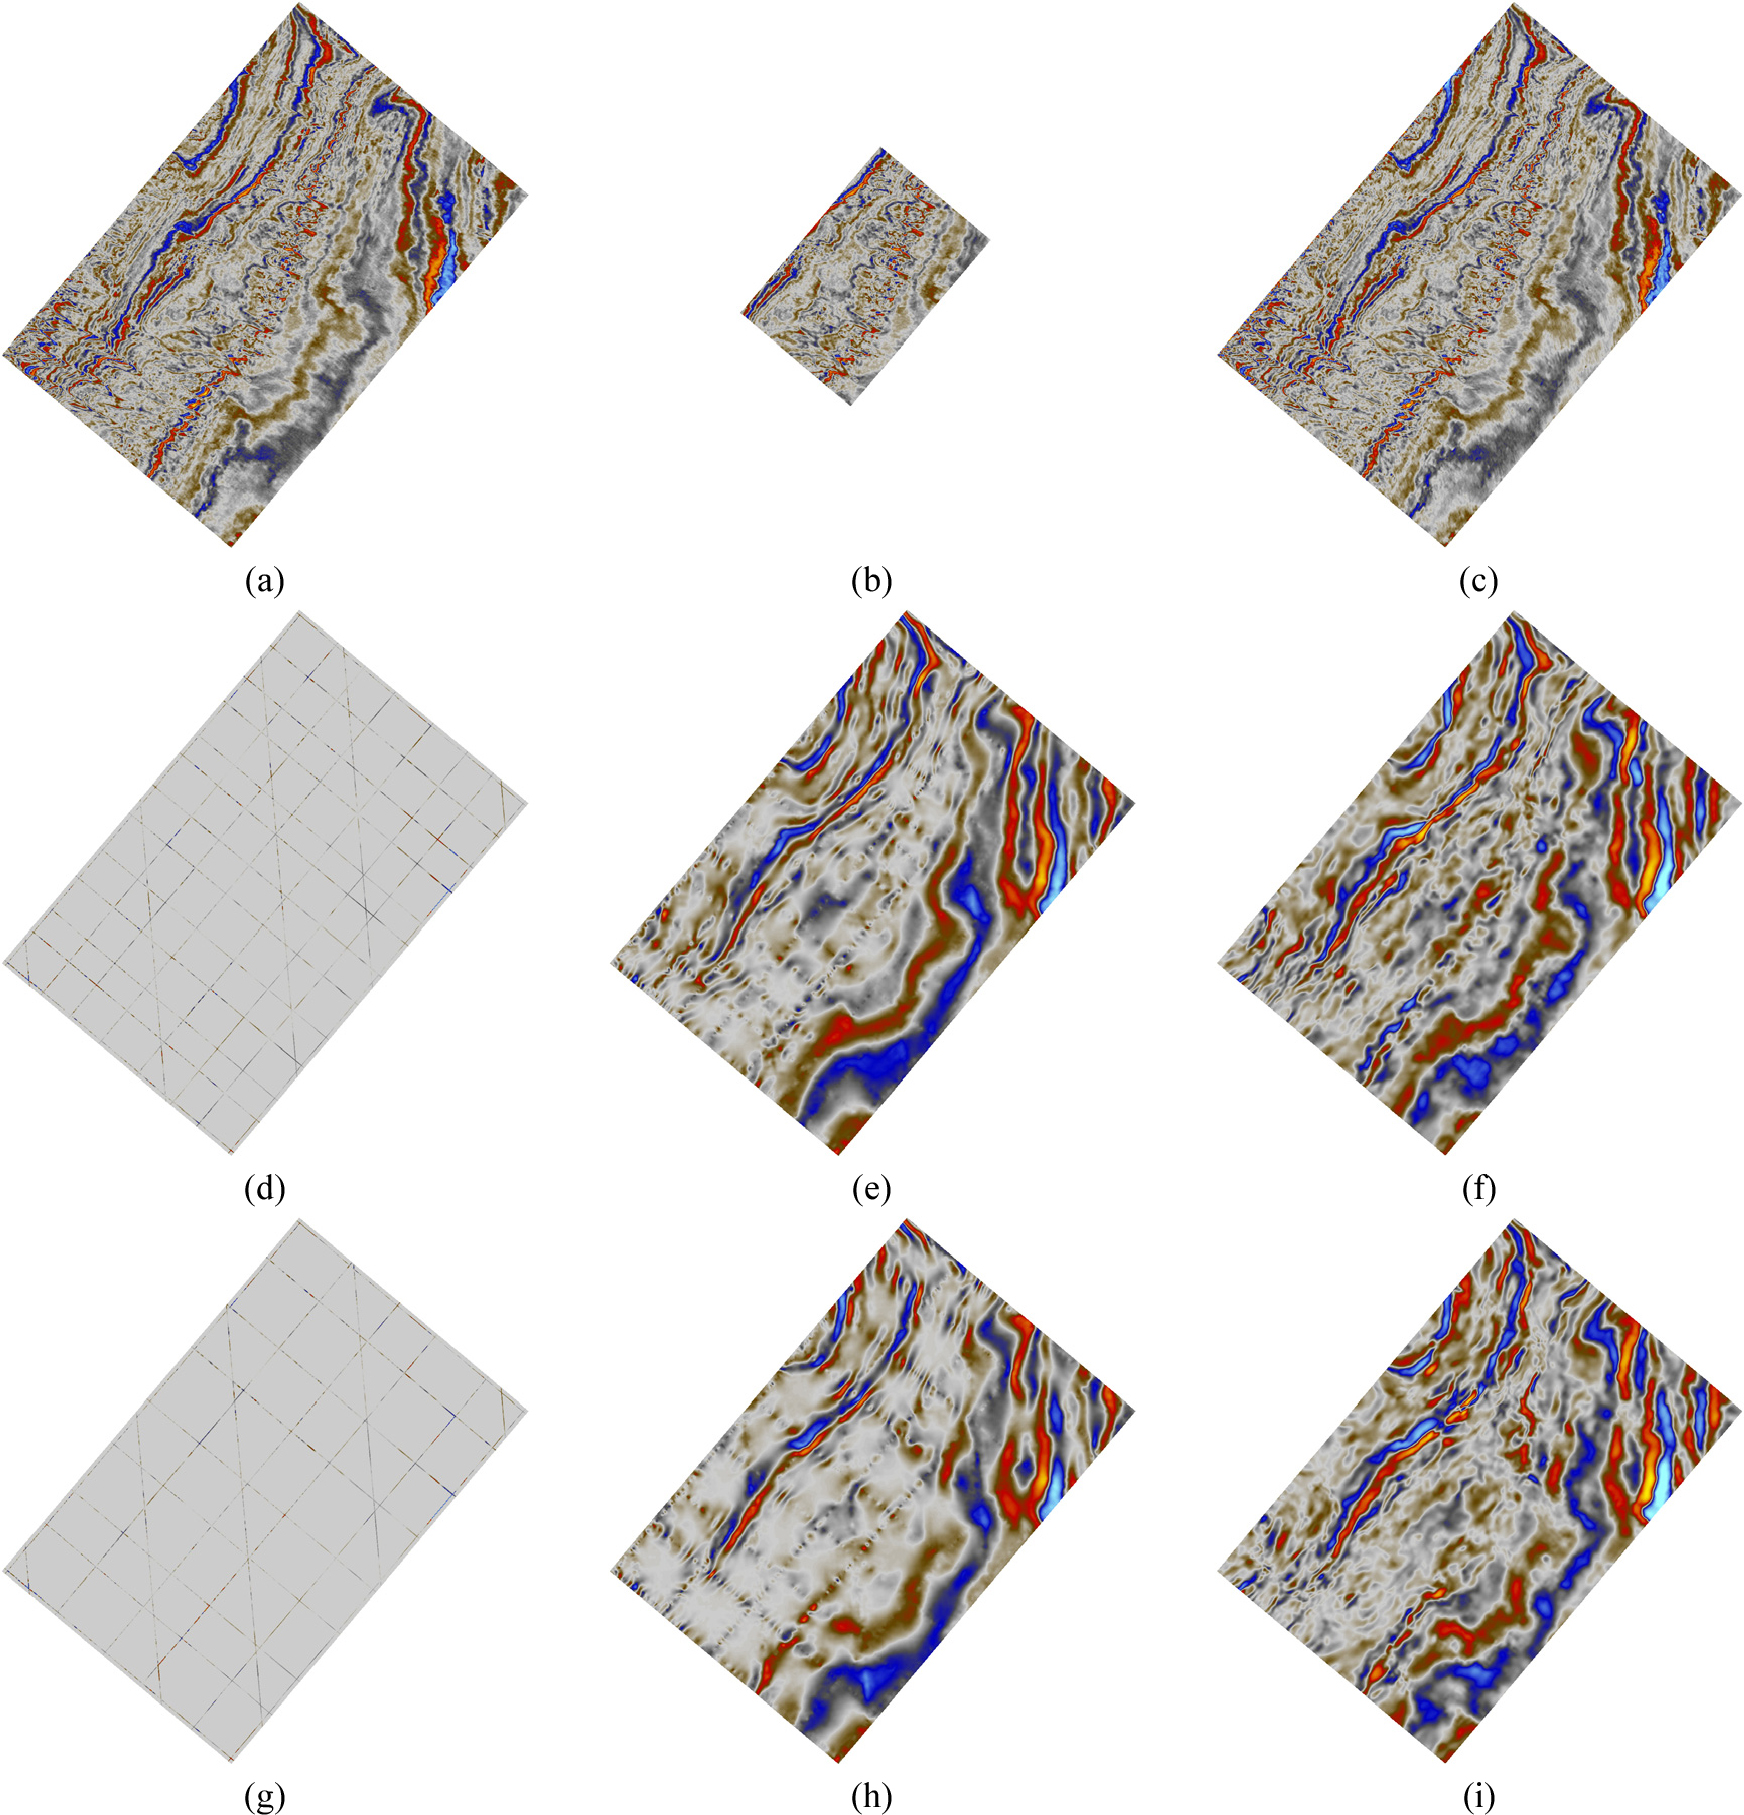
Fig. 23.
Summary of results from applying the three methods. (a) Time slice of the ground-truth volume. (b) Time slice of the input volume for the GC-GAN method. (c) Time slice of the result extrapolated using the GC-GAN method. (d) Sparse input volume with 4 km spacing. (e) Time slice of the result reconstructed using the VQ-VAE method. (f) Time slice of the result reconstructed using the GenAI method. (g) Sparse input volume with 6 km spacing. (h) Time slice of the result reconstructed using the VQ-VAE method. (i) Time slice of the result reconstructed using the GenAI method.
Table 1.
Comparison of the three dimensional expansion methods
세 기법은 서로 다른 자료 조건을 겨냥하도록 발전해 왔으며, 실무에서는 상호 보완적으로 운용할 수 있다. 3차원 체적이 확보된 구역에서는 GC-GAN 기법으로 탐사 범위를 주변 측선까지 넓히고, 3차원 자료가 없는 광역에서는 VQ-VAE 기법으로 층서 골격을 신속히 확보한 뒤, 측선이 성긴 구간에는 GenAI 기법으로 구조 시나리오와 불확실도 분포를 산출하는 방식이다. GC-GAN 기법은 기존 3차원 체적을 필요로 하는 대신 입력 체적의 특성을 외삽 영역에 가장 충실하게 전달하므로, 3차원 탐사 구역 주변에 2차원 측선이 분포하는 경우 탐사 범위를 확장하는 용도에 적합하다. 다만 입력 체적과 참조 측선의 특성 차이에 민감하므로 진폭 정규화, 미스타이 보정, 필터 증강 학습과 같은 보완 조치가 전제되어야 한다.
VQ-VAE 기법은 3차원 체적 없이 측선만으로 체적을 추정하며, 이산 잠재공간이 국소적 특성보다 구조적 의존성을 우선하므로 측선 간 미스타이에 상대적으로 강건하다. 본 예제에서 확인한 바와 같이 측선 간격이 약 2 km 이내인 경우에는 층서와 주요 구조를 안정적으로 추정하지만, 4 km를 넘어서면 측선 사이의 진폭이 소멸한다. 따라서 넓은 간격의 측선에 대한 VQ-VAE 기법의 결과는 주요 반사면의 대략적인 위치를 제시하는 광역 개관 수준으로 활용하여야 한다.
GenAI 기법은 VQ-VAE 기법과 동일한 입력으로 측선 간격이 넓은 조건에서도 지질학적으로 타당한 구조를 생성하며, 복수의 생성 결과로부터 구조적 불확실성을 정량화할 수 있다는 점에서 추가 탐사 계획 수립과 시추 위치 선정과 같은 의사결정에 직접 활용될 수 있다.
결 론
본 연구에서는 2차원 탄성파 측선 자료를 3차원 체적으로 확장하는 세 가지의 기계학습 기반 차원확장 기법을 정리하고, 동일한 3차원 탄성파 탐사 자료에 세 기법을 적용한 예제를 통해 추정 결과를 비교하였다. GC-GAN 기법은 게이트 합성곱과 적대적 학습을 결합하여 입력 체적을 외부 측선 방향으로 점진적으로 외삽하며, VQ-VAE 기법은 VQ-VAE의 이산 잠재공간을 이용하여 3차원 체적 없이 측선만으로 체적을 추정한다. GenAI 기법은 VQ-VAE 기법에 생성형 인공신경망 기반의 스타일 변조와 적대적 학습을 수행하여 동일한 입력으로부터 복수의 타당한 구조를 생성한다.
GC-GAN 기법은 입력 체적의 반사면 기하와 고주파 특성을 외삽 영역까지 매우 성공적으로 재현하였으나, 초기 3차원 체적을 요구한다는 제약조건을 확인하였다. VQ-VAE 기법은 측선 간격 2 km 이내에서 층서와 주요 구조를 안정적으로 추정하였으나, 4 km 이상의 간격에서는 복셀 단위 손실의 평균화 특성으로 인해 측선 사이 영역의 진폭이 소멸하였다. GenAI 기법은 같은 조건에서 반사면의 연속성과 진폭 수준을 보다 넓은 입력 자료의 간격까지 유지하였으며, 생성 결과 간의 편차를 통해 불확실성 분석의 가능성을 제시했다.
세 기법의 발전은 요구 입력의 완화, 미스타이에 대한 강건성 확보, 비유일성의 명시적 표현이라는 방향을 거쳐왔다. 이는 일부 자료만 존재하는 광역 구조에서 3차원 구조 해석을 가능하게 하는 실무적 경로를 제공한다. 특히 GenAI 기법이 산출하는 생성 결과의 표준편차는 구조가 복잡하여 여러 타당한 배치가 공존하는 영역을 상대적으로 식별할 수 있게 하므로, 추정 체적은 예비 구조 해석과 후속 탐사의 범위 및 우선순위 결정에 직접 활용될 수 있다. 실무 적용 시에는 보유 자료의 형태와 측선 간격, 해석 목적에 따라 기법을 선택하고, 측선 간 진폭 정규화와 미스타이 보정, 복수 생성 결과의 통계적 검토를 병행하면 결과의 신뢰도를 한층 향상할 수 있다.
향후 다양한 지질 환경의 체적을 학습 자료에 포함하여 코드북의 표현 범위를 넓히고, 확산 모형(Diffusion model)과 같은 향상된 생성 모형을 잠재공간 결합 구조에 적용하여 넓은 측선 간격에서의 성능을 개선할 수 있다는 점을 과제로 들 수 있다. 본 연구는 이러한 향후 과제 달성과 함께, 수십 년간 축적된 2차원 탐사 자료를 3차원 해석 체계 안에서 활용하여 지질학적 해석을 수행할 수 있는 실무적 기여를 제시한다.